x <- 10L
if ( is.integer(x) ) {
  print(
    "Yes, x is an integer!")
}
[1] "Yes, x is an integer!"if ( is.double(x) ) {
print(
"Yes, x is a double!")
}
DS3 - Vom experimentellen Design zur
explorativen Datenanalyse & Data Mining
Universität Hamburg, IMF
Wintersemester

Grafik von Nina Garman (Pixabay)
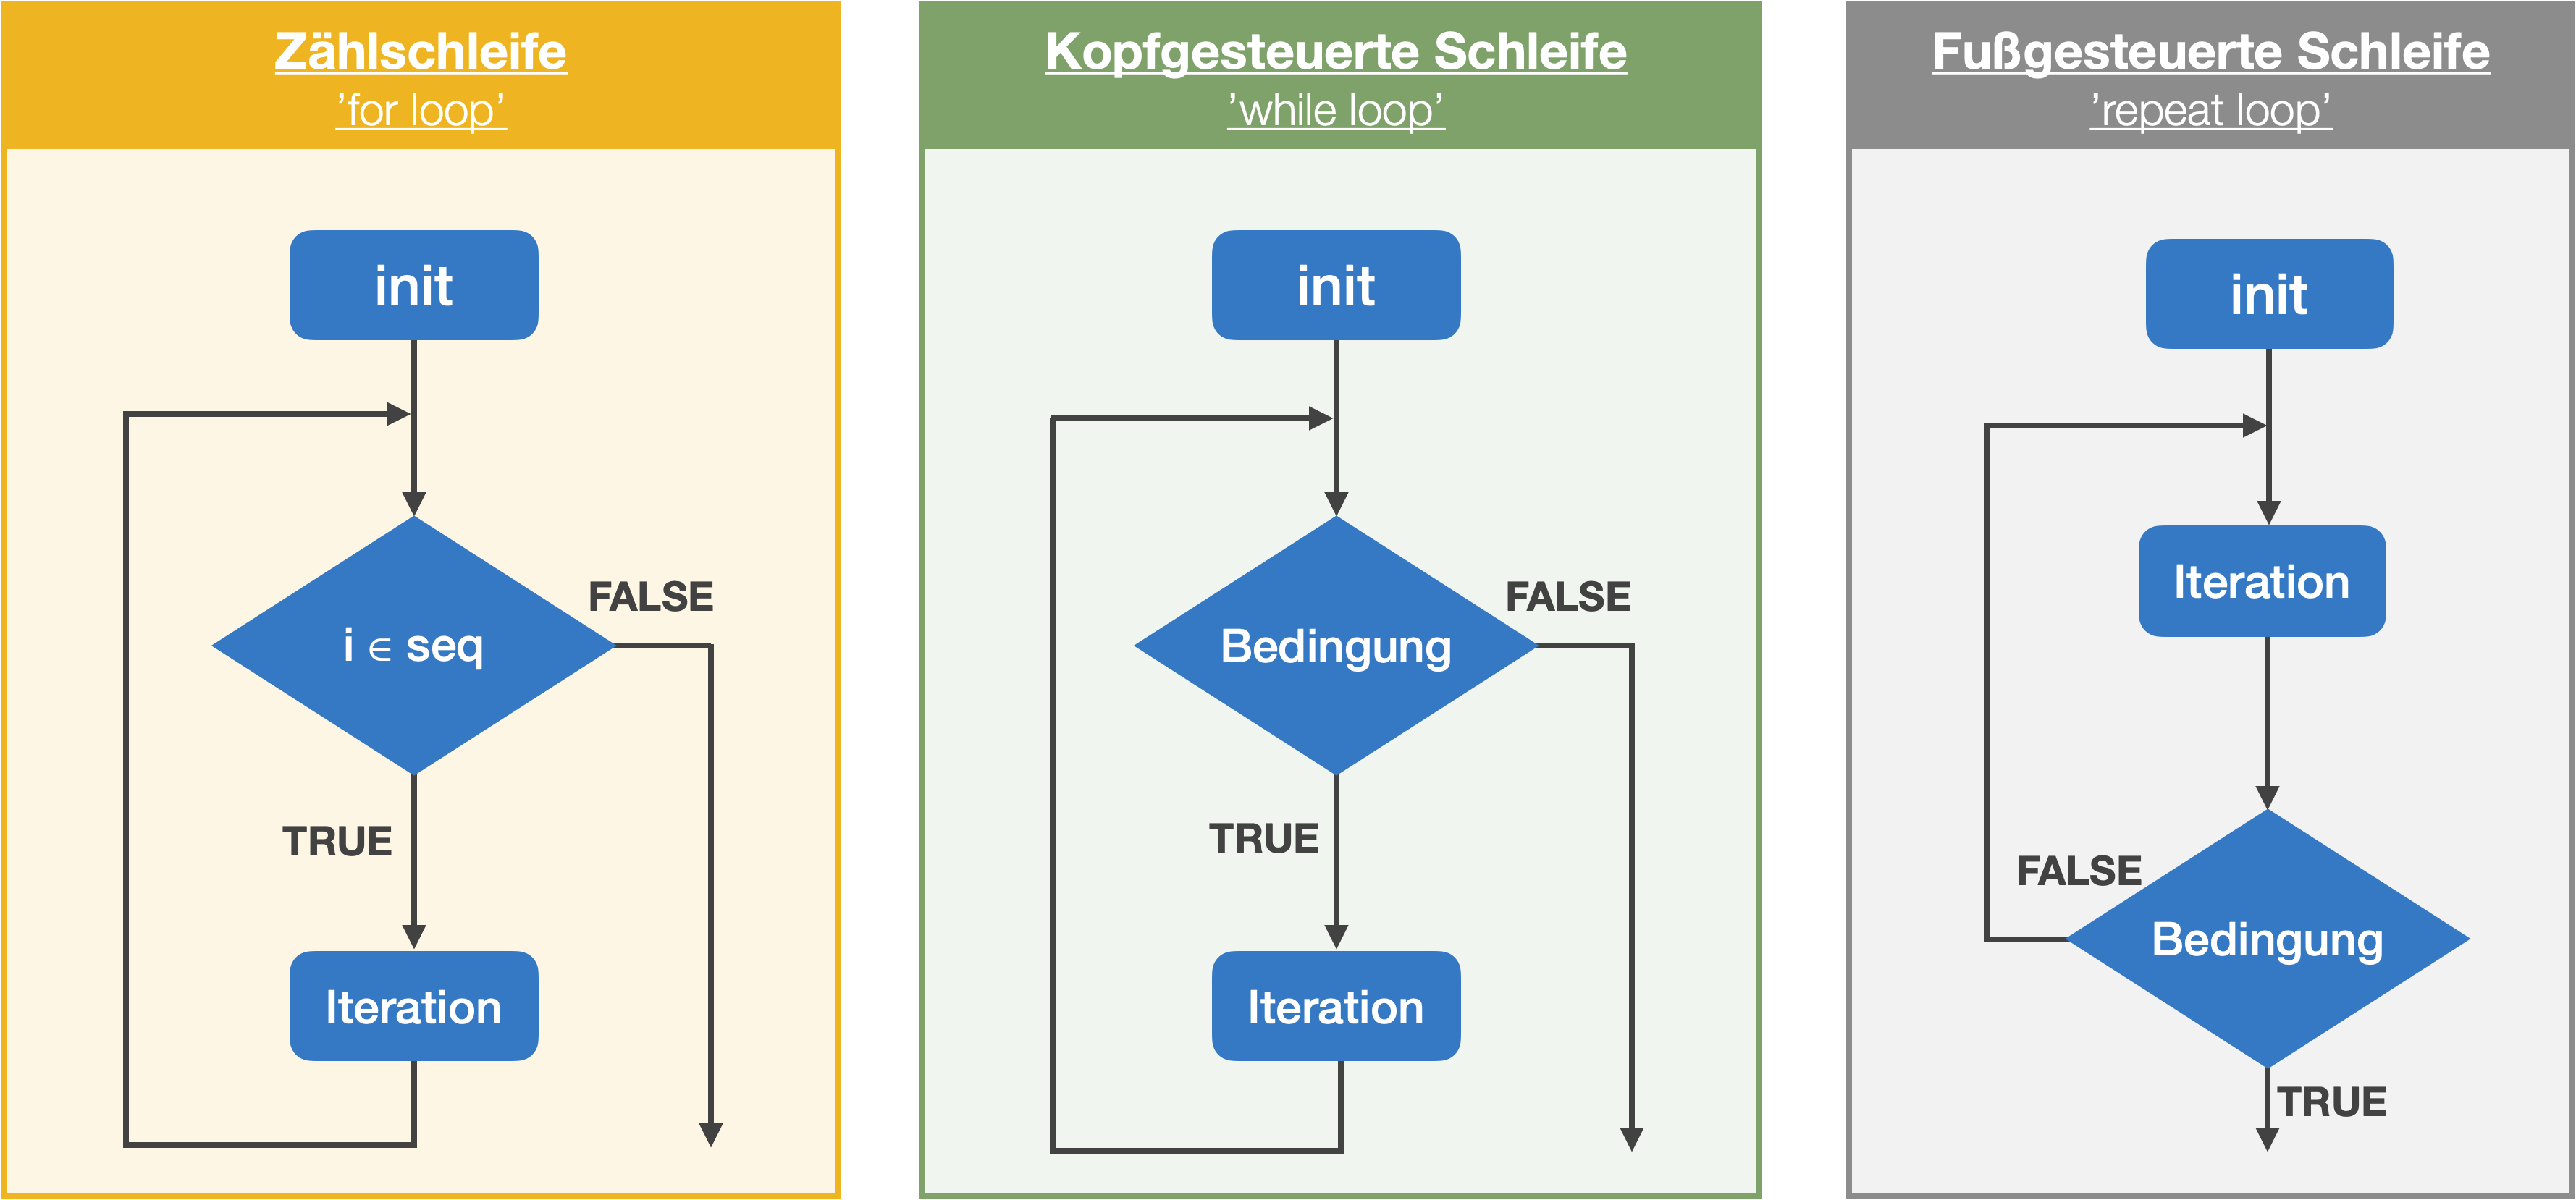
ifelse()for): führen eine bestimmte Anzahl an Wiederholungen aus, die durch einen Zähler oder einen Index kontrolliert wird. Dieser erhöht sich mit jeder Iteration.while) vs. fußgesteuerte/nachprüfende Schleifen (repeat): basieren auf ein Einsetzen und einer Verifikation durch eine logische Bedingung. Die Bedingung wird zu Beginn oder zum Ende des Schleifenkonstrukts getestet.for Schleife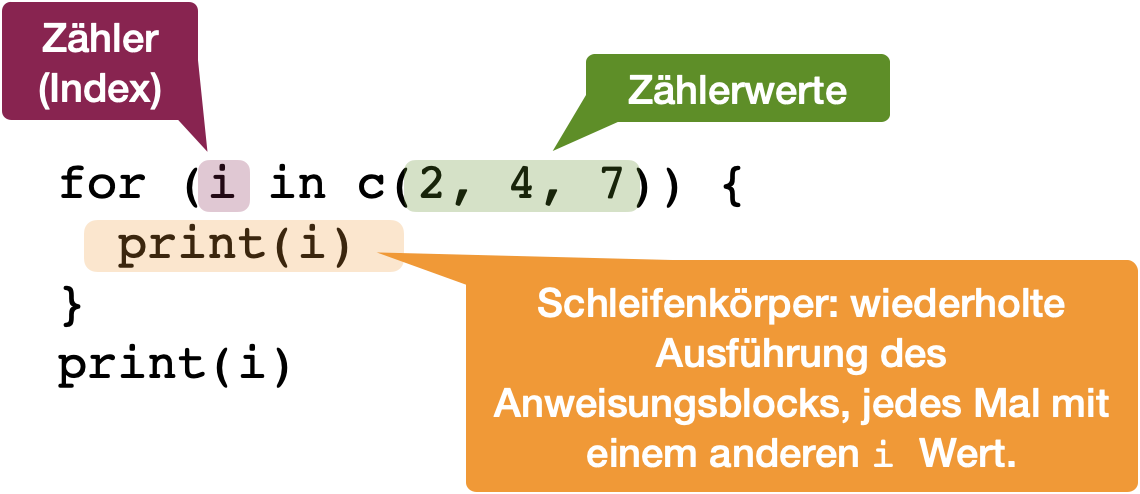
for Schleife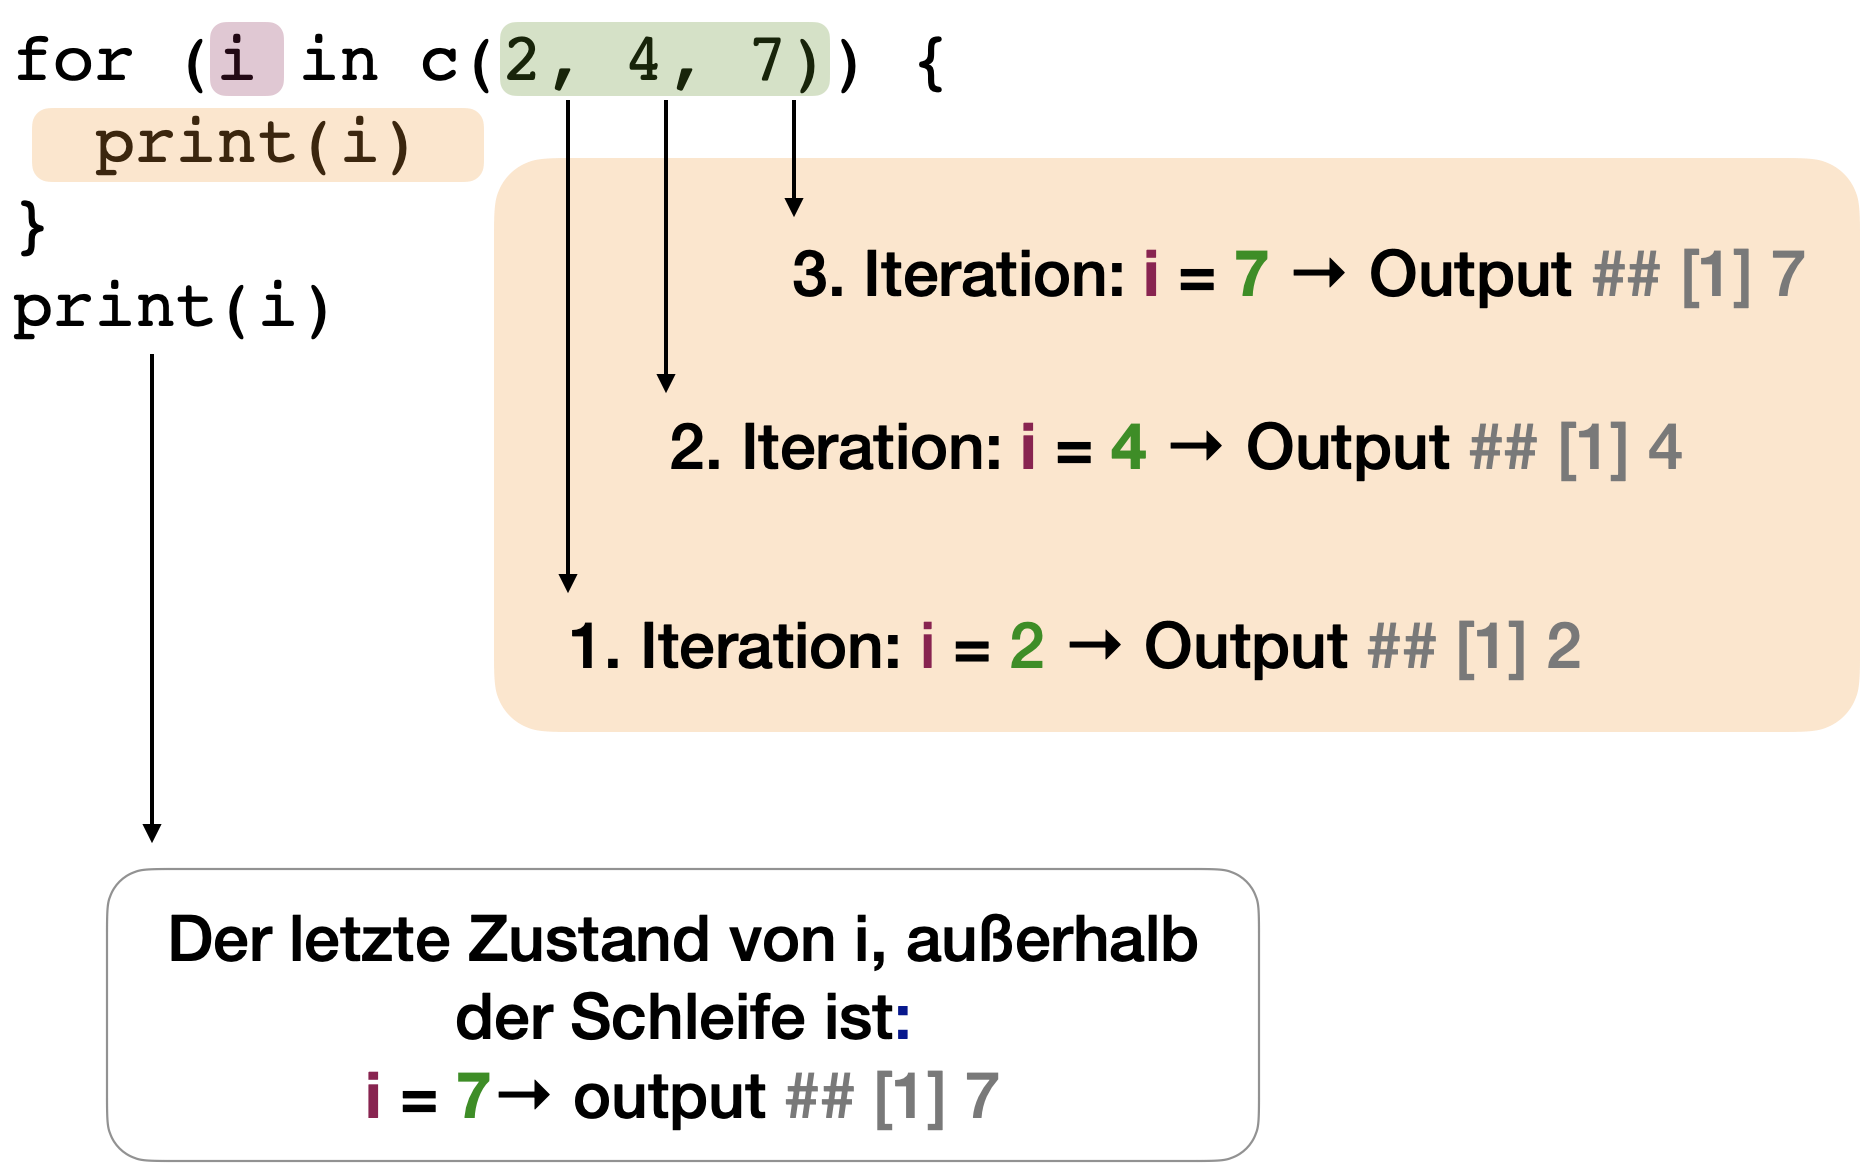
for Schleife - Stile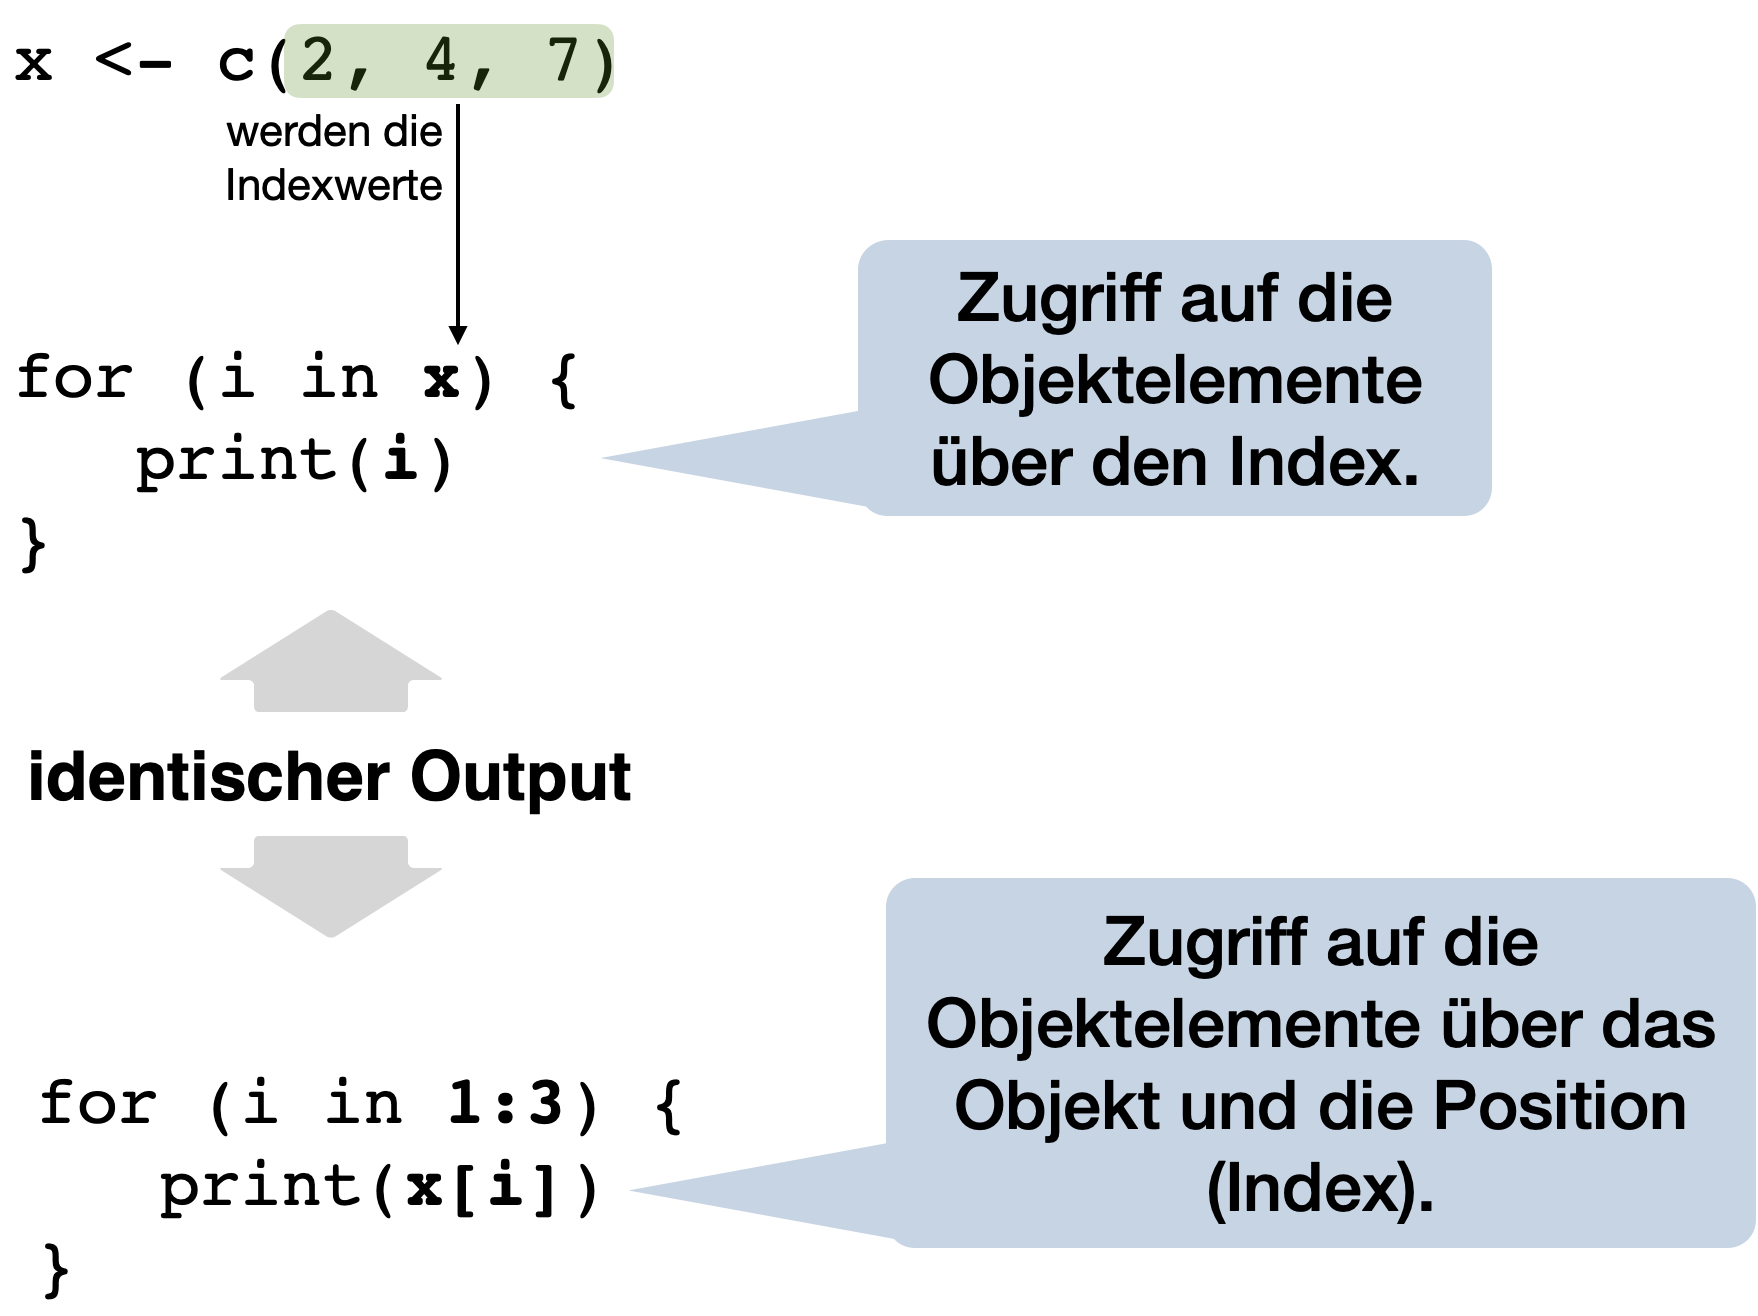
Testen wir die Geschwindigkeit der beiden Funktionen
Unit: milliseconds
            expr       min        lq       mean    median        uq       max
   grow_obj(500)  0.229026  0.237103  0.2458032  0.243294  0.253052  0.266541
  grow_obj(5000) 28.640837 28.880523 30.4578422 30.028072 31.081567 33.658212
  index_obj(500)  0.061295  0.063468  0.0670842  0.063878  0.065354  0.081426
 index_obj(5000)  0.590113  0.599912  0.9261654  0.601101  0.616066  2.223635
 neval cld
     5  a
     5   b
     5  a
     5  a
In der Spalte mean ist zu sehen, dass die Variante mit der ‘Indexierung’ viel schneller ist als die mit wachsenden Objekten, besonders wenn viele Wiederholungen gemacht werden!


Der Körper einer Bedingung (wie auch Schleife und Funktion) wird immer in geschweifte Klammern gesetzt, damit er über mehrere Zeilen gehen kann.
In der Abfrage muss ein Operator stehen, welcher die Abfrage wahr macht, denn der Codeblock in der Bedingung wird ja ausgeführt. Richtig ist daher:
Anhand der zweimaligen geschweiften Klammern wird deutlich, dass es sich um eine ‘if..else..’ Bedingung handelt.
An der Ausgabe 0 ist zu erkennen, dass der Alternativbefehl (in ‘else’) ausgeführt wurde. In die zweite Lücke muss daher ein Operator, bei der die Abfrage FALSE ergibt:
Anhand der Abfrage ist erkennbar, dass es sich um eine ‘while..’ Schleife handeln muss. Auch hier gilt wieder: der Schleifenblock gehört in geschweifte Klammern!
Und da eine ‘while..’ Schleife nur mehrere Iterationen durchgeht, wenn der Input in der Abfrage sich ändert, muss sich hier a im Schleifenkörper um den Wert erhöhen, den der Output sich erhöht (weil dieser a darstellt.)
Hier ist keine Abfrage jeweils zu sehen, sondern es wird ein Zählerindex definiert. Also muss es sich um die Zählschleife (‘for..’) handeln. Und zwar 2 ineinander verschachtelte. Wichtig ist hierbei, dass der Zähler unterschiedlich ist. Die erste Schleife hat meist den Index i, die nächste j, etc.).
Der innerste Schleifenkörper macht folgendes: es sollen die beiden Indizes zusammengefügt werden (mittels Funktion paste()) unter Verwendung des Trennzeichen ‘/’ . Damit dies auch wirklich in der Konsole sichtbar ist, braucht es aber die Funktion print(), welche als Input paste() enhält.

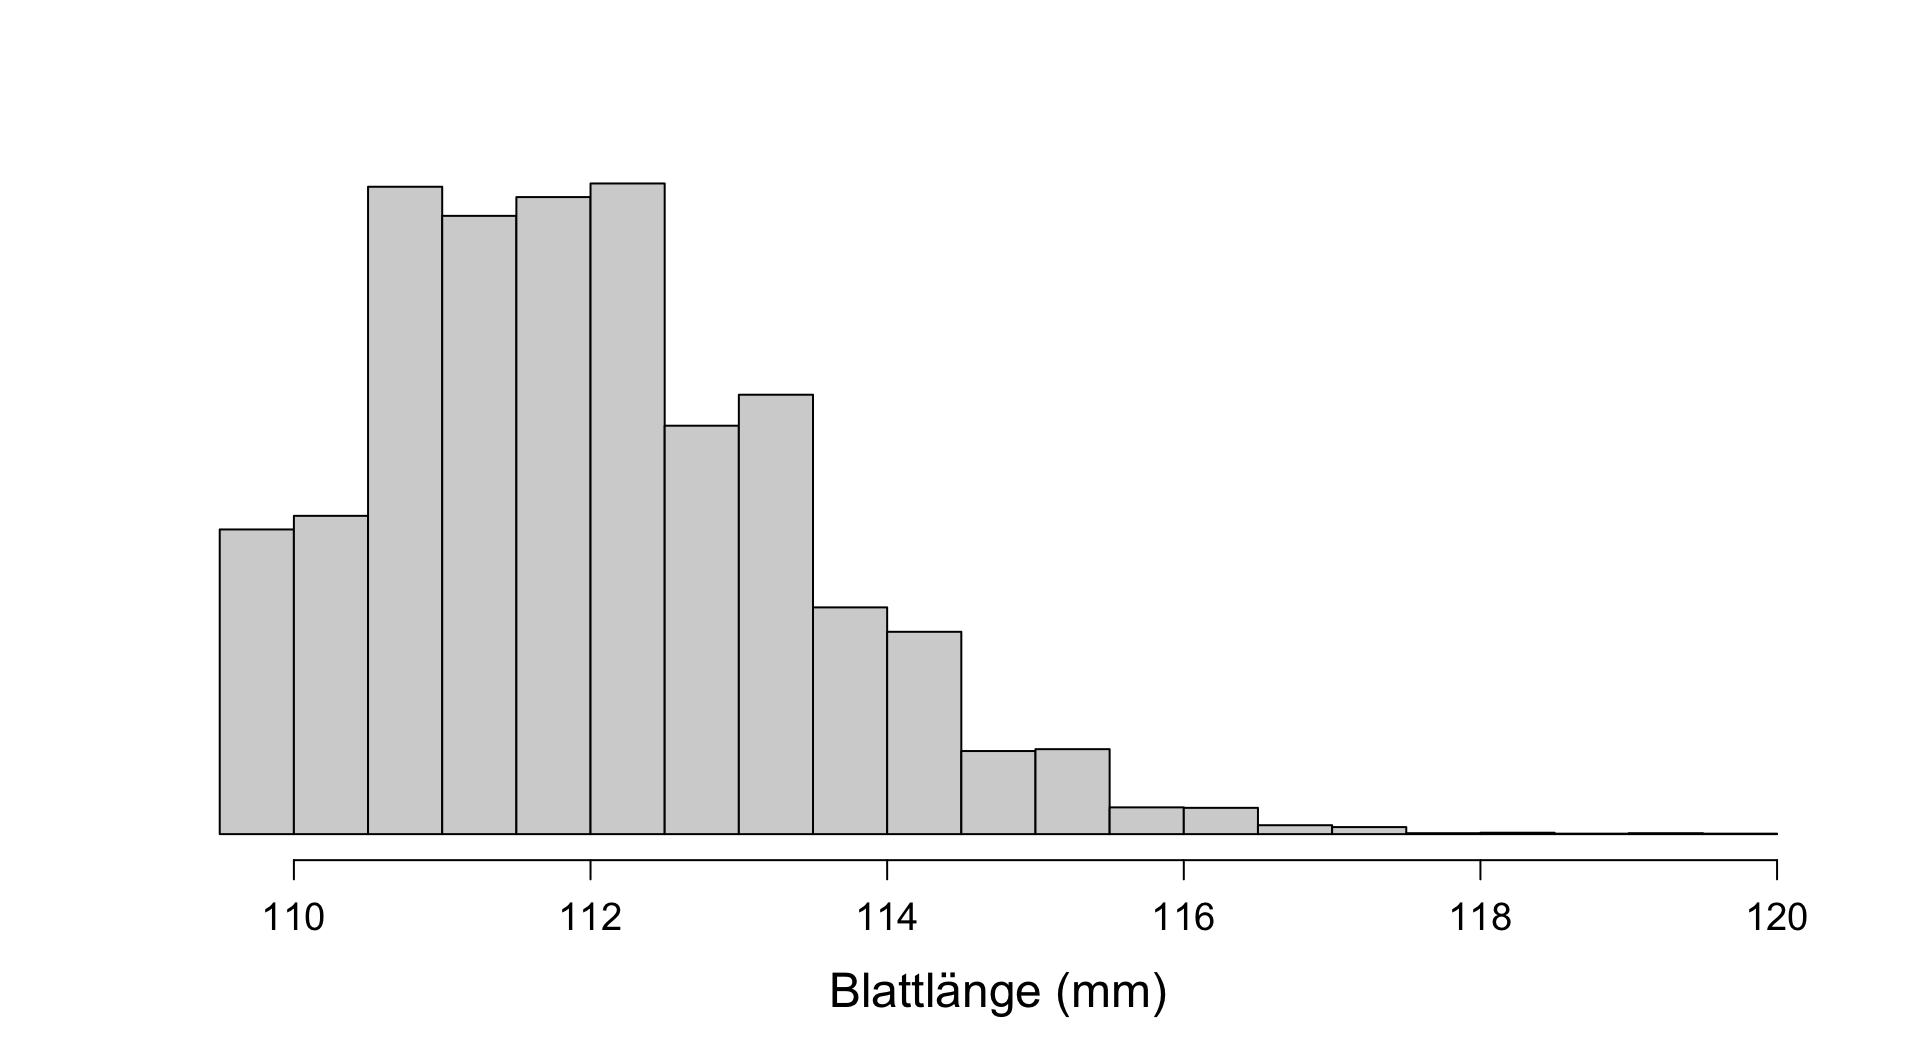
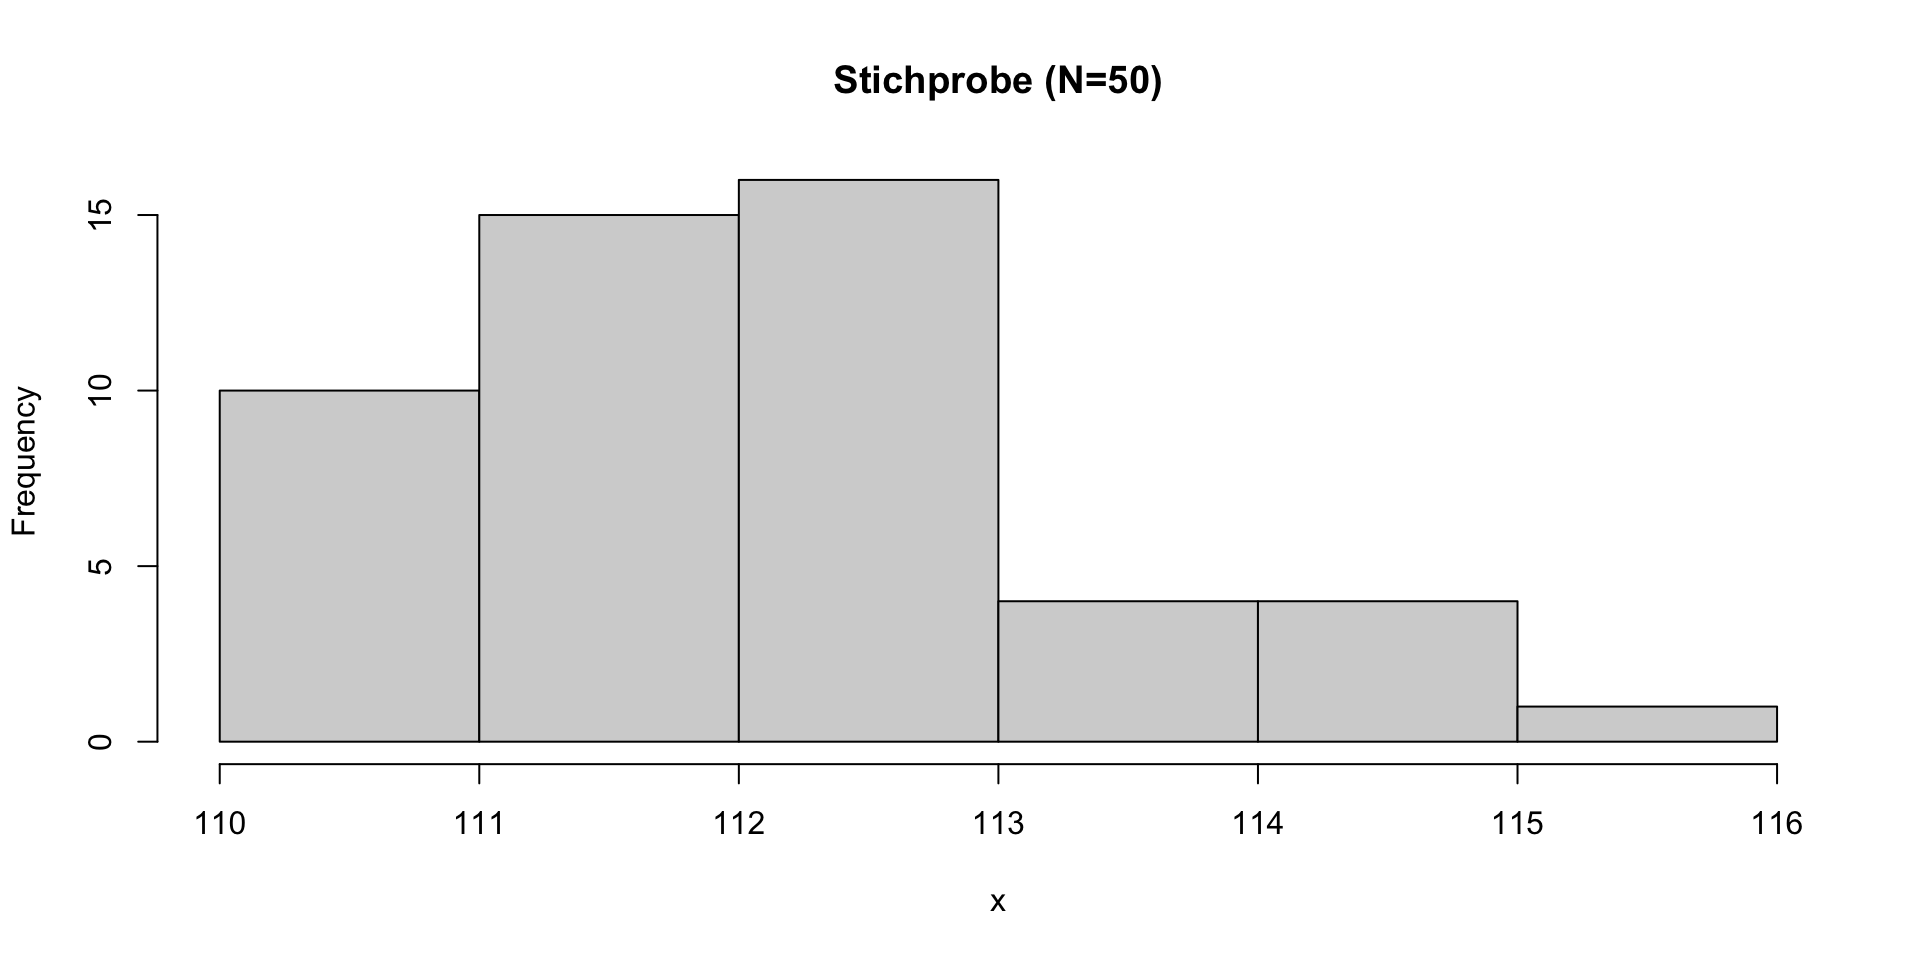
→ Das 95%-Bootstrap-Konfidenzintervall für den Populationsmittelwert reicht von 111.8 bis 112.4.
df$res <- residuals(mod_lm)
df$fit <- fitted(mod_lm)
p1 <- ggplot(df, aes(y)) +
  geom_histogram(bins = 10, fill = "grey50", colour = "grey10") +
  ggtitle("Histogramm von Y")
p2 <- ggplot(df, aes(x, y)) + geom_point() +
  geom_smooth(method = "lm", se = TRUE) +
  ggtitle("Beziehung Y ~ X")
p3 <- ggplot(df, aes(res)) +
  geom_histogram(bins = 10, fill = "grey50", colour = "grey10") +
  ggtitle("Histogramm der Residuen")
p4 <- ggplot(df, aes(fit, res)) + geom_point() +
  geom_hline(yintercept = 0) +
  ggtitle("Residuen vs. fitted")
gridExtra::grid.arrange(p1, p2, p3, p4)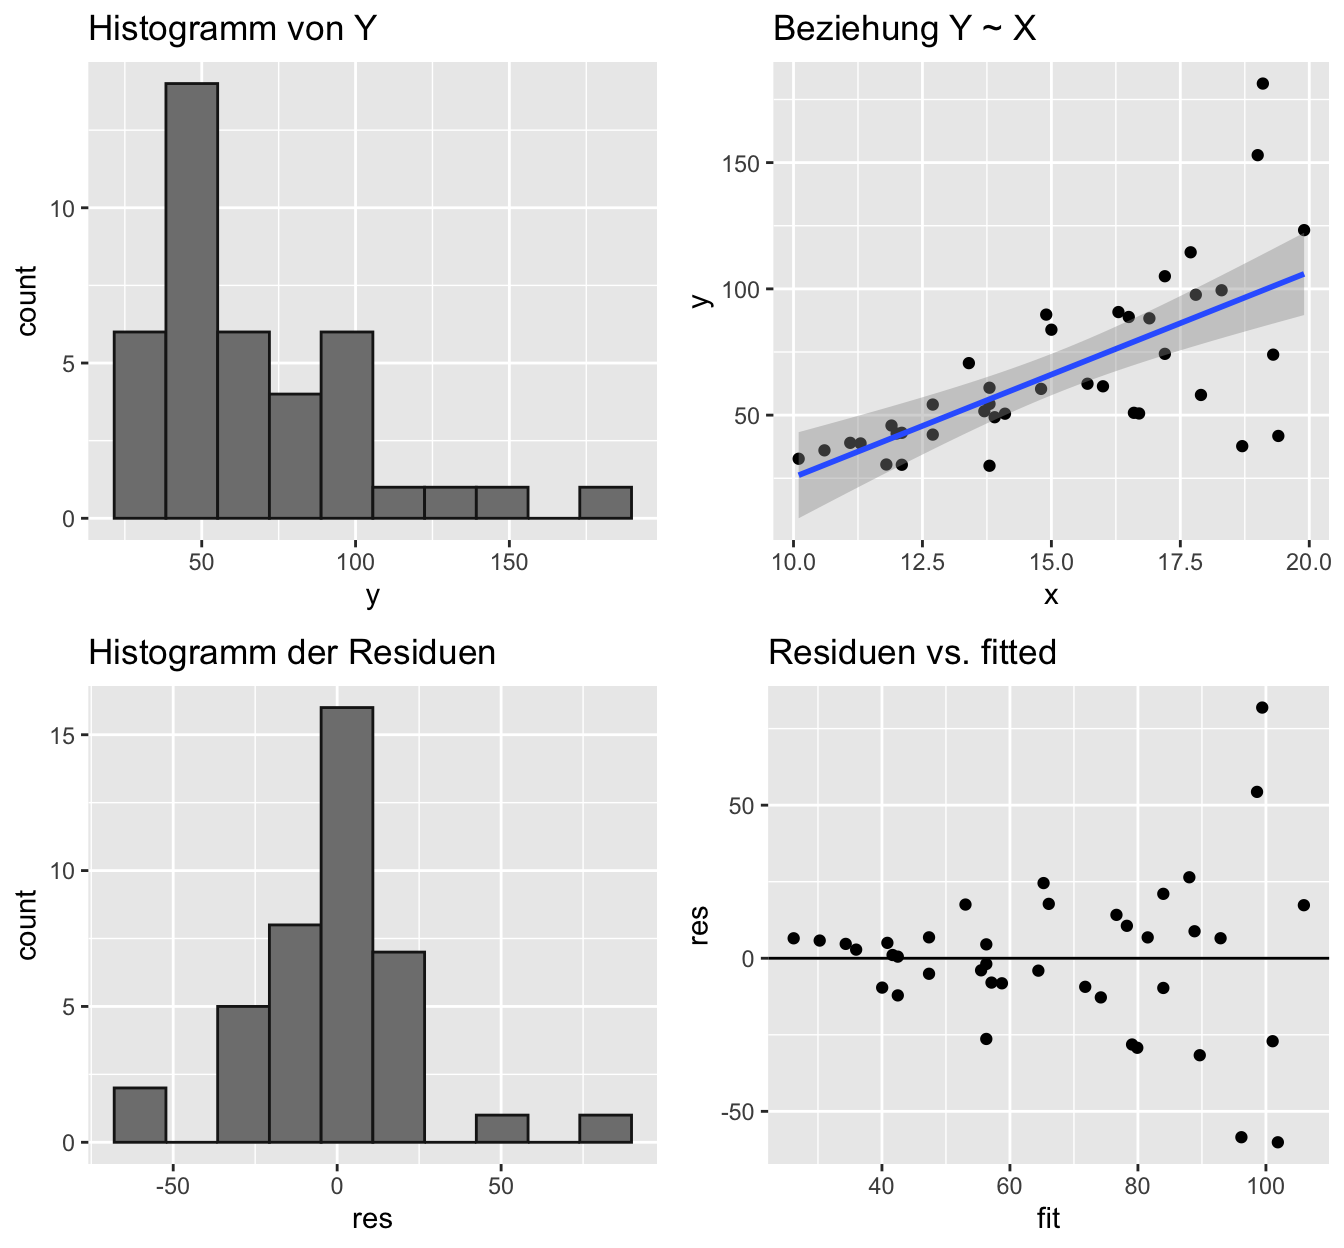
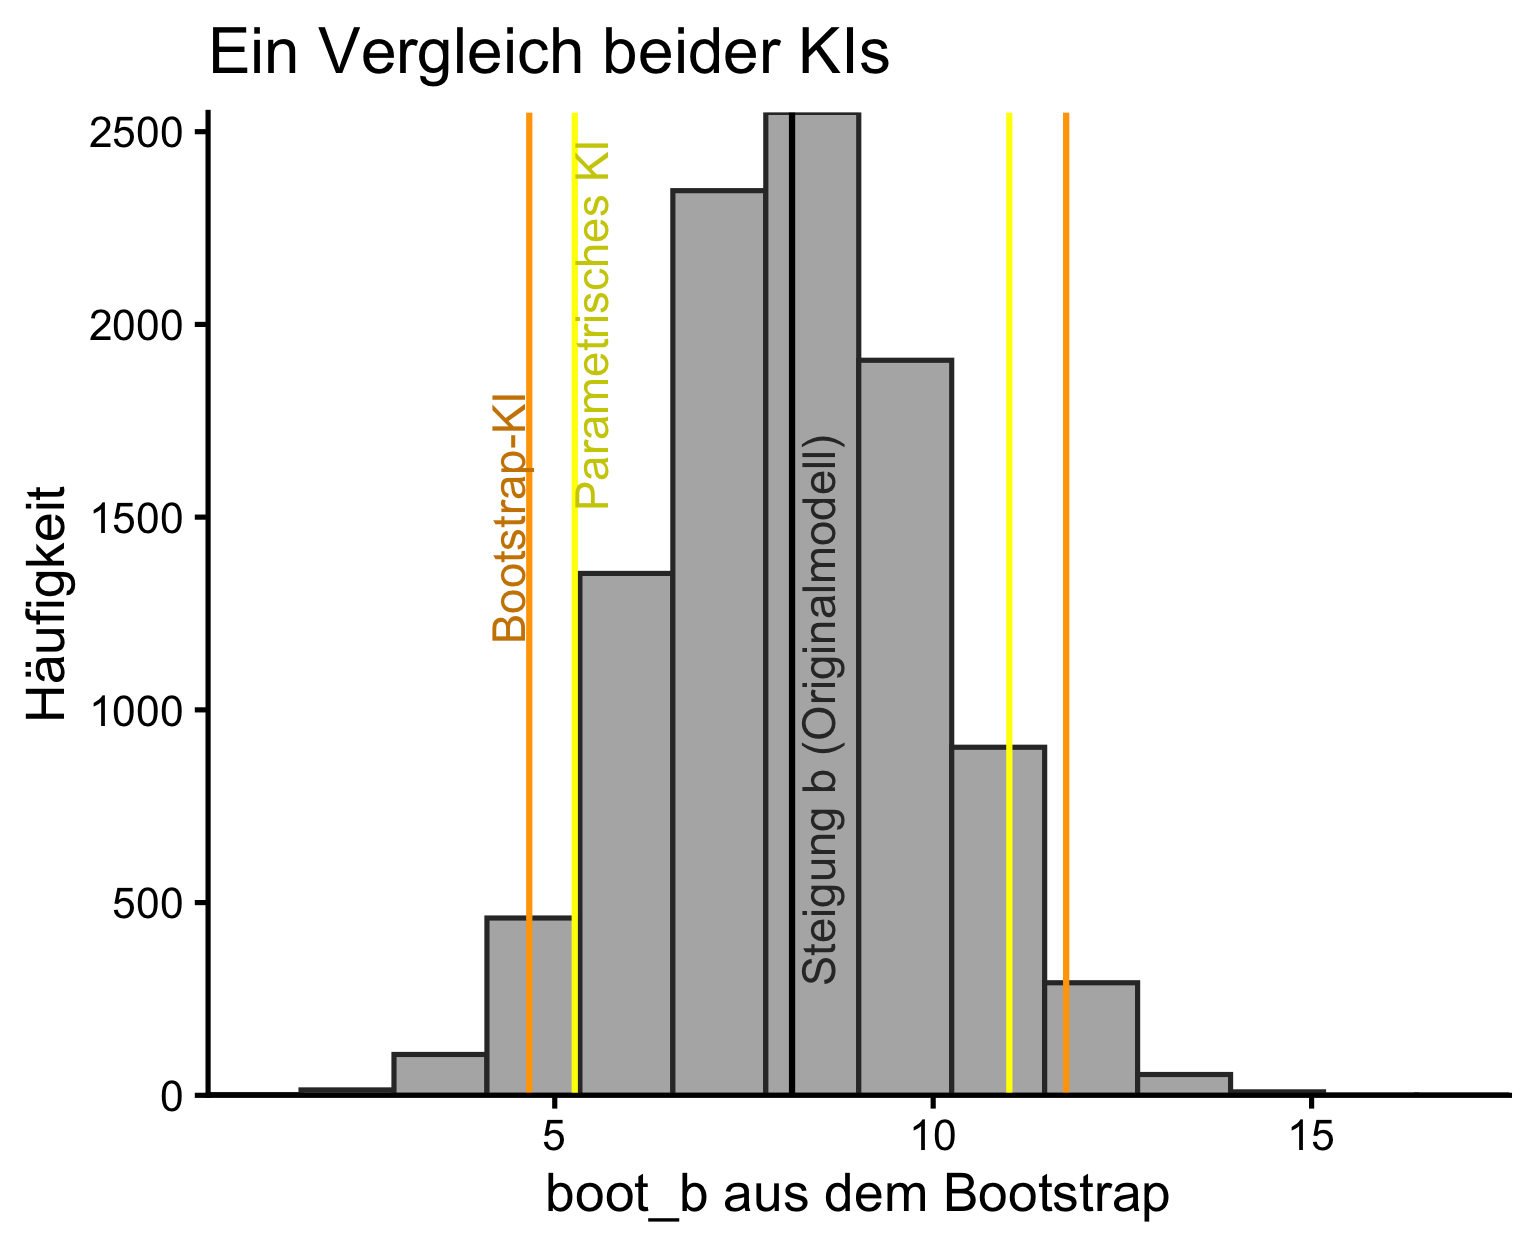
     2.5%     97.5%
 4.663306 11.757071
→ Der Konfidenzbereich liegt nun zwischen 4.7 und 11.8.
Unterscheiden sich zwei Schneckenarten in ihrer Laufgeschwindigkeit (in m/Stunde)?
# A tibble: 2 × 3
  Art   Mittelwert Standardabweichung
  <chr>      <dbl>              <dbl>
1 A           5.33               3.08
2 B           8.33               2.16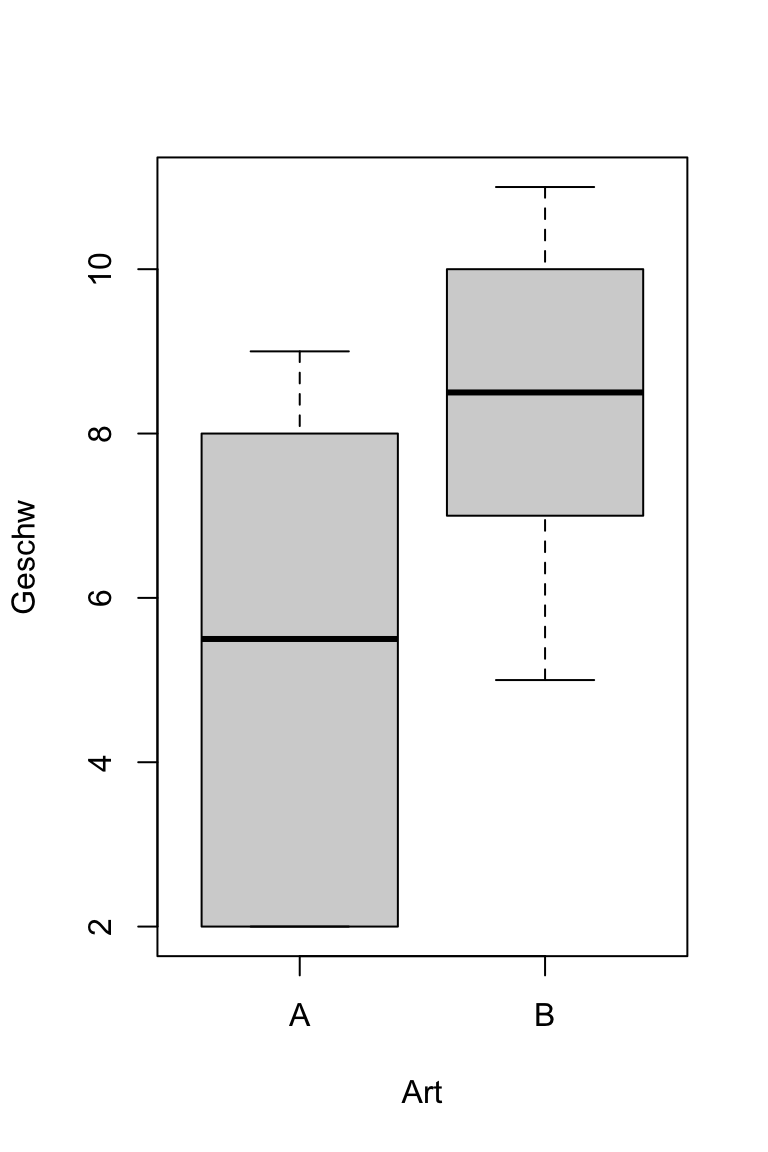
[1] 475[1] 0.0475[1] 940[1] 0.094
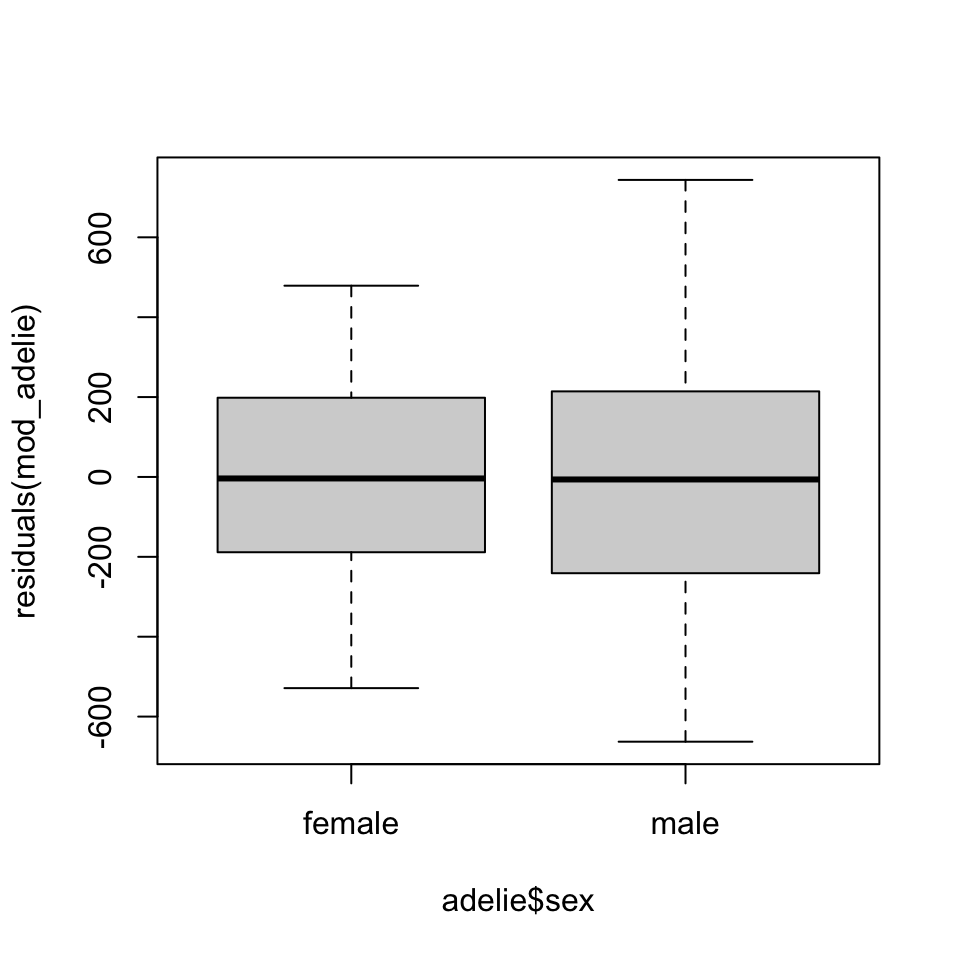
Call:
lm(formula = body_mass_g ~ flipper_length_mm + sex, data = adelie)

Residuals:
    Min      1Q  Median      3Q     Max
-662.85 -213.18   -6.27  207.42  743.73

Coefficients:
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)        305.087    755.580   0.404    0.687
flipper_length_mm   16.314      4.019   4.059 8.08e-05 ***
sexmale            599.343     52.246  11.472  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 295.1 on 143 degrees of freedom
Multiple R-squared:  0.5918,    Adjusted R-squared:  0.5861
F-statistic: 103.6 on 2 and 143 DF,  p-value: < 2.2e-16
Hier gibt es 2 Möglichkeiten der Permutation:
Wir extrahieren zuerst die F-Statistik aus der drop1() Funktion.
Single term deletions

Model:
body_mass_g ~ flipper_length_mm + sex
                  Df Sum of Sq      RSS    AIC F value    Pr(>F)
<none>                         12450275 1663.6
flipper_length_mm  1   1434486 13884760 1677.5  16.476 8.077e-05 ***
sex                1  11457596 23907871 1756.9 131.598 < 2.2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Wir schreiben die Schleife
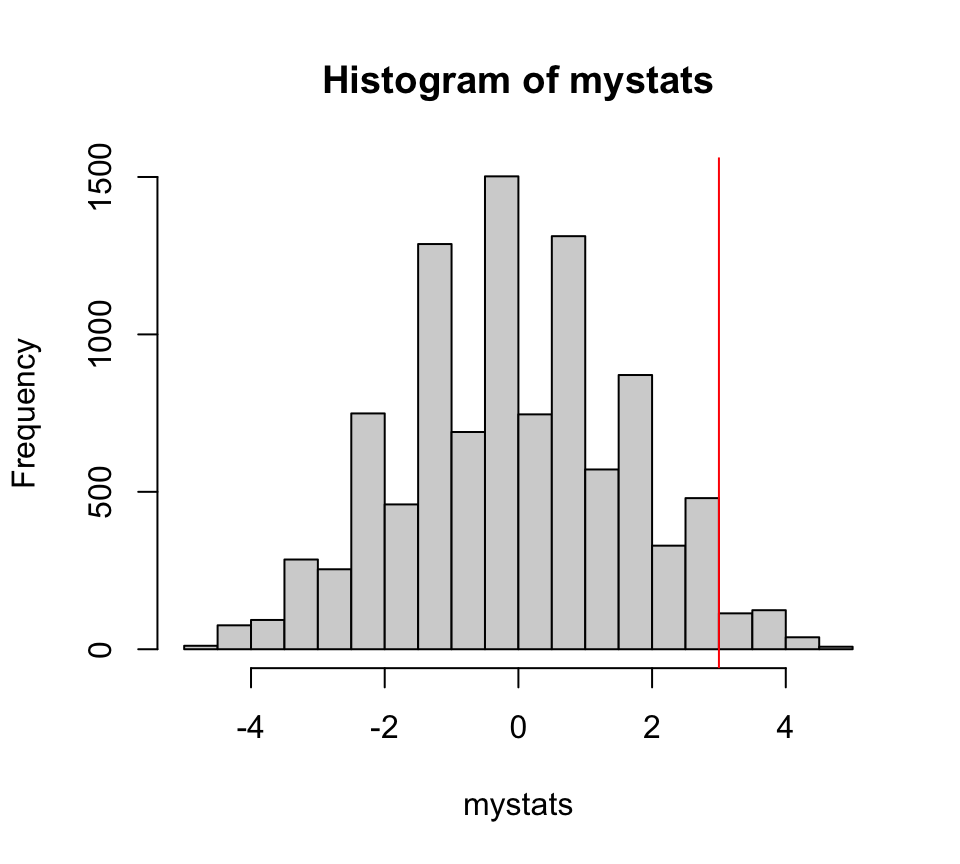
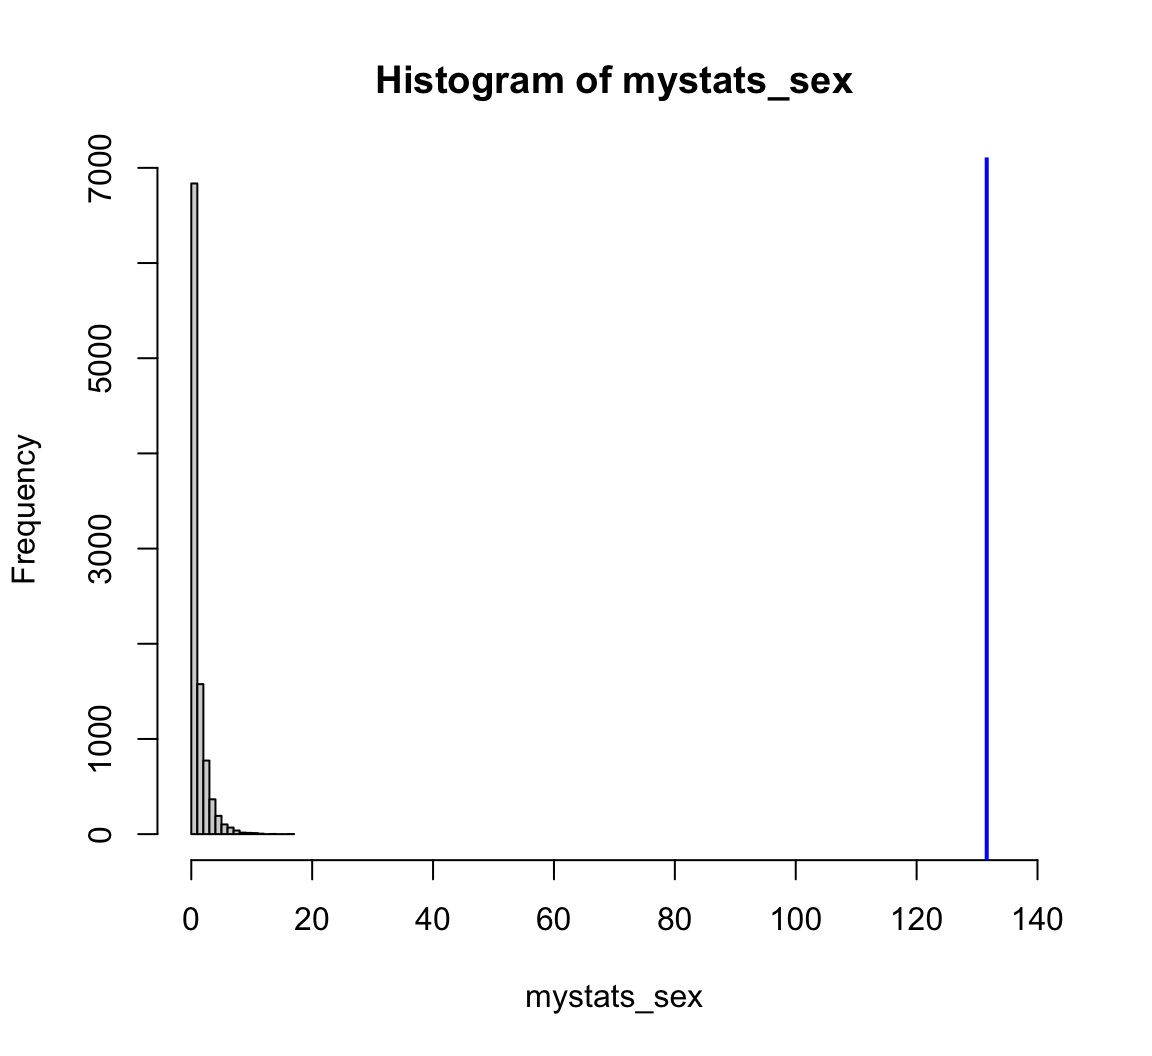
Verteilung der Teststatistik
[1] 0[1] 0INTERPRETATION:
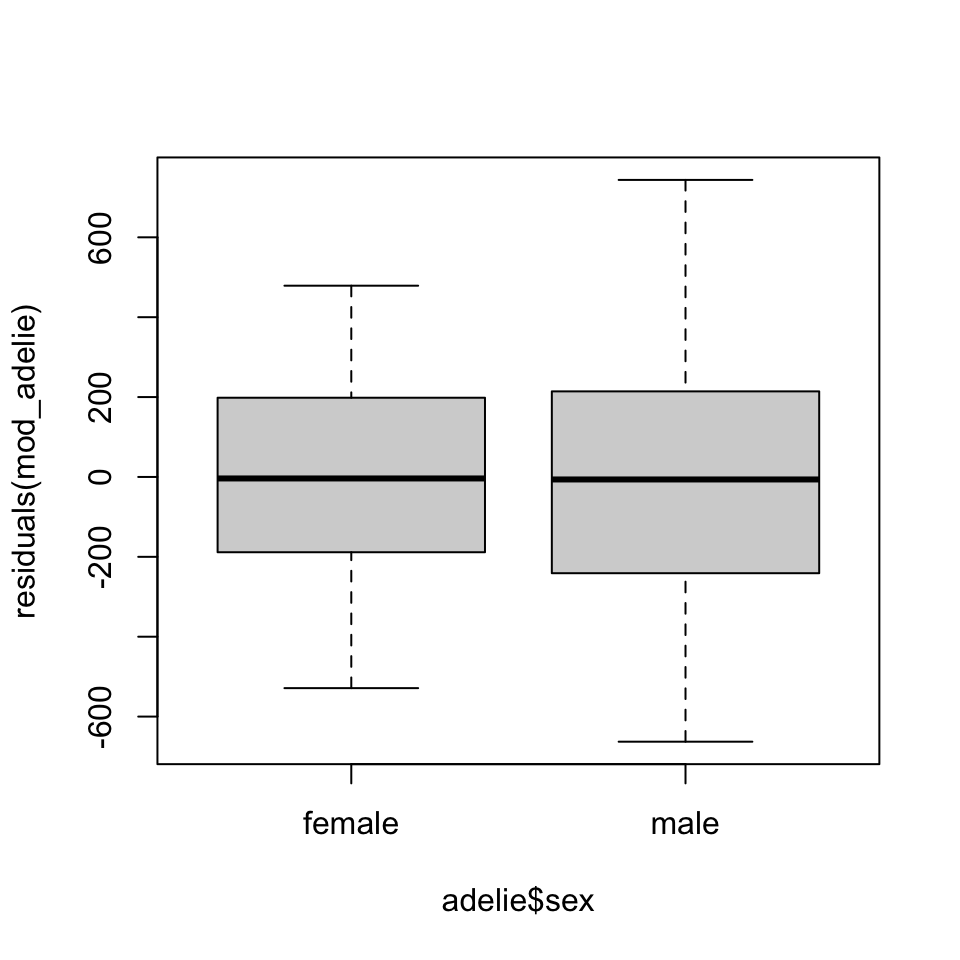
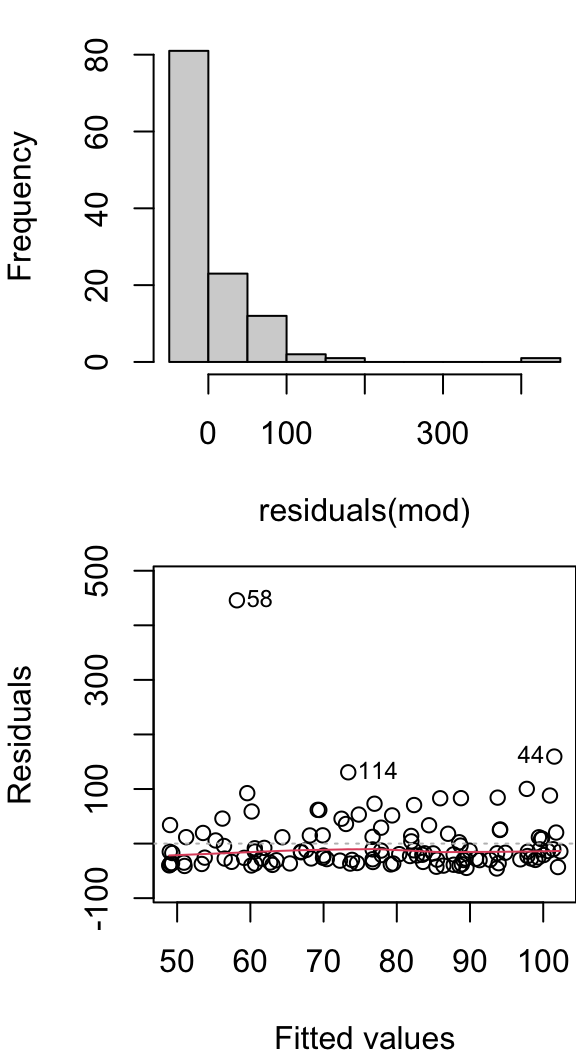
Bei der folgenden einfachen linearen Regression sind nicht alle Modellannahmen erfüllt, wie Residuenplots (rechts) zeigen:
             Estimate Std. Error  t value     Pr(>|t|)
(Intercept) 48.907219  10.776106 4.538487 1.373153e-05
area 5.403289 1.780359 3.034943 2.960263e-03lower_ci upper_ci
1.913785 8.892793 Wir wollen daher für den Steigungsparameter das Konfidenzintervall per Bootstrapverfahren und den p-Wert per Permutationstest berechnen.

Alle Aufgaben der Übungswoche finden Sie im Handbuch, gegliedert in drei Abschnitte:
→ Die Vorbereitung bearbeiten Sie bitte vor der Übungsstunde.
Dann testen Sie doch Ihr Wissen in folgendem Abschlussquiz…
Bei weiteren Fragen: saskia.otto(at)uni-hamburg.de

Diese Arbeit is lizenziert unter einer Creative Commons Attribution-ShareAlike 4.0 International License mit Ausnahme der entliehenen und mit Quellenangabe versehenen Abbildungen.