Spezielle Datentypen & fortgeschrittene Programmierung
Data Science 1 - Programmieren & Visualisieren
Universität Hamburg, IMF
Wintersemester
Lernziele

Am Ende dieser VL- und Übungseinheit werden Sie
- Faktoren mit Faktorstufen und Labels erstellen und deren Reihenfolge z.B. in Grafiken ändern können.
- Datum- und Zeitangaben mit lubridate umwandeln und Komponenten extrahieren können.
- Strings modifizieren und kombinieren können.
- Bedingungen mit
if..else..,ifelse()undcase_when()formulieren können. for-Schleifen für wiederkehrende Aufgaben schreiben können.- eigene Funktionen mit Argumenten und Standardwerten definieren können.
- einen ersten Eindruck von regulären Ausdrücken und funktionaler Programmierung haben.
DSB Cheatsheets
Eine komplette Übersicht der wichtigsten Funktionen gibt es hier:
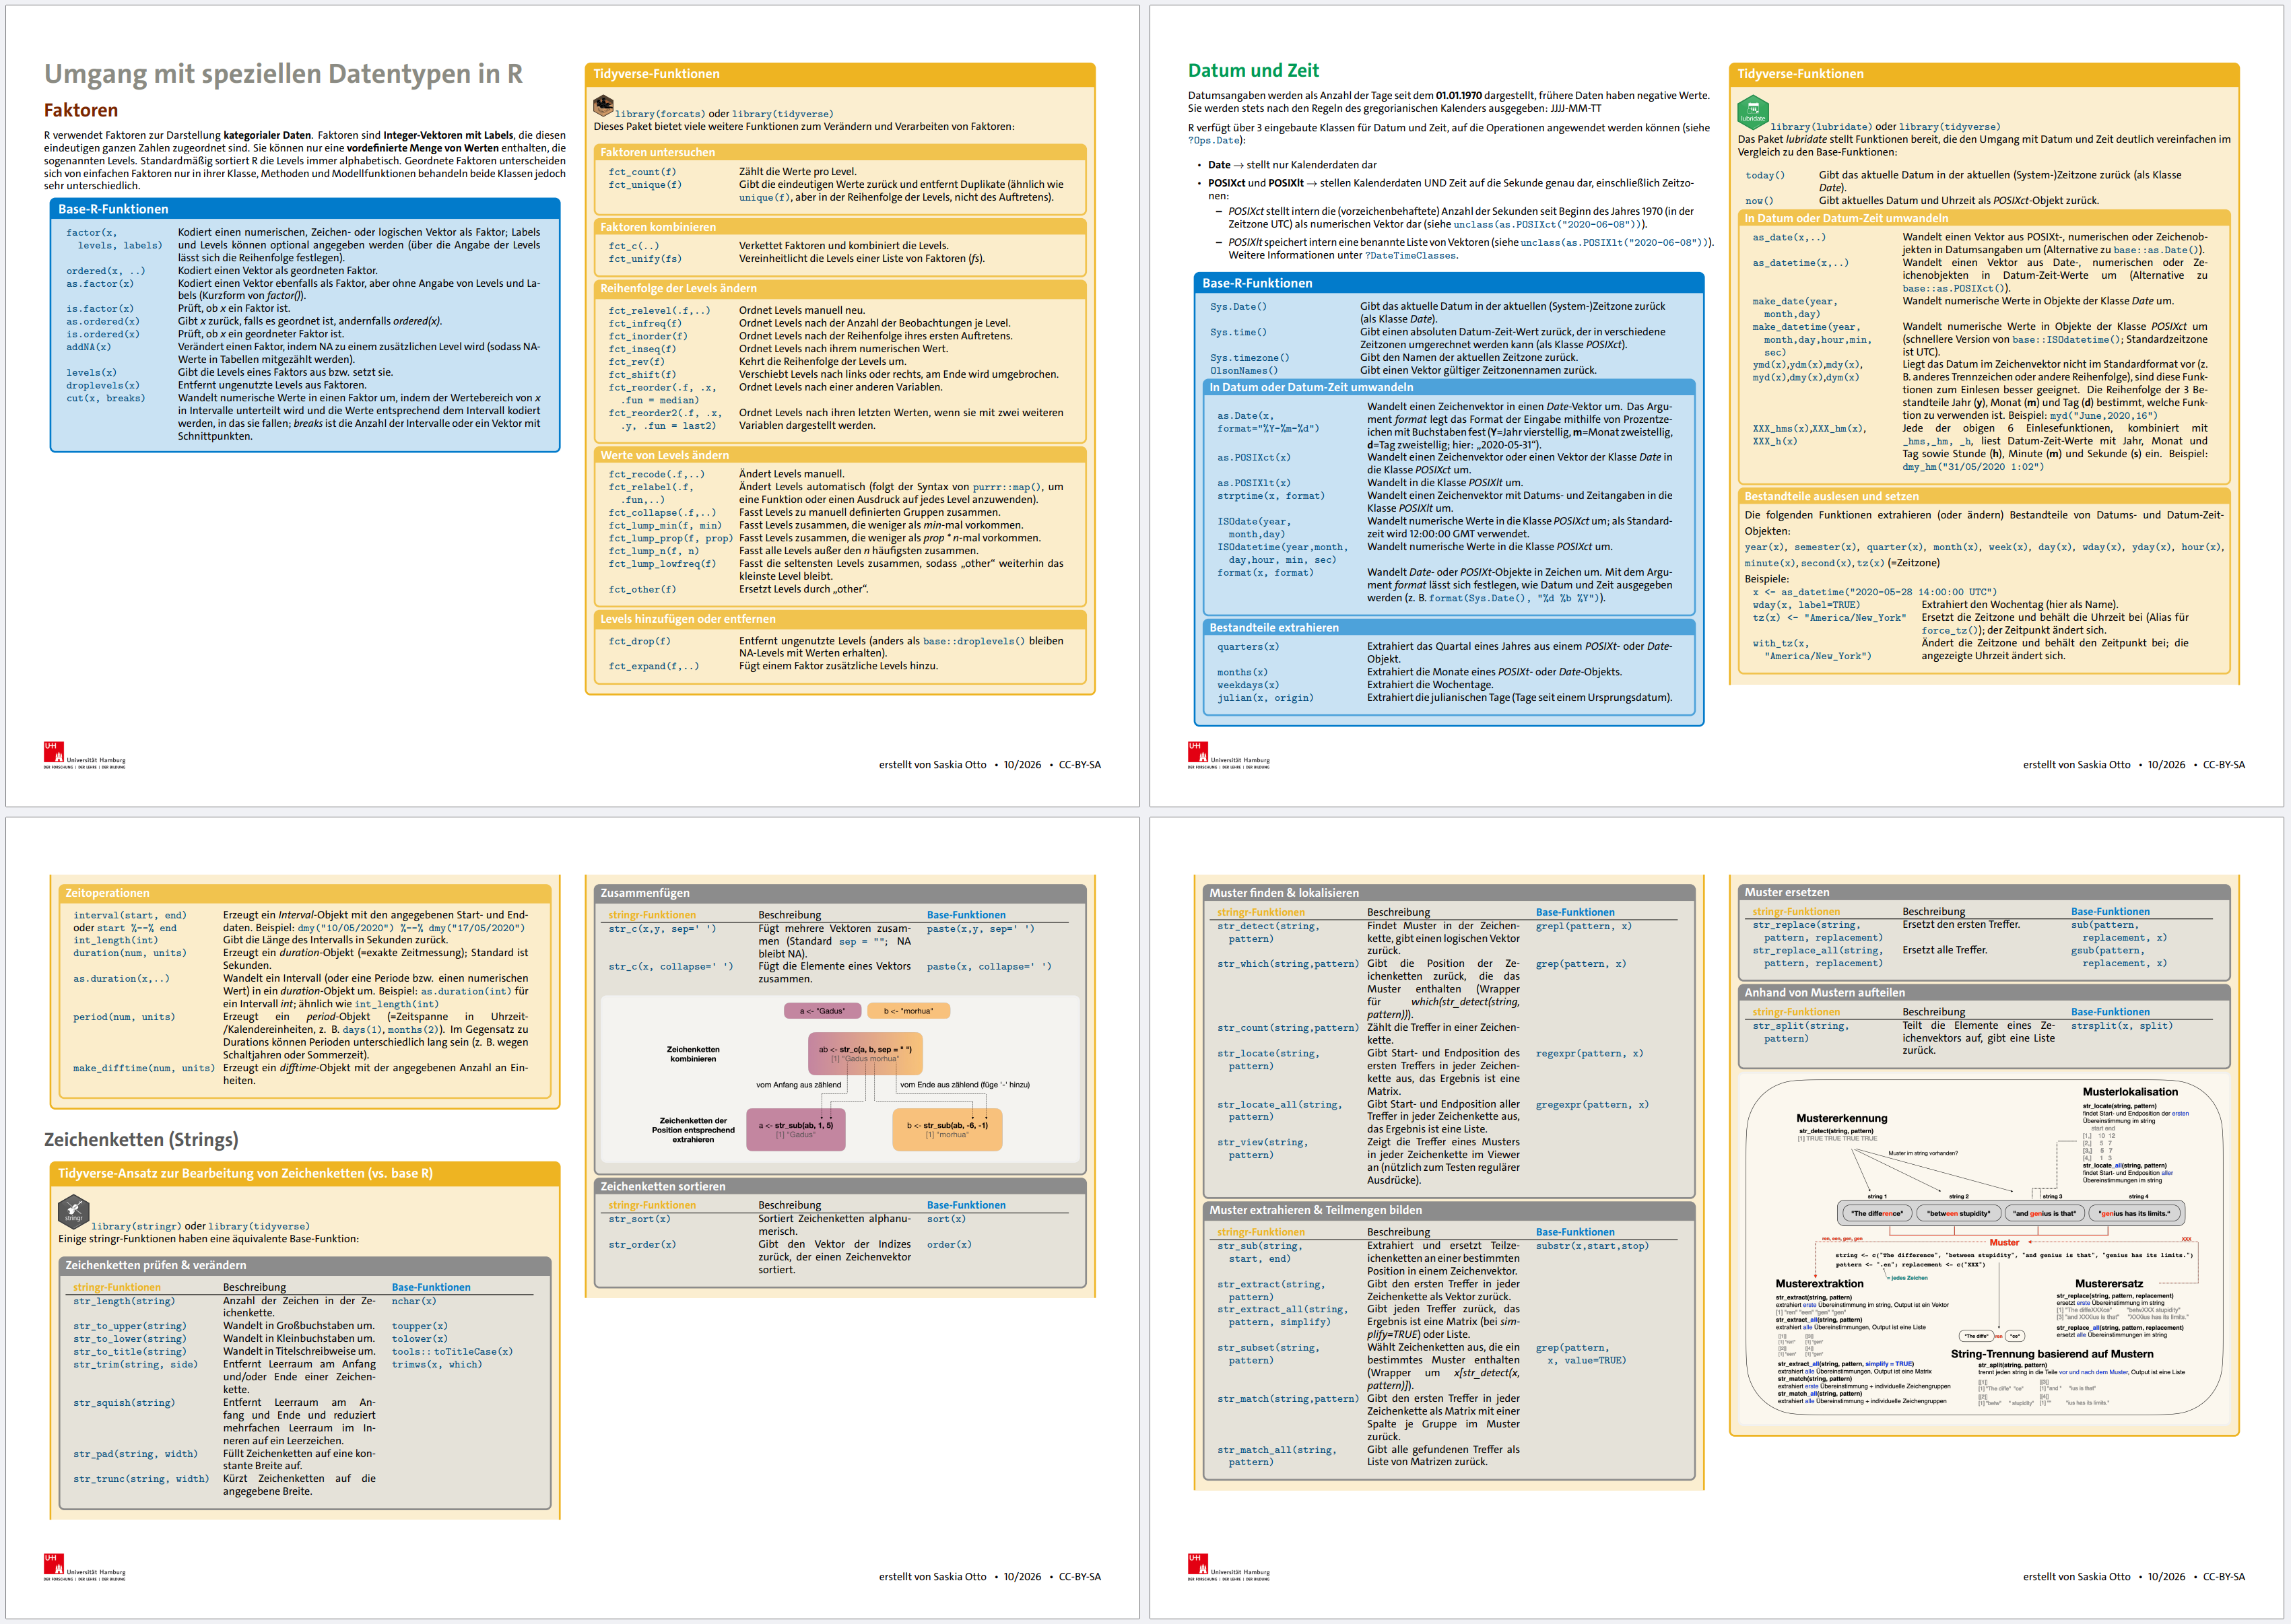
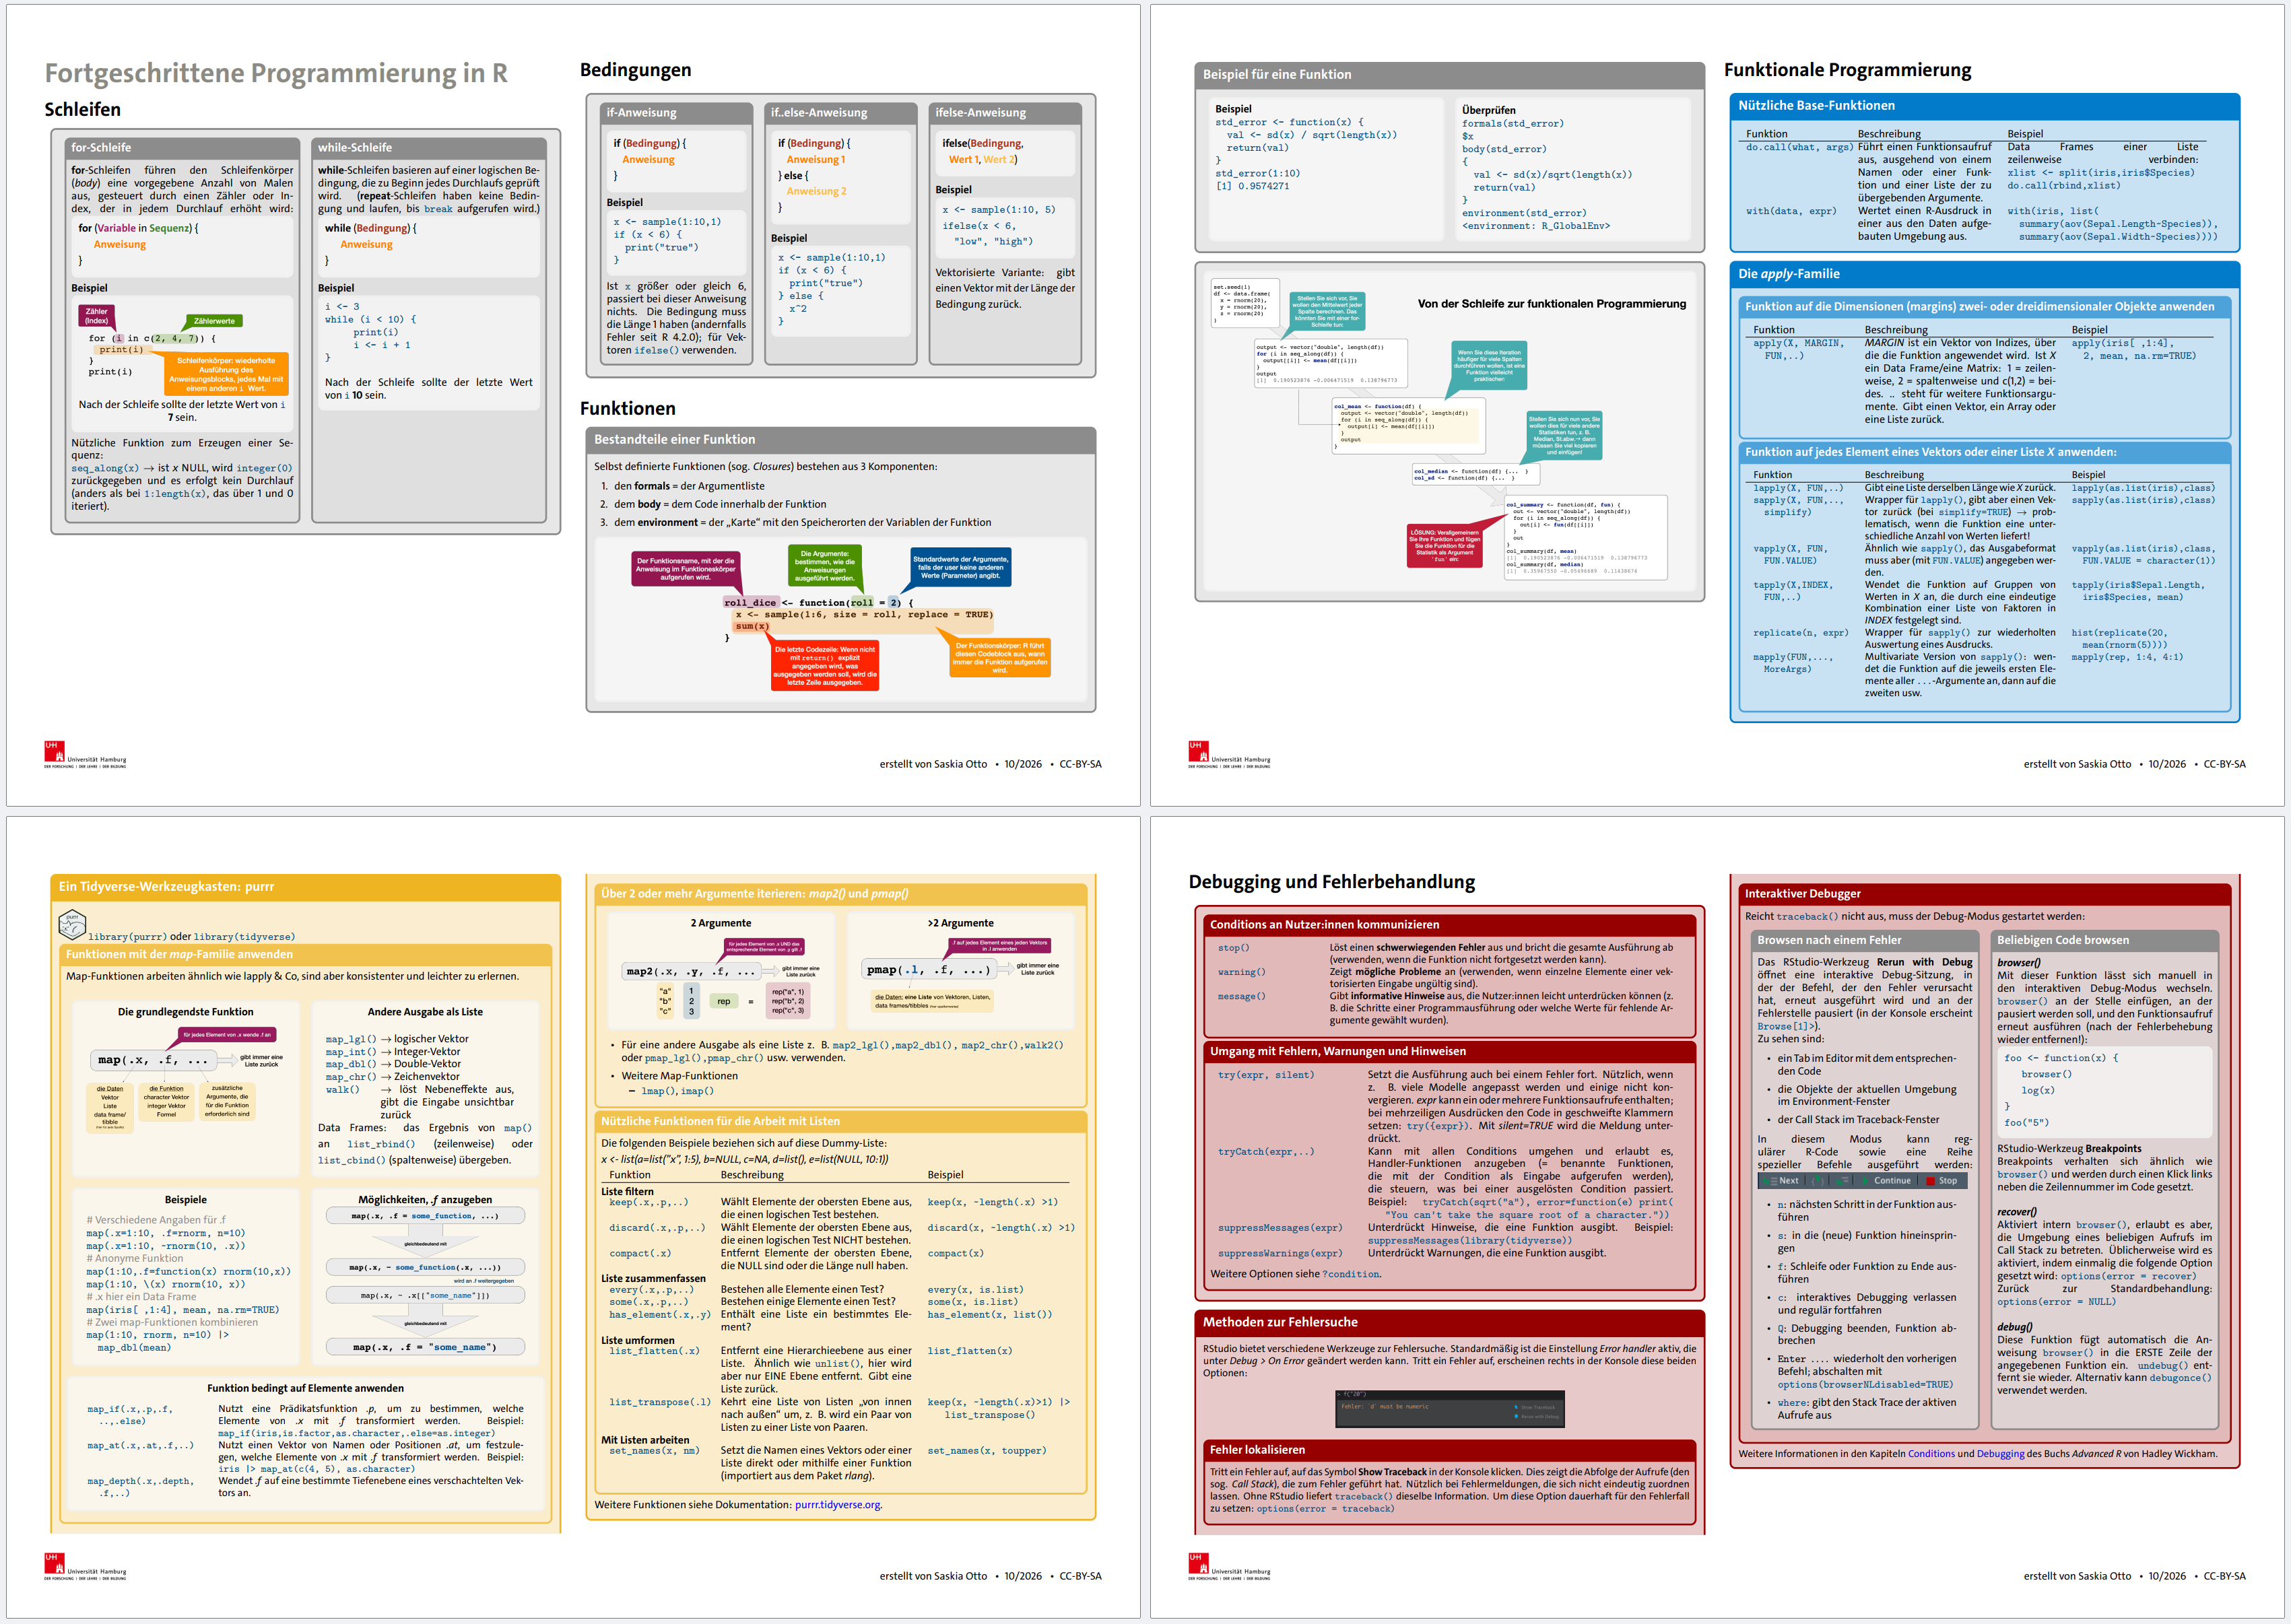
Diese wie alle anderen DSB Cheatsheets gibt es auf Moodle und der DSB Website unter Ressourcen > Cheatsheets & Guides.
Kategoriale Variablen als Faktoren
Warum Faktoren?
Faktoren sind Vektoren, die nur vorbestimmte Werte (Faktorstufen = levels) enthalten können, und werden für kategoriale Variablen verwendet. Intern sind sie ganzzahlige Vektoren mit den Attributen class (‘factor’) und levels.
Stellen Sie sich vor, Sie haben einen Vektor vom Typ ‘character’, der Monate enthält:
Problem 1
 Es findet keine Sortierung in einer hilfreichen Art und Weise statt.
Problem 2
Es gibt nur zwölf mögliche Monate, und nichts rettet Sie davor Tippfehler zu machen.
x2 <- c("Dec", "Apr", "Jam", "Mar")→ Ein einfaches factor(x1) oder as.factor(x1) löst die Probleme noch nicht – die Faktorstufen werden weiterhin alphabetisch sortiert.
Faktoren | levels definieren
Lösung in factor()
 Übergeben Sie dem Argument
levels einen Vektor mit allen gültigen Faktorstufen in gewünschter Reihenfolge.
- Sie können hier Faktorstufen einfügen, die nicht unbedingt im zu konvertierenden Vektor sein müssen.
- Jeder Wert, der nicht im Faktorstufen-Vektor ist, wird “leise” als NA konvertiert.
- Mit
levels(f1)lassen Sie sich die gültigen Faktorstufen anzeigen.
Weitere Optionen mit ‘forcats’

Ein hilfreiches ‘tidyverse’ Paket
- Umgedrehte Reihenfolge:
fct_rev() - Ordnung entsprechend
- der Häufigkeit:
fct_infreq() - der ersten Erscheinung:
fct_inorder()
- der Häufigkeit:
- Zusammenlegung von Faktorstufen:
fct_collapse() - Sortierung entlang einer anderen Variable:
fct_reorder() - Manuelle Ordnung der Faktorstufen:
fct_relevel()
Code
p <- bshydro15 |> ggplot() +
  guides(x = guide_axis(angle = 45)) +
  theme(text = element_text(size = 16))

p1 <- p + geom_bar(aes(month)) + ggtitle("Standardeinstellung")
p2 <- p + geom_bar(aes(fct_rev(month))) + ggtitle("fct_rev()")
p3 <- p + geom_bar(aes(fct_infreq(month))) + ggtitle("fct_infreq()")
p4 <- p + geom_bar(aes(fct_collapse(
    month,
    q1 = c("Jan", "Feb", "Mar"),
    q2 = c("Apr", "May", "Jun"),
    q3 = c("Jul", "Aug", "Sep"),
    q4 = c("Oct", "Nov", "Dec")
  ))) +
  xlab("annual quarter") +
  ggtitle("fct_collapse()")

gridExtra::grid.arrange(p1, p2, p3, p4, nrow = 2)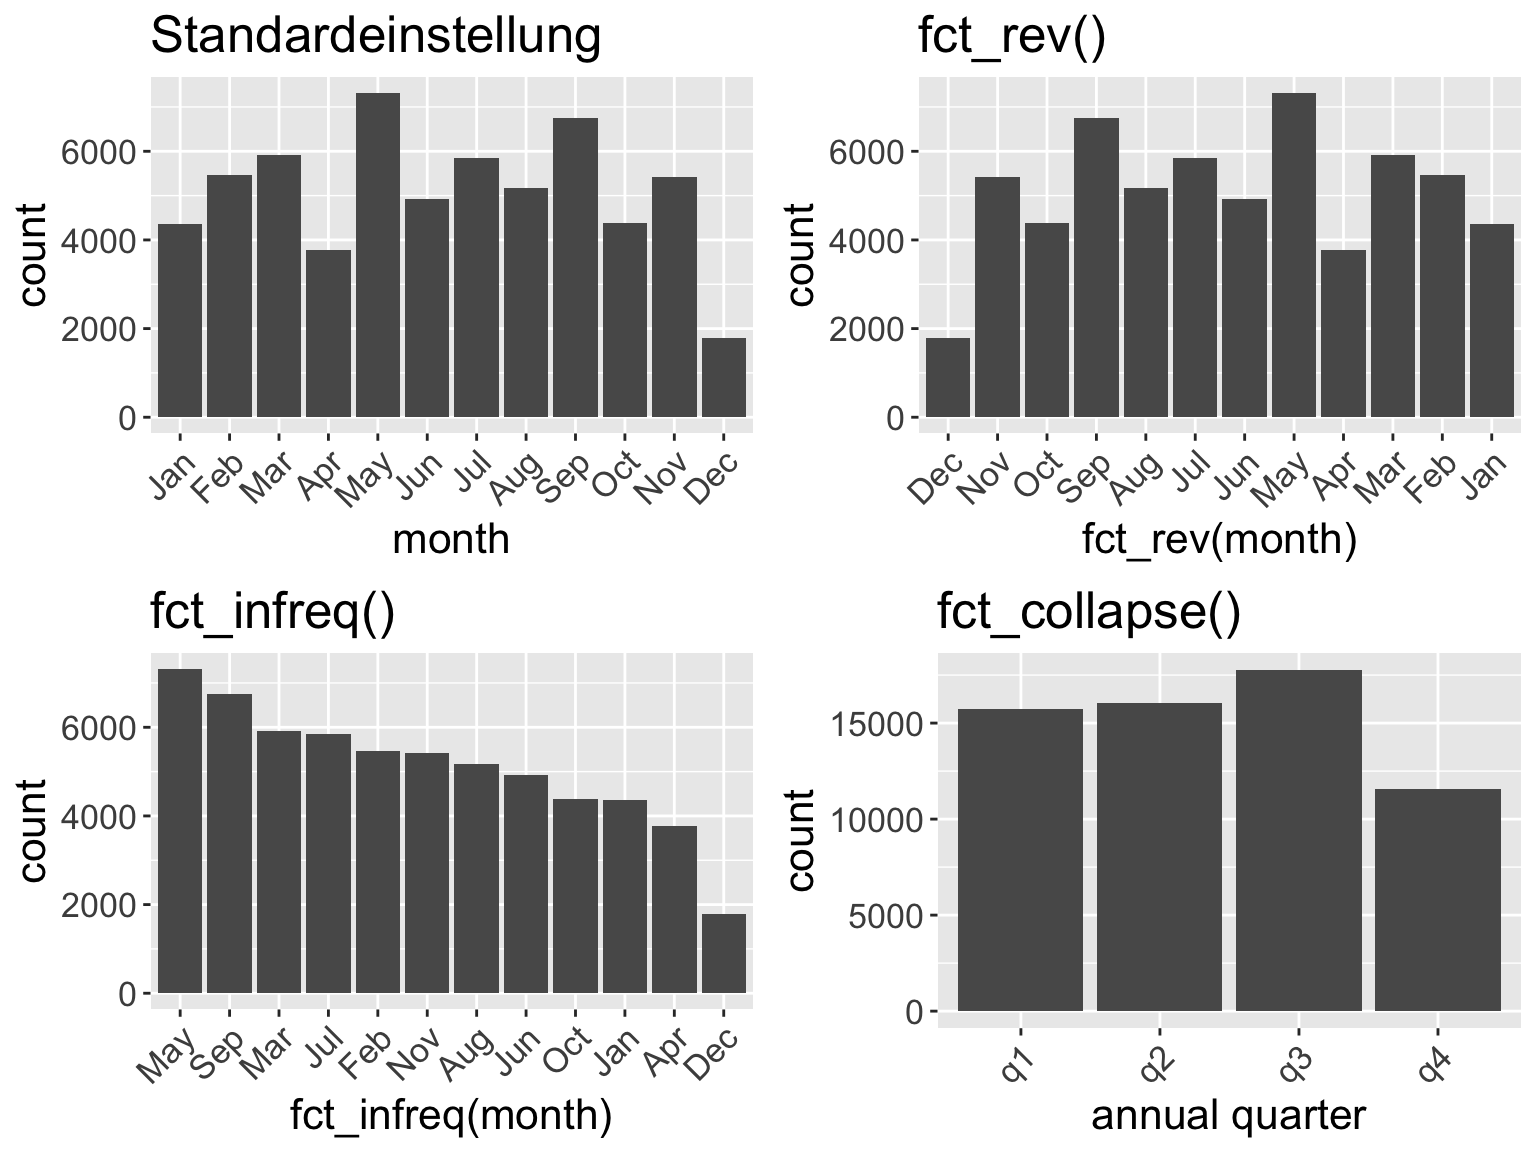
Your turn …

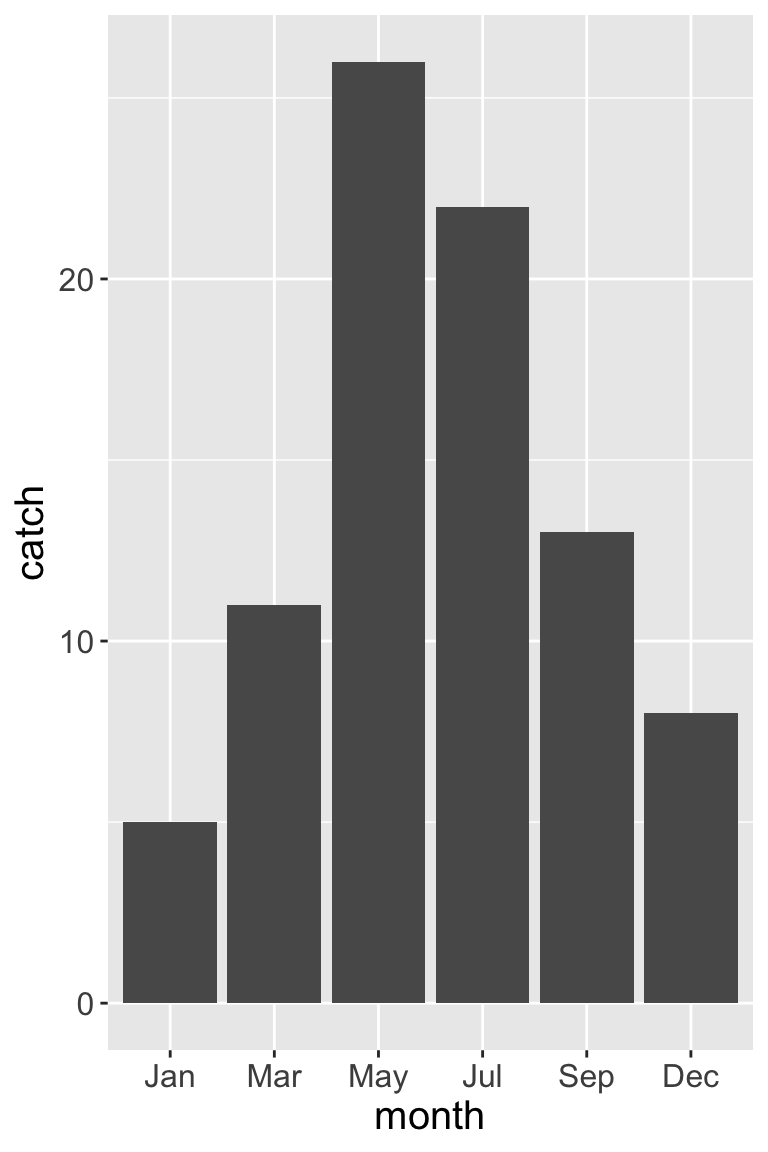
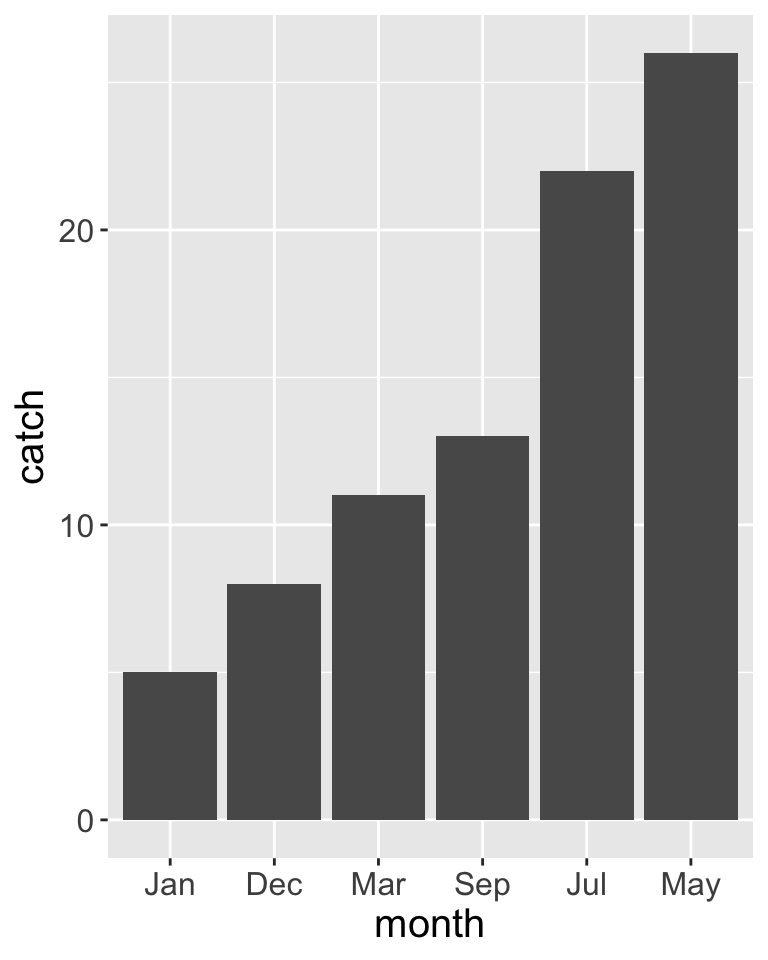
Quiz 1-2 | Faktoren

Der Umgang mit Datum und Zeit
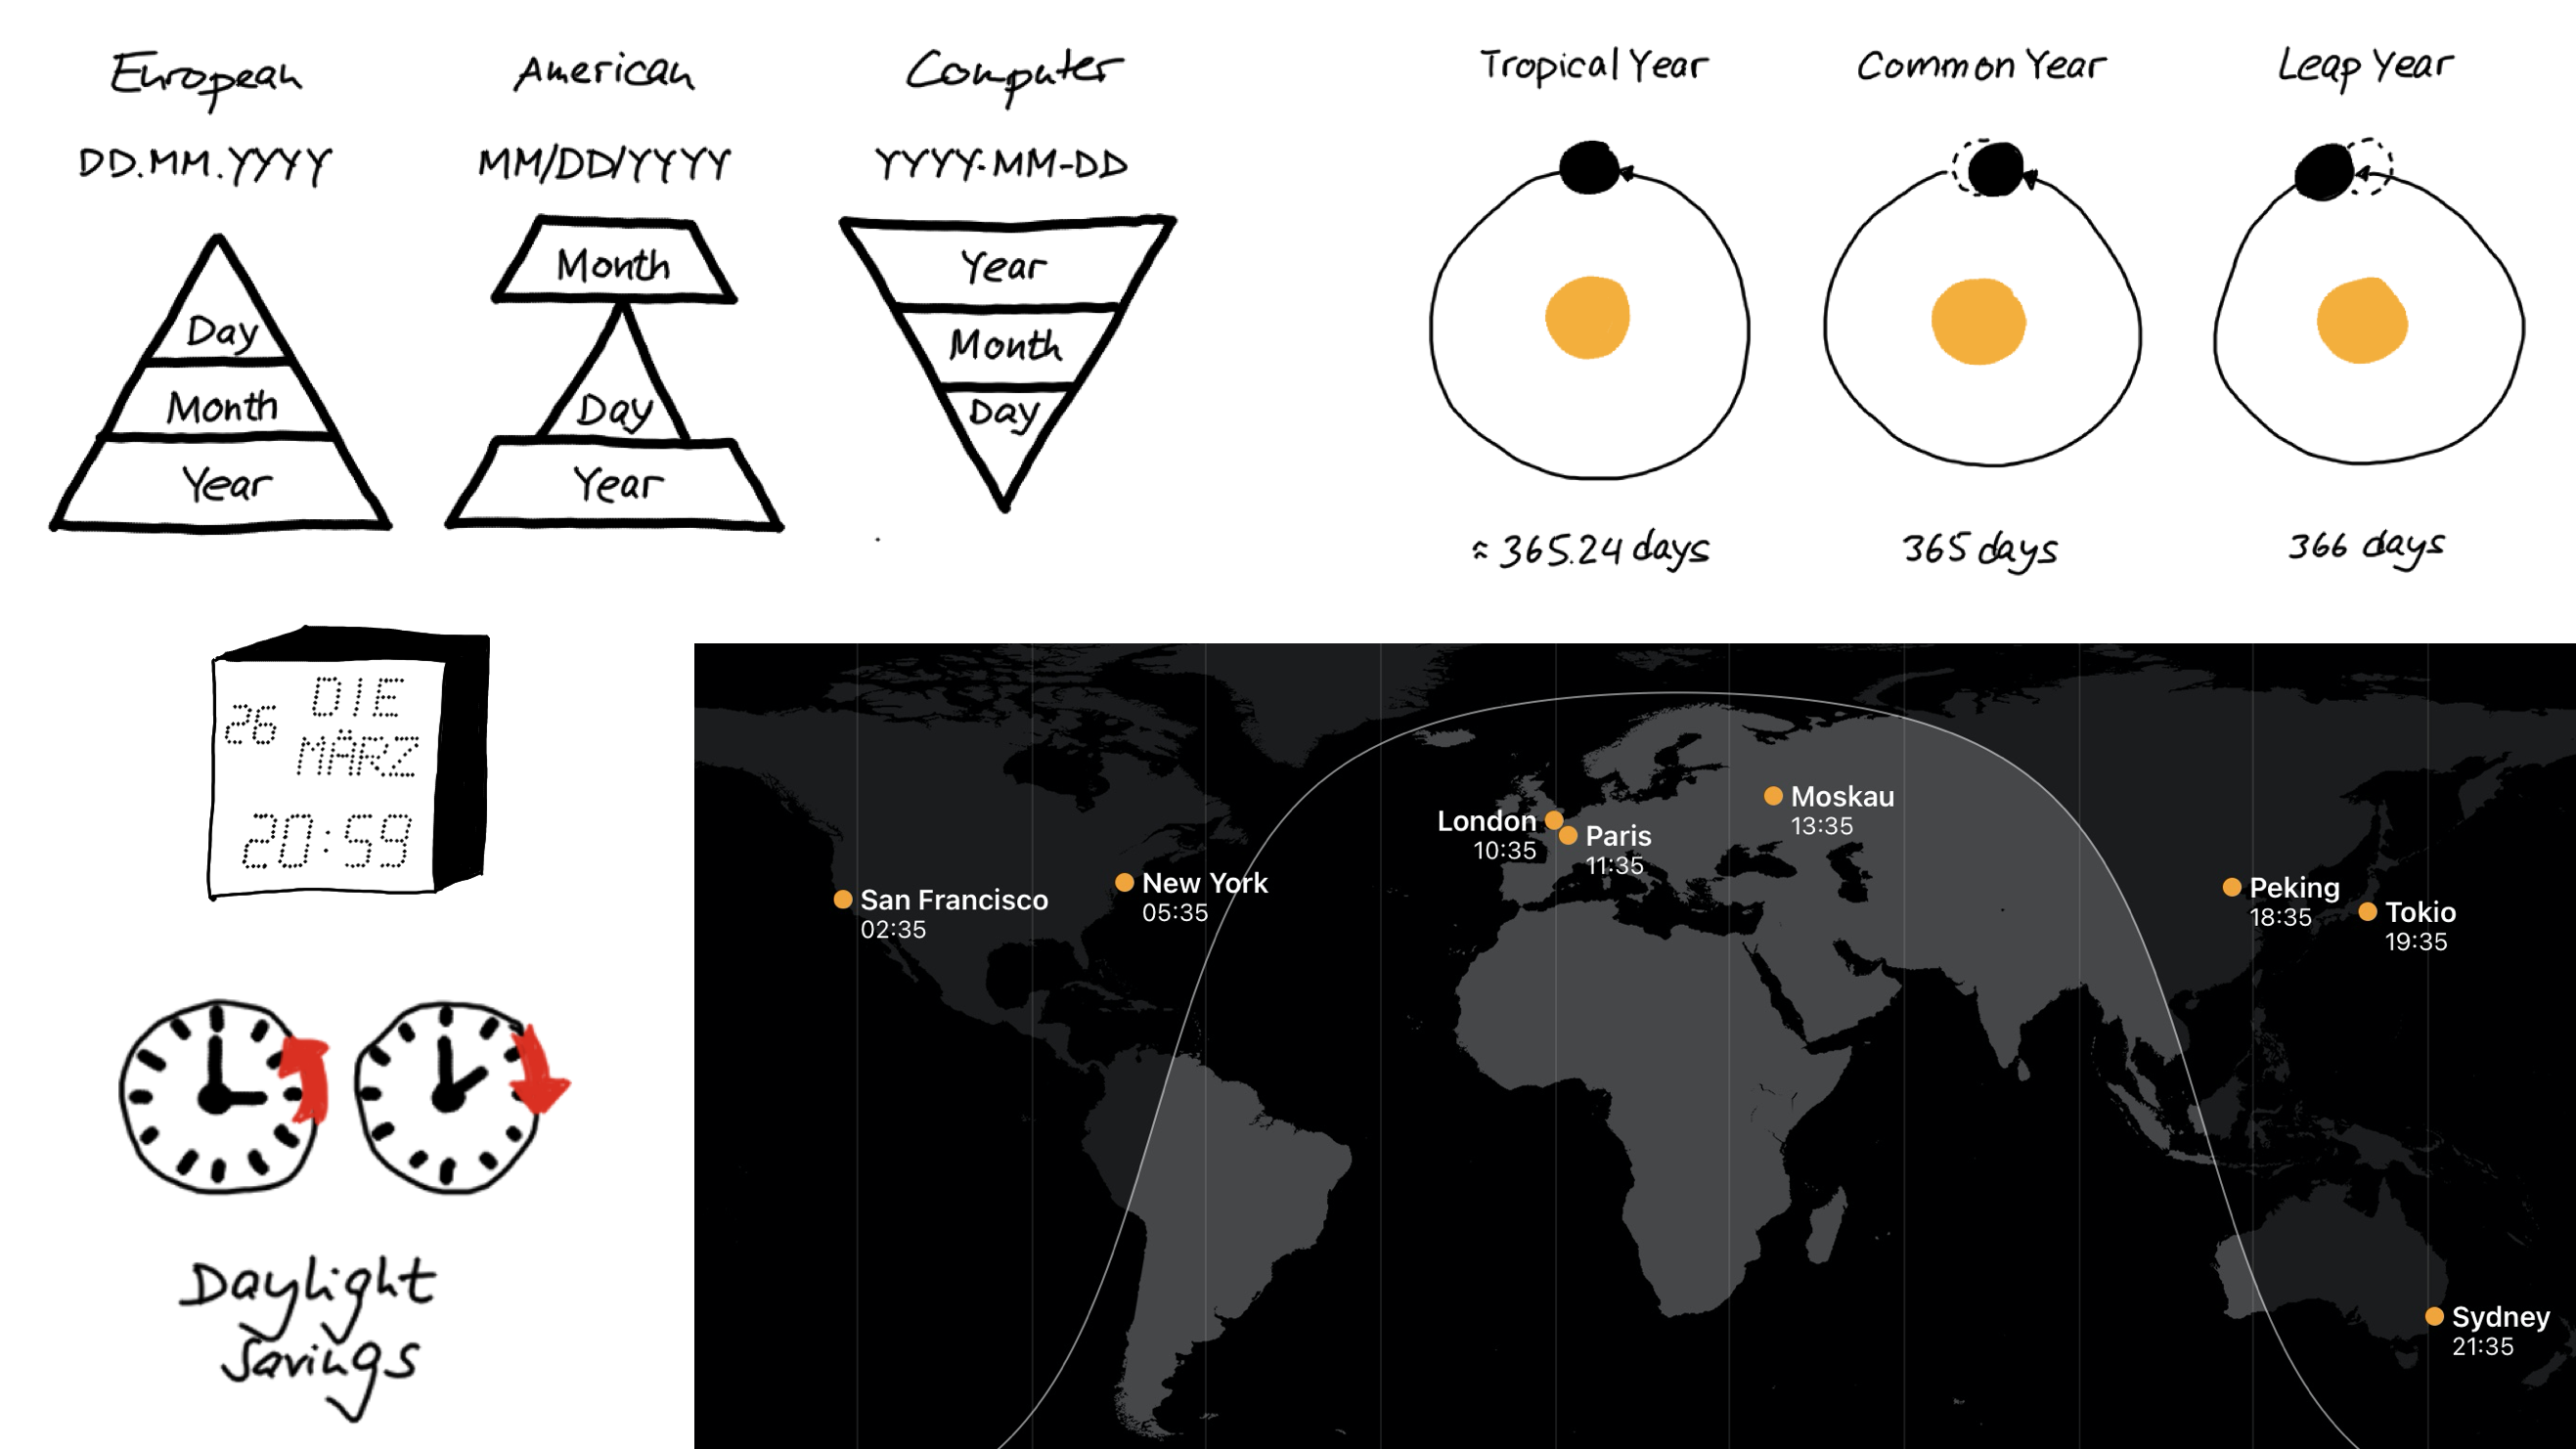
Zeit ist nicht gleich Zeit
Datum und Zeit definieren mit ‘lubridate’

Datum- und Zeitangaben werden beim Import oft nicht automatisch erkannt, sondern als ‘character’ eingelesen. Das Paket lubridate (seit tidyverse 2.0 ein Kernpaket) macht die Umwandlung einfach:
Nur Datum (Date)
- Abhängig von der Reihenfolge der Datumskomponenten:
ymd(),ydm(),mdy(),myd(),dmy(),dym()
- Die Reihenfolge ist entscheidend, das Format wird automatisch erkannt.
ymd("2026-11-17")[1] "2026-11-17"mdy("Nov 17th, 2026")[1] "2026-11-17"dmy(c("17-Nov-2026", "20.11.2026"))[1] "2026-11-17" "2026-11-20"Datum und Zeit (POSIXct)
Eine der 6 Datumfunktionen kombinieren mit:
_h→ nur Stunde_hm→ Stunde und Minute_hms→ Stunde, Minute und Sekunde
mdy_hm("11/17/2026 12:11")[1] "2026-11-17 12:11:00 UTC"ymd_hms("2026-11-17 12:11:59",
tz = "CET")[1] "2026-11-17 12:11:59 CET"→ Ohne tz Argument wird die Zeitzone UTC (Coordinated Universal Time) angenommen.
Datumskomponenten extrahieren
- Für Aggregationszwecke ist es häufig hilfreich, individuelle Komponenten zu extrahieren.
- Die Helferfunktionen in lubridate haben einfach den Namen der Komponente:
year(),semester(),quarter()month(),week()mday()- day of the monthyday()- day of the yearwday()- day of the weekhour(),minute(),second()
Zwischen POSIXct und Date wechseln Sie mit as_date() und as_datetime() – dabei kann Information (die Uhrzeit) verloren gehen.
Your turn …
Quiz 3 | Datum & Zeit
Folgender Tibble enthält mehrere Datum- bzw. Datum/Zeit-Variablen, die aber alle als ‘character’ Datentyp vorliegen:
# A tibble: 10 × 5
   x1         x2         x3           x4                  x5
   <chr>      <chr>      <chr>        <chr>               <chr>
 1 2015-07-26 2015/26/07 Jul 26, 2015 2015-07-26 18:16:00 26.07.2015T18:16
 2 2015-07-03 2015/03/07 Jul 03, 2015 2015-07-03 16:42:00 03.07.2015T16:42
 3 2015-09-01 2015/01/09 Sep 01, 2015 2015-09-01 04:45:00 01.09.2015T04:45
 4 2015-06-03 2015/03/06 Mar 03, 2015 2015-06-03 08:08:00 03.06.2015T08:08
 5 2015-10-15 2015/15/10 Oct 15, 2015 2015-10-15 21:05:00 15.10.2015T21:05
 6 2015-10-01 2015/01/10 Oct 01, 2015 2015-10-01 10:38:00 01.10.2015T10:38
 7 2015-03-14 2015/14/03 Mar 14, 2015 2015-03-14 05:55:00 14.03.2015T05:55
 8 2015-02-25 2015/25/02 Jun 25, 2015 2015-02-25 08:12:00 25.02.2015T08:12
 9 2015-06-03 2015/03/06 Sep 03, 2015 2015-06-03 11:09:00 03.06.2015T11:09
10 2015-09-14 2015/14/09 Jul 14, 2015 2015-09-14 05:38:00 14.09.2015T05:38# A tibble: 10 × 5
x1 x2 x3 x4 x5
<date> <date> <date> <dttm> <dttm>
1 2015-07-26 2015-07-26 2015-07-26 2015-07-26 18:16:00 2015-07-26 18:16:00
2 2015-07-03 2015-07-03 2015-07-03 2015-07-03 16:42:00 2015-07-03 16:42:00
3 2015-09-01 2015-09-01 2015-09-01 2015-09-01 04:45:00 2015-09-01 04:45:00
4 2015-06-03 2015-06-03 2015-03-03 2015-06-03 08:08:00 2015-06-03 08:08:00
5 2015-10-15 2015-10-15 2015-10-15 2015-10-15 21:05:00 2015-10-15 21:05:00
6 2015-10-01 2015-10-01 2015-10-01 2015-10-01 10:38:00 2015-10-01 10:38:00
7 2015-03-14 2015-03-14 2015-03-14 2015-03-14 05:55:00 2015-03-14 05:55:00
8 2015-02-25 2015-02-25 2015-06-25 2015-02-25 08:12:00 2015-02-25 08:12:00
9 2015-06-03 2015-06-03 2015-09-03 2015-06-03 11:09:00 2015-06-03 11:09:00
10 2015-09-14 2015-09-14 2015-07-14 2015-09-14 05:38:00 2015-09-14 05:38:00Strings
Manipulation von Zeichenketten & das Paket ‘stringr’
 Auch wenn Sie keine aufwendige Textanalyse vorhaben, kann es für Sie hilfreich sein Wissen über die Handhabung und Verarbeitung von Zeichenketten in R zu haben!
Wozu brauche ich das?

Sie möchten z.B.
- Spaltennamen vereinheitlichen,
- Stations- oder Artnamen korrigieren, kürzen oder kombinieren,
- Kategorien re-klassifizieren,
- viele Dateien mit ähnlichem Dateinamen importieren.
→ In stringr (Teil des tidyverse) starten alle Funktionen mit str_ und haben konsistente Argumente.
Strings modifizieren | 1
Schreibweise ändern
str_to_lower()
→ Umwandlung zu Kleinbuchstabenstr_to_upper()
→ Umwandlung zu Großbuchstabenstr_to_sentence()
→ erster Buchstabe großstr_to_title()
→ Anfangsbuchstabe jedes Wortes groß
str_to_lower(einstein)[1] "the difference" "between stupidity" "and genius is that"
[4] "genius has its limits."str_to_upper(einstein)[1] "THE DIFFERENCE" "BETWEEN STUPIDITY" "AND GENIUS IS THAT"
[4] "GENIUS HAS ITS LIMITS."str_to_sentence(einstein)[1] "The difference" "Between stupidity" "And genius is that"
[4] "Genius has its limits."str_to_title(einstein)[1] "The Difference" "Between Stupidity" "And Genius Is That"
[4] "Genius Has Its Limits."Strings modifizieren | 2
Schreibweise ändern
Anwendungsbeispiel: Spaltennamen überschreiben
names(iris) <- str_to_lower(names(iris))
head(iris)
sepal.length sepal.width petal.length petal.width species
1 5.1 3.5 1.4 0.2 setosa
2 4.9 3.0 1.4 0.2 setosa
3 4.7 3.2 1.3 0.2 setosa
4 4.6 3.1 1.5 0.2 setosa
5 5.0 3.6 1.4 0.2 setosa
6 5.4 3.9 1.7 0.4 setosaStrings modifizieren | 3
Leerzeichen entfernen
str_trim()→ Entfernt ‘white space’ am Anfang und Ende einer Zeichenkette.
Anwendungsbeispiel: Kategorien mit Leerzeichen bereinigen
dat <- read.csv("data/medley.csv")
str(dat)
'data.frame': 34 obs. of 3 variables:
$ station : chr "ER1 " "ER2 " "ER3 " "ER4 " ...
$ zinc : chr "BACK " "HIGH " "HIGH " "MEDIUM " ...
$ diversity: num 2.27 1.25 1.15 1.62 1.7 0.63 2.05 1.98 1.04 2.19 ...unique(dat$zinc) # uuups[1] "BACK " "HIGH " "MEDIUM " "LOW "dat$zinc <- str_trim(dat$zinc)
unique(dat$zinc)[1] "BACK" "HIGH" "MEDIUM" "LOW" Strings kombinieren | 1
str_c(..., sep = "", collapse = NULL)→ Fügt 2 oder mehr Skalare oder Vektoren (egal welcher Datentyp!) elementweise zu einem Zeichenvektor zusammen.- sep → Optionales Trennzeichen zwischen den einzelnen zu verkettenden Elementen.
- collapse → Trennzeichen zwischen den Elementen des Output Vektors unter weiterer Verkettung zu einem einzigen String.
Mit/ohne 'sep' Argument
# 2 Skalare - Standardeinstellung
str_c("A", "B")
[1] "AB"# 2 Skalare - mit Trennzeichen
str_c("A", "B", sep = "/")[1] "A/B"# 2 Vektoren - mit Trennzeichen
str_c(c("A","B"), 1:2,
sep = "-")[1] "A-1" "B-2"Mit 'collapse' Argument
# 1 Vektor - kollabierend zu 1 String
str_c(c("A","B"), collapse = " + ")
[1] "A + B"str_c(einstein, collapse = " ")[1] "The difference between stupidity and genius is that genius has its limits."# 2 Vektoren - kollabierend zu 1 String
str_c(c("A","B","C"), 1:3, sep = ".",
collapse = ", ") [1] "A.1, B.2, C.3"Strings kombinieren | 2
Anwendungsbeispiel 1
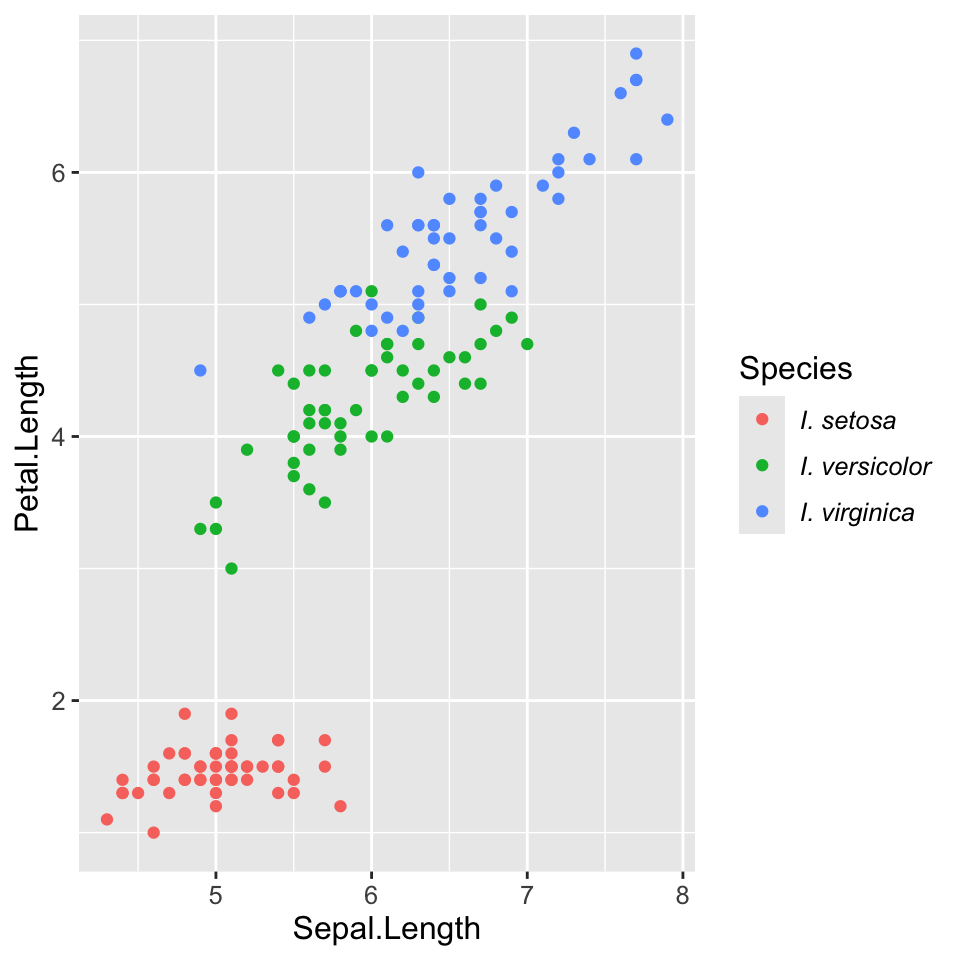
Strings kombinieren | 3
Anwendungsbeispiel 2
Deskriptive Statistiktabelle
iris |> mutate(
  Species = str_c("Iris ", Species)) |>
  group_by(Species) |>
  summarise(
    slm = round(mean(Sepal.Length), 1),
    sls = round(sd(Sepal.Length), 2),
    slms = str_c(slm, sls, sep=" ± ")
  ) |>
  select(Species, slms) |>
  knitr::kable(
    col.names = c("Species",
      "Mean Sepal Length (± st.dev)")
) # erstellt Tabellen in LaTeX, HTML| Species | Mean Sepal Length (± st.dev) |
|---|---|
| Iris setosa | 5 ± 0.35 |
| Iris versicolor | 5.9 ± 0.52 |
| Iris virginica | 6.6 ± 0.64 |
Muster in Zeichenketten
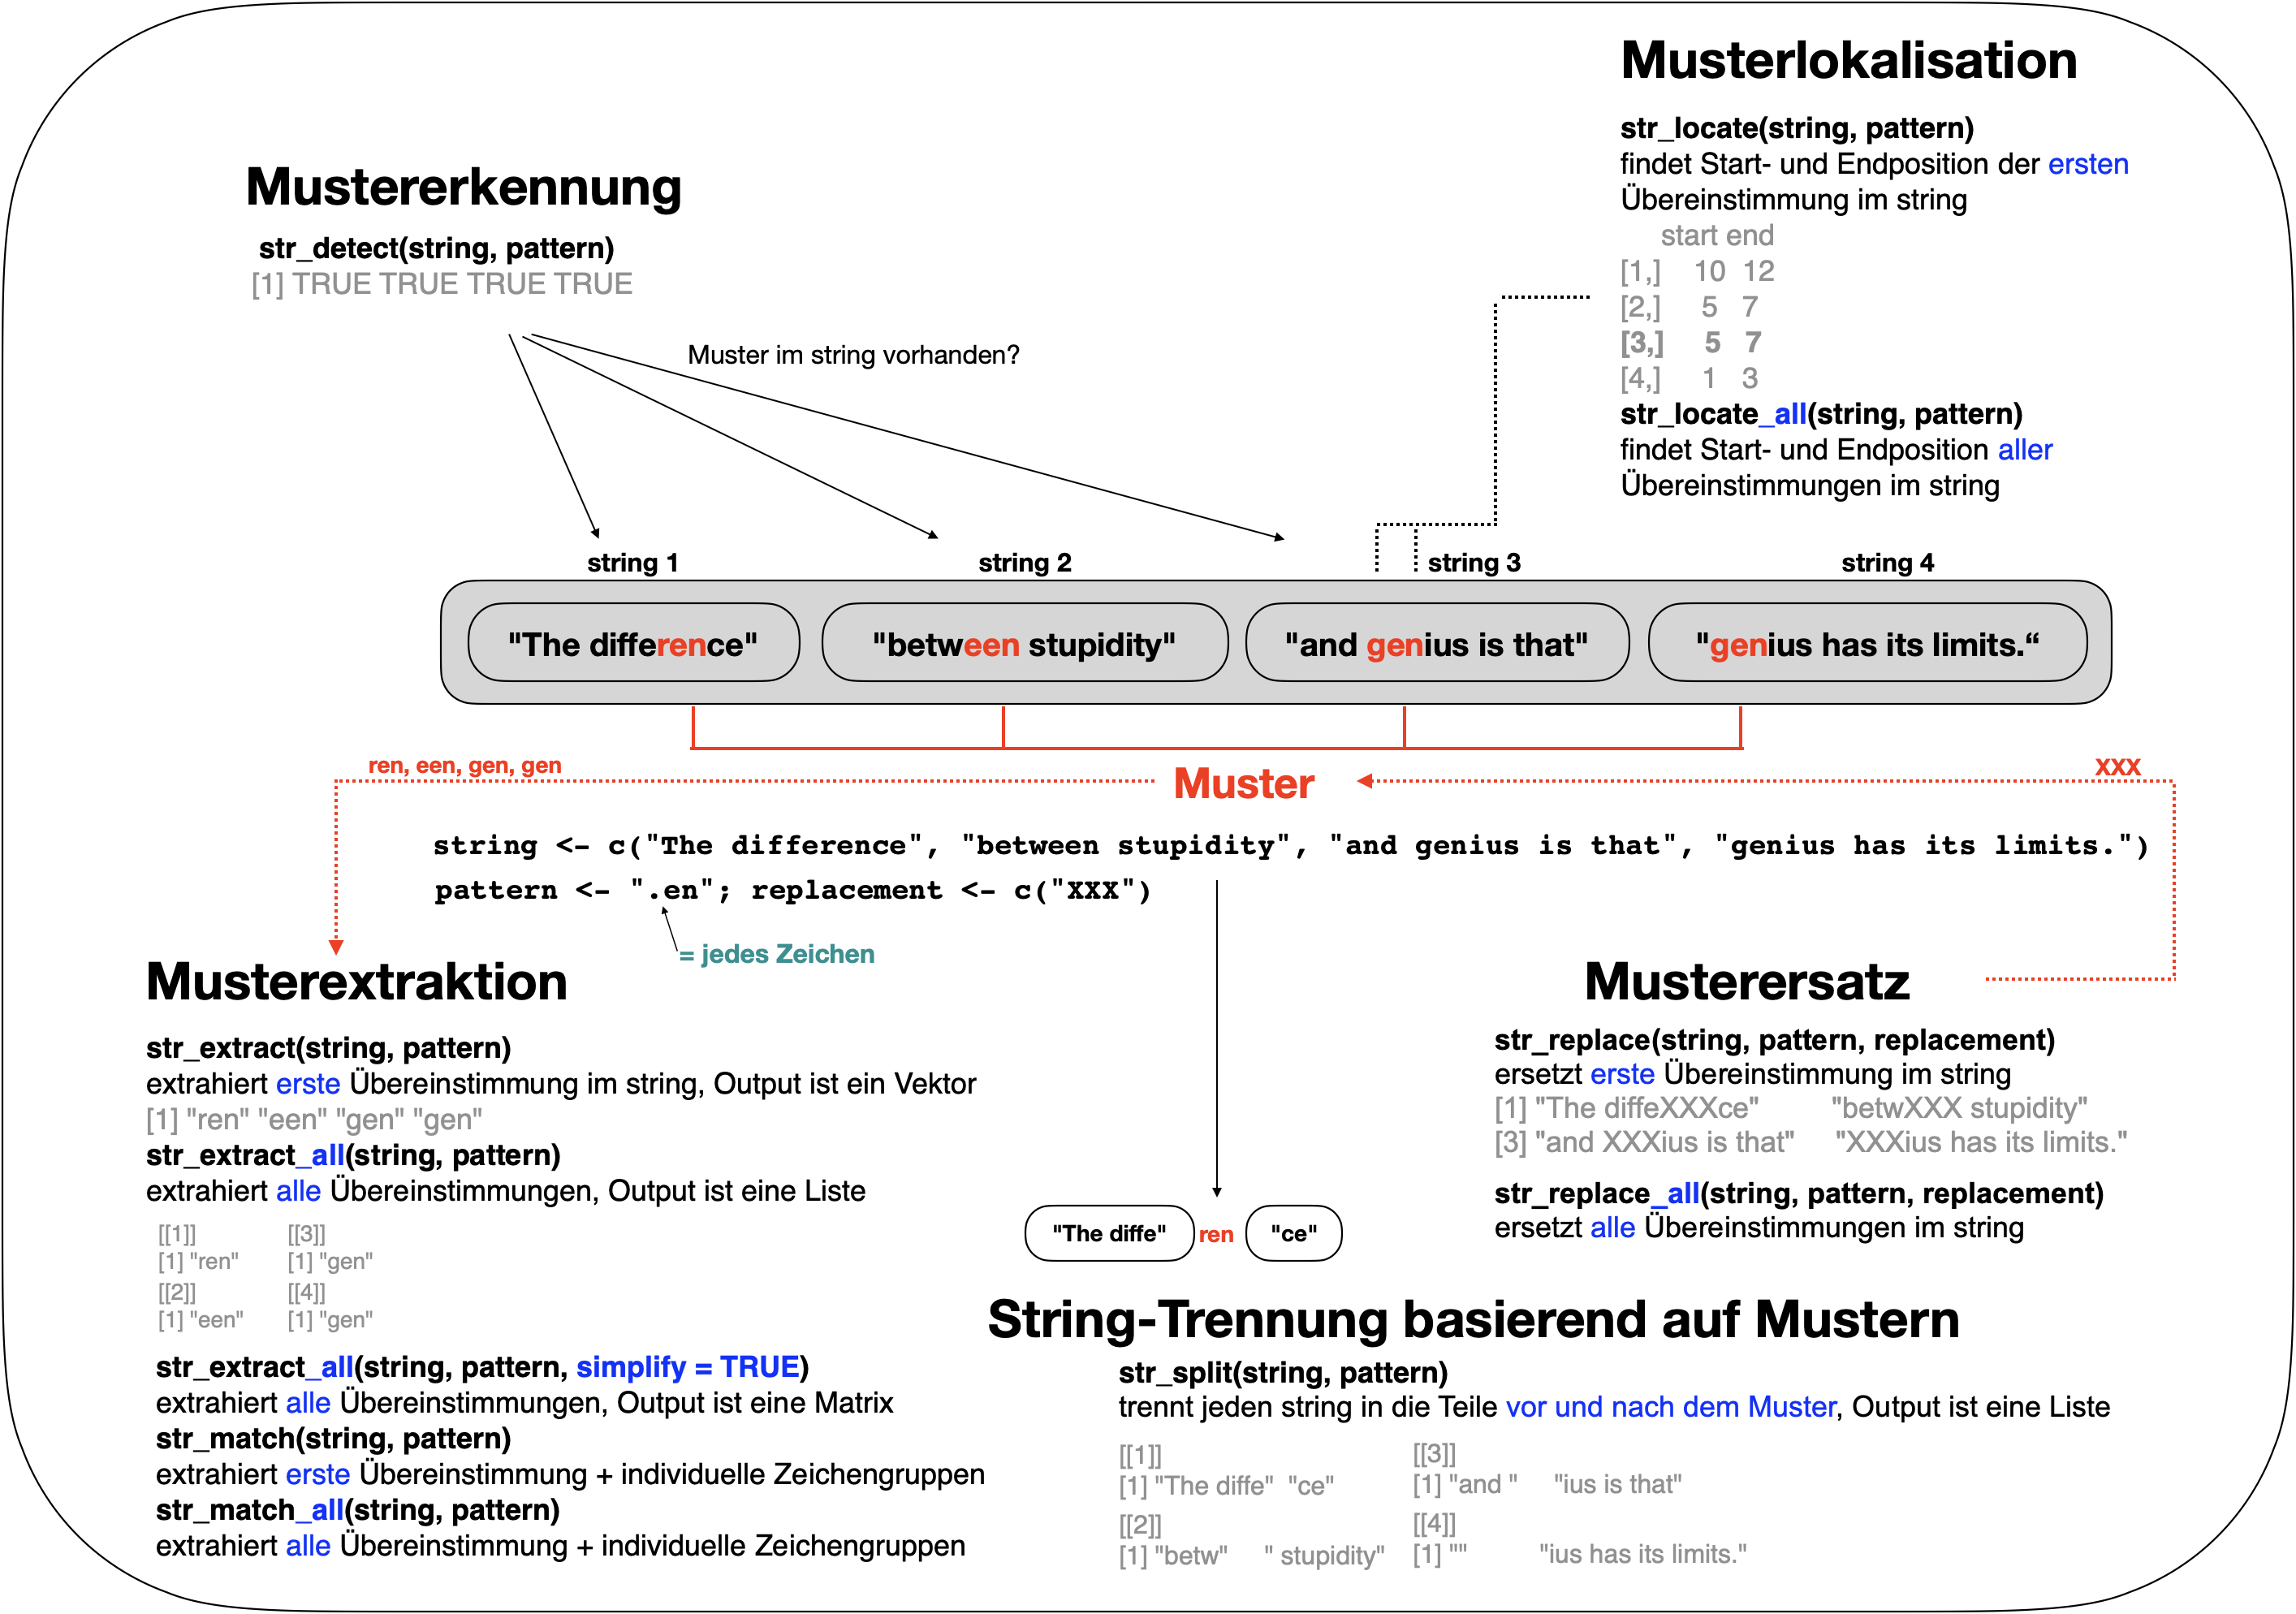
Muster austauschen mit str_replace() | 1
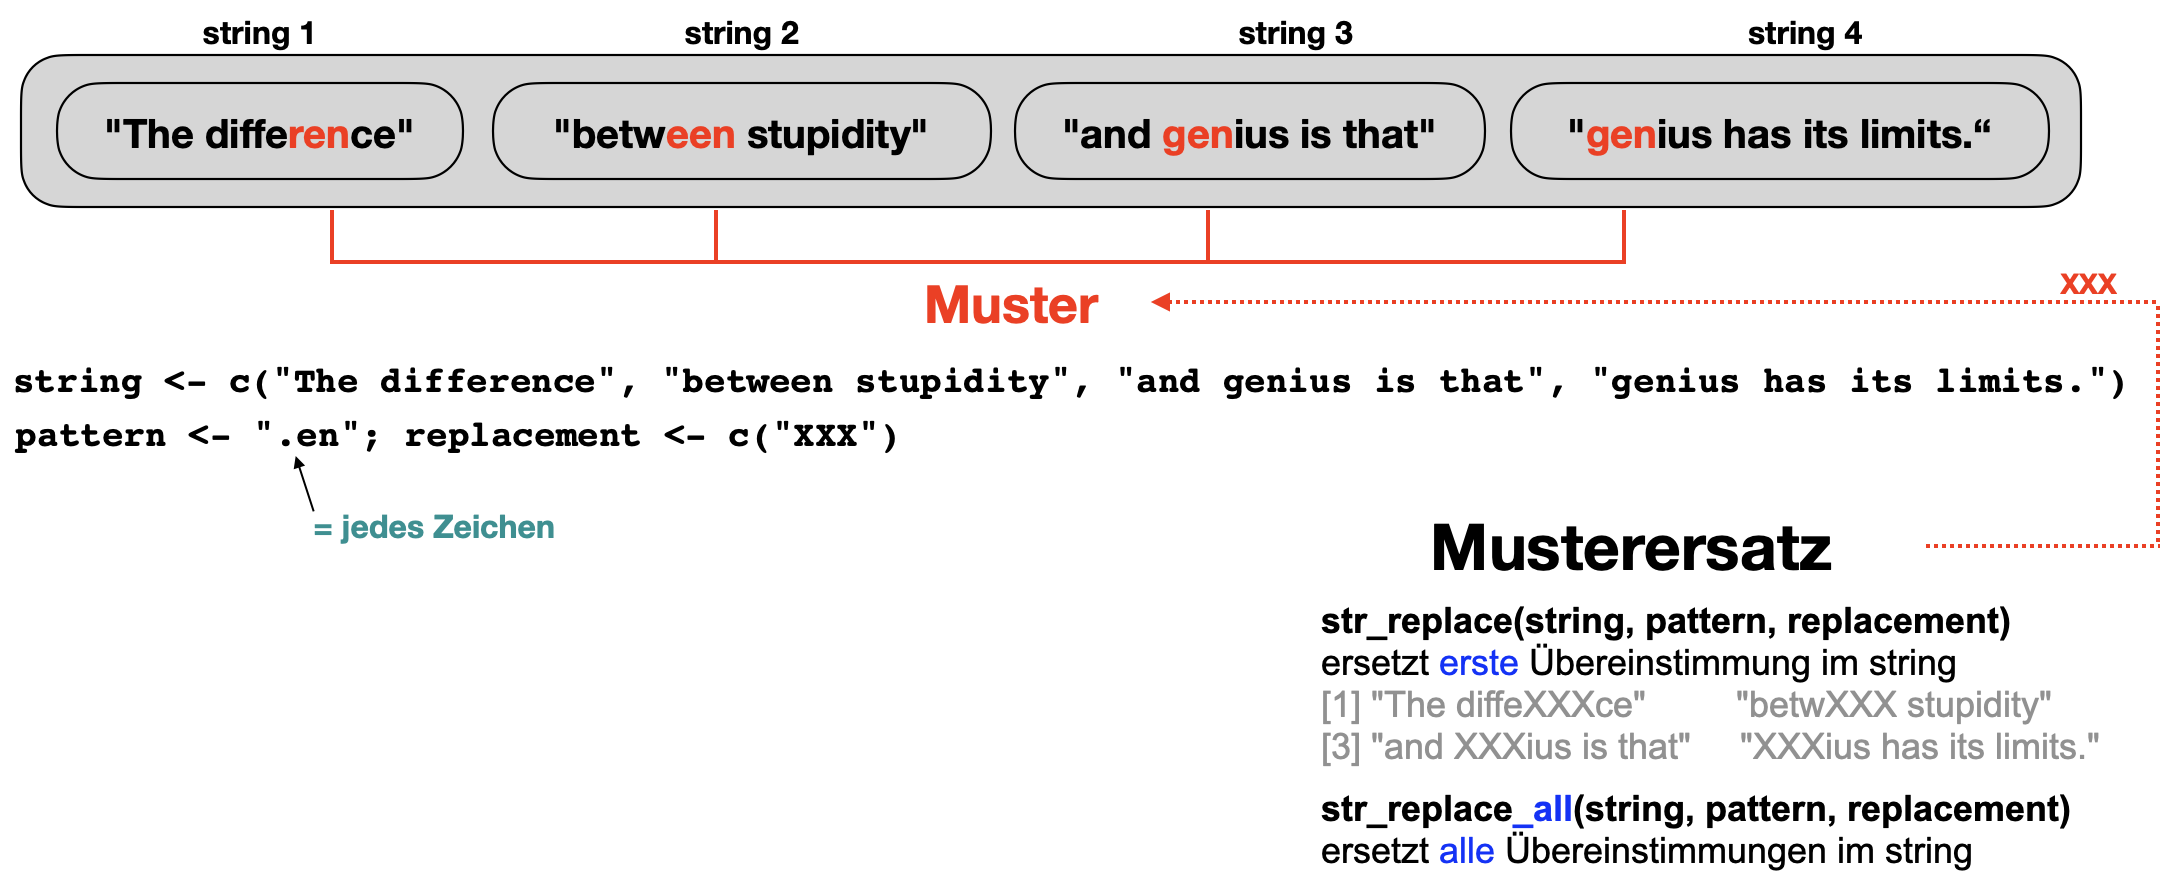
Überblick der regulären Ausdrücke
- Die Muster werden mit regulären Ausdrücken (‘regex’) beschrieben, einer kurzen und prägnanten Sprache zur Beschreibung von Mustern in Zeichenketten.
- Mehr dazu auf der Webseite www.regular-expressions.info mit vielen Beispielen und Tutorials.
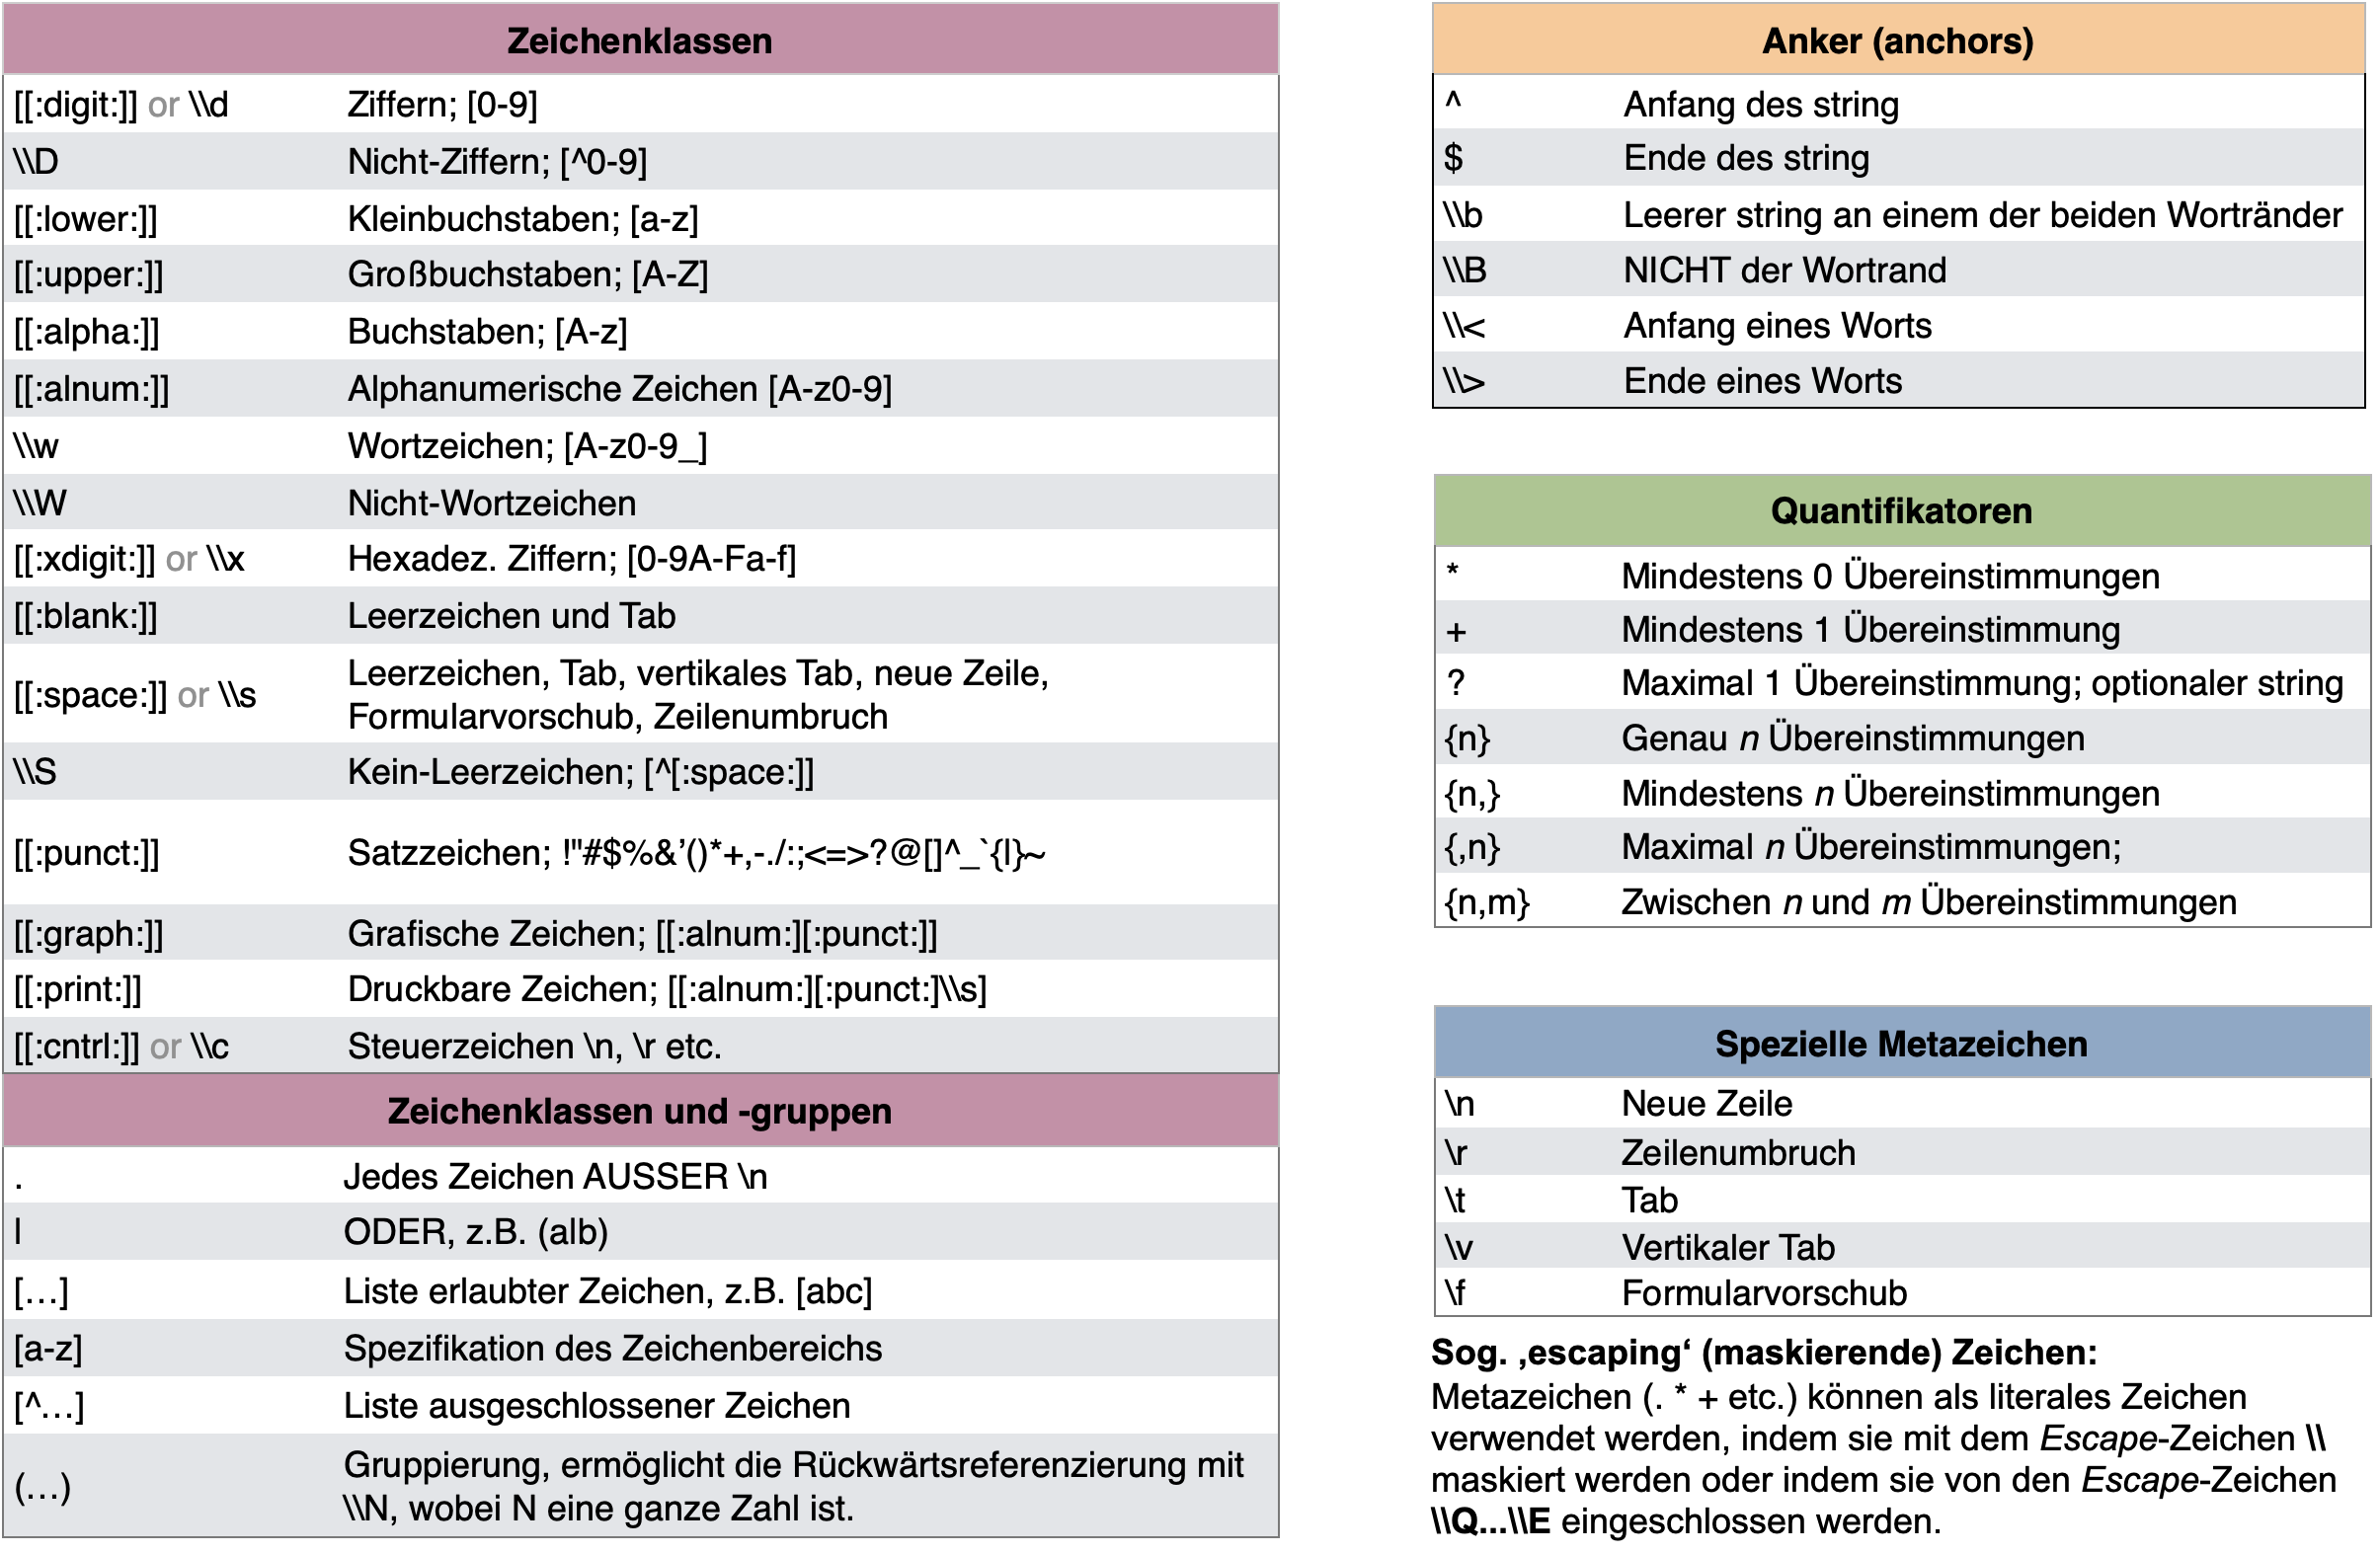
Adaptiert vom RegEx cheatsheet von Ian Kopacka.
Your turn …
Quiz 4-5 | Strings
Q4
x[1] "Placement in the"
[2] "genus is provisional pending"
[3] "the discovery of juvenile specimens."y <- ...(x)Q6
Bedingungen
Bedingungen | Typ 3: ifelse()
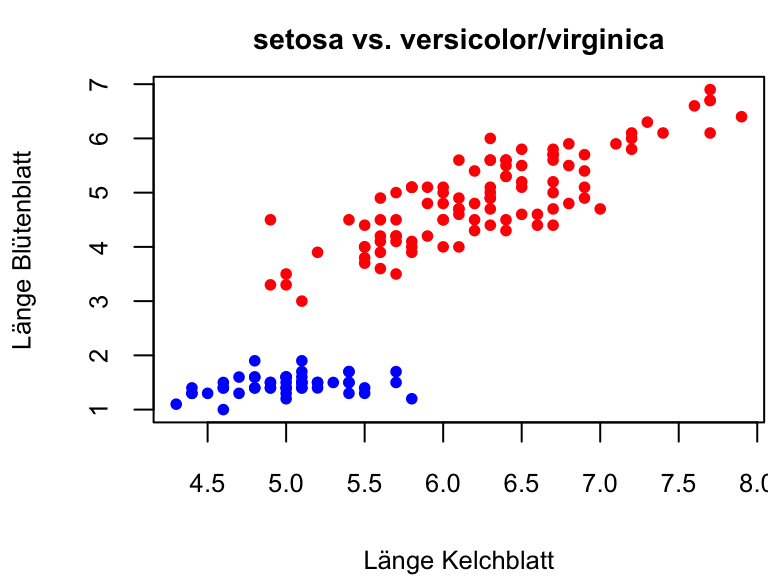
→ ifelse() erzeugt hier nicht eine Farbe, sondern einen Farbvektor mit einem Eintrag pro Datenpunkt: wenn ‘setosa’, dann “blue”, ansonsten “red”.
Your turn …
Quiz 6-7 | Bedingungen
Q6
Der Körper einer Bedingung (wie auch Schleife und Funktion) wird immer in geschweifte Klammern gesetzt, damit er über mehrere Zeilen gehen kann.
In der Abfrage muss ein Operator stehen, welcher die Abfrage wahr macht, denn der Codeblock in der Bedingung wird ja ausgeführt. Richtig ist daher:
Q7
Anhand der zweimaligen geschweiften Klammern wird deutlich, dass es sich um eine ‘if..else..’ Bedingung handelt.
An der Ausgabe 0 ist zu erkennen, dass der Alternativbefehl (in ‘else’) ausgeführt wurde. In die zweite Lücke muss daher ein Operator, bei dem die Abfrage FALSE ergibt:
Schleifen & Simulationen
Schleifen
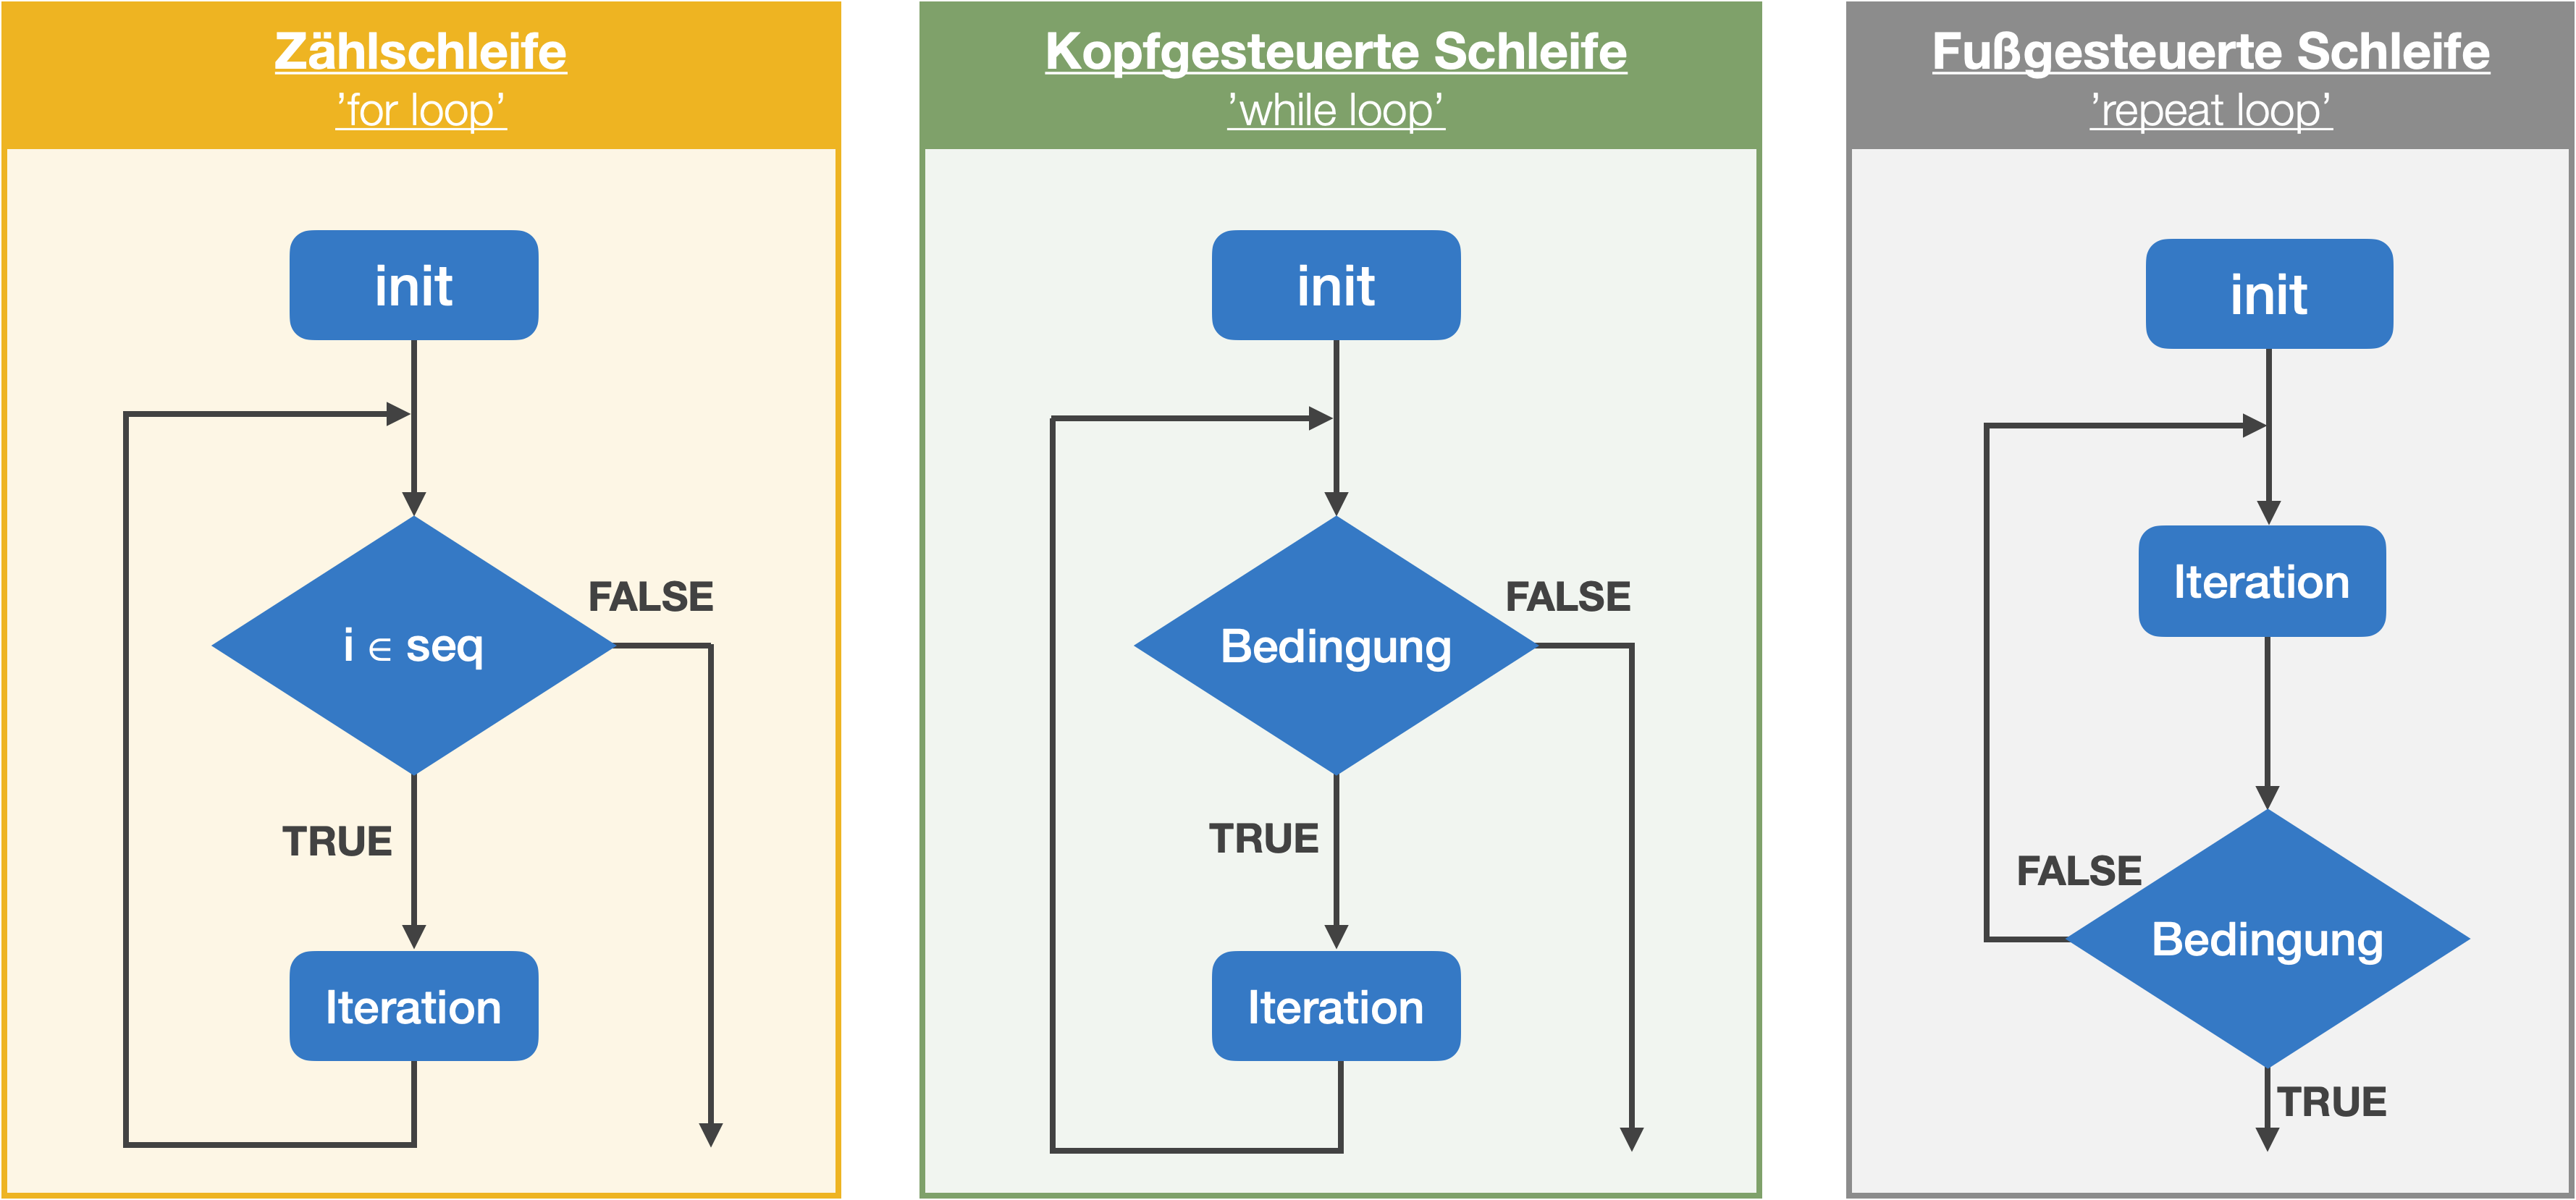
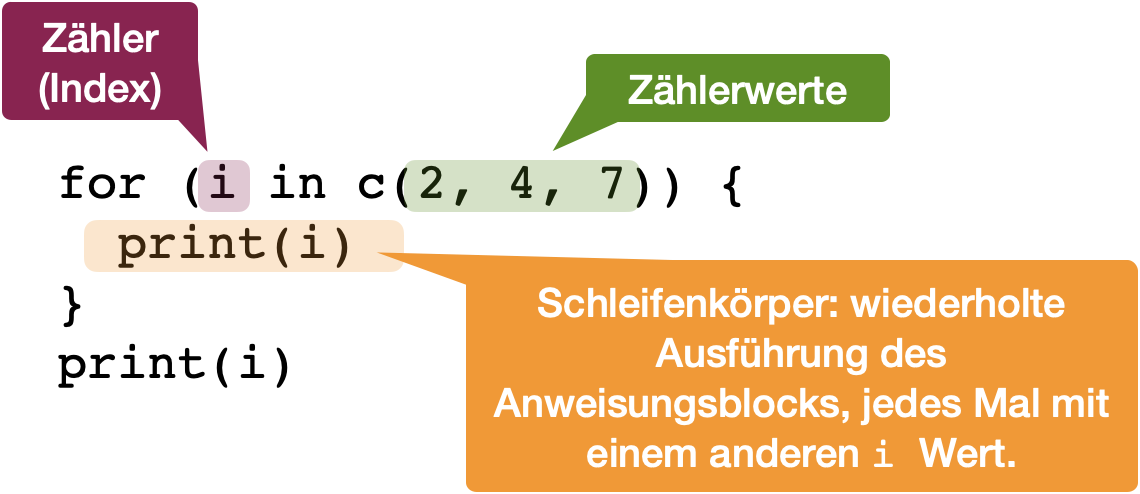
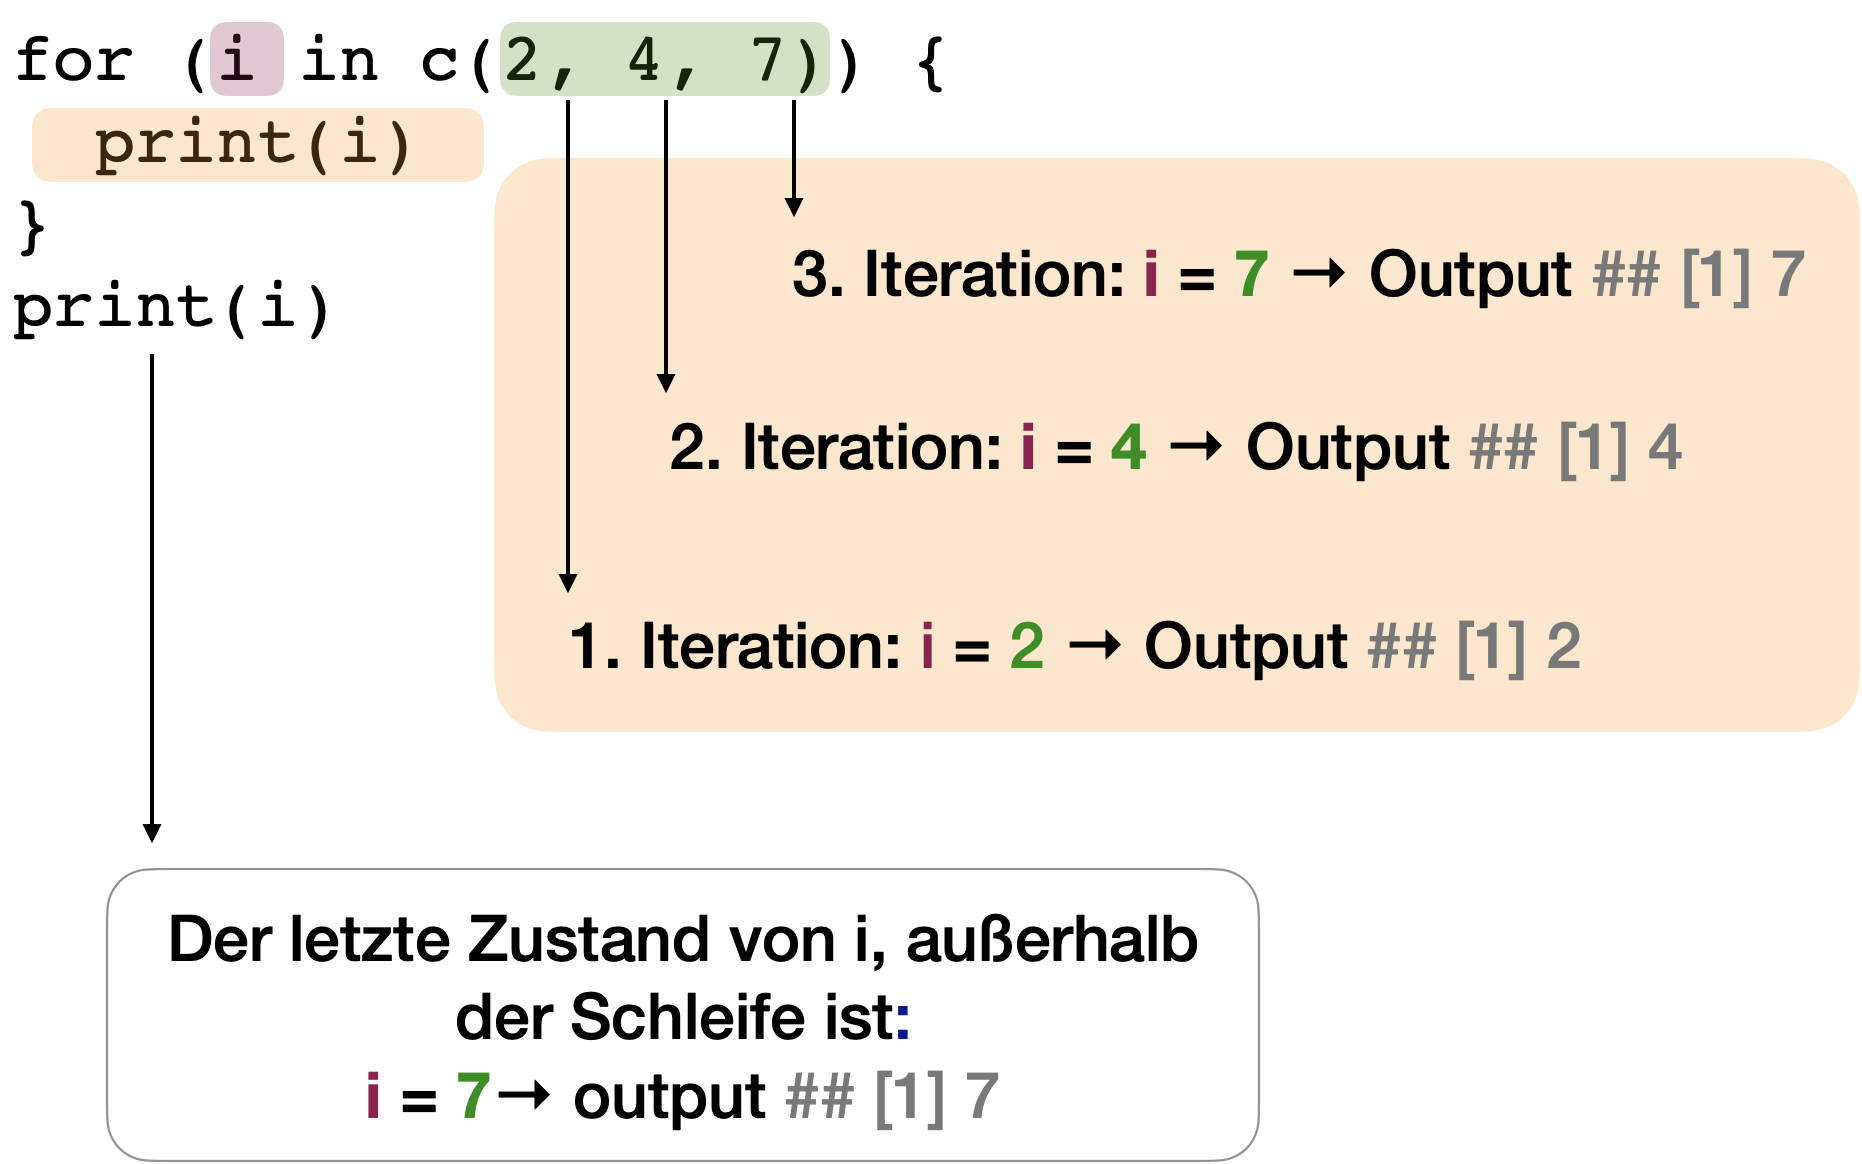
Eine Schleife enthält Code (den Schleifenkörper), der wiederholt ausgeführt wird. So muss der Code nicht zehnmal geschrieben werden, wenn er zehnmal ausgeführt werden soll. Schleifen können beliebig verschachtelt werden.
Schleifen
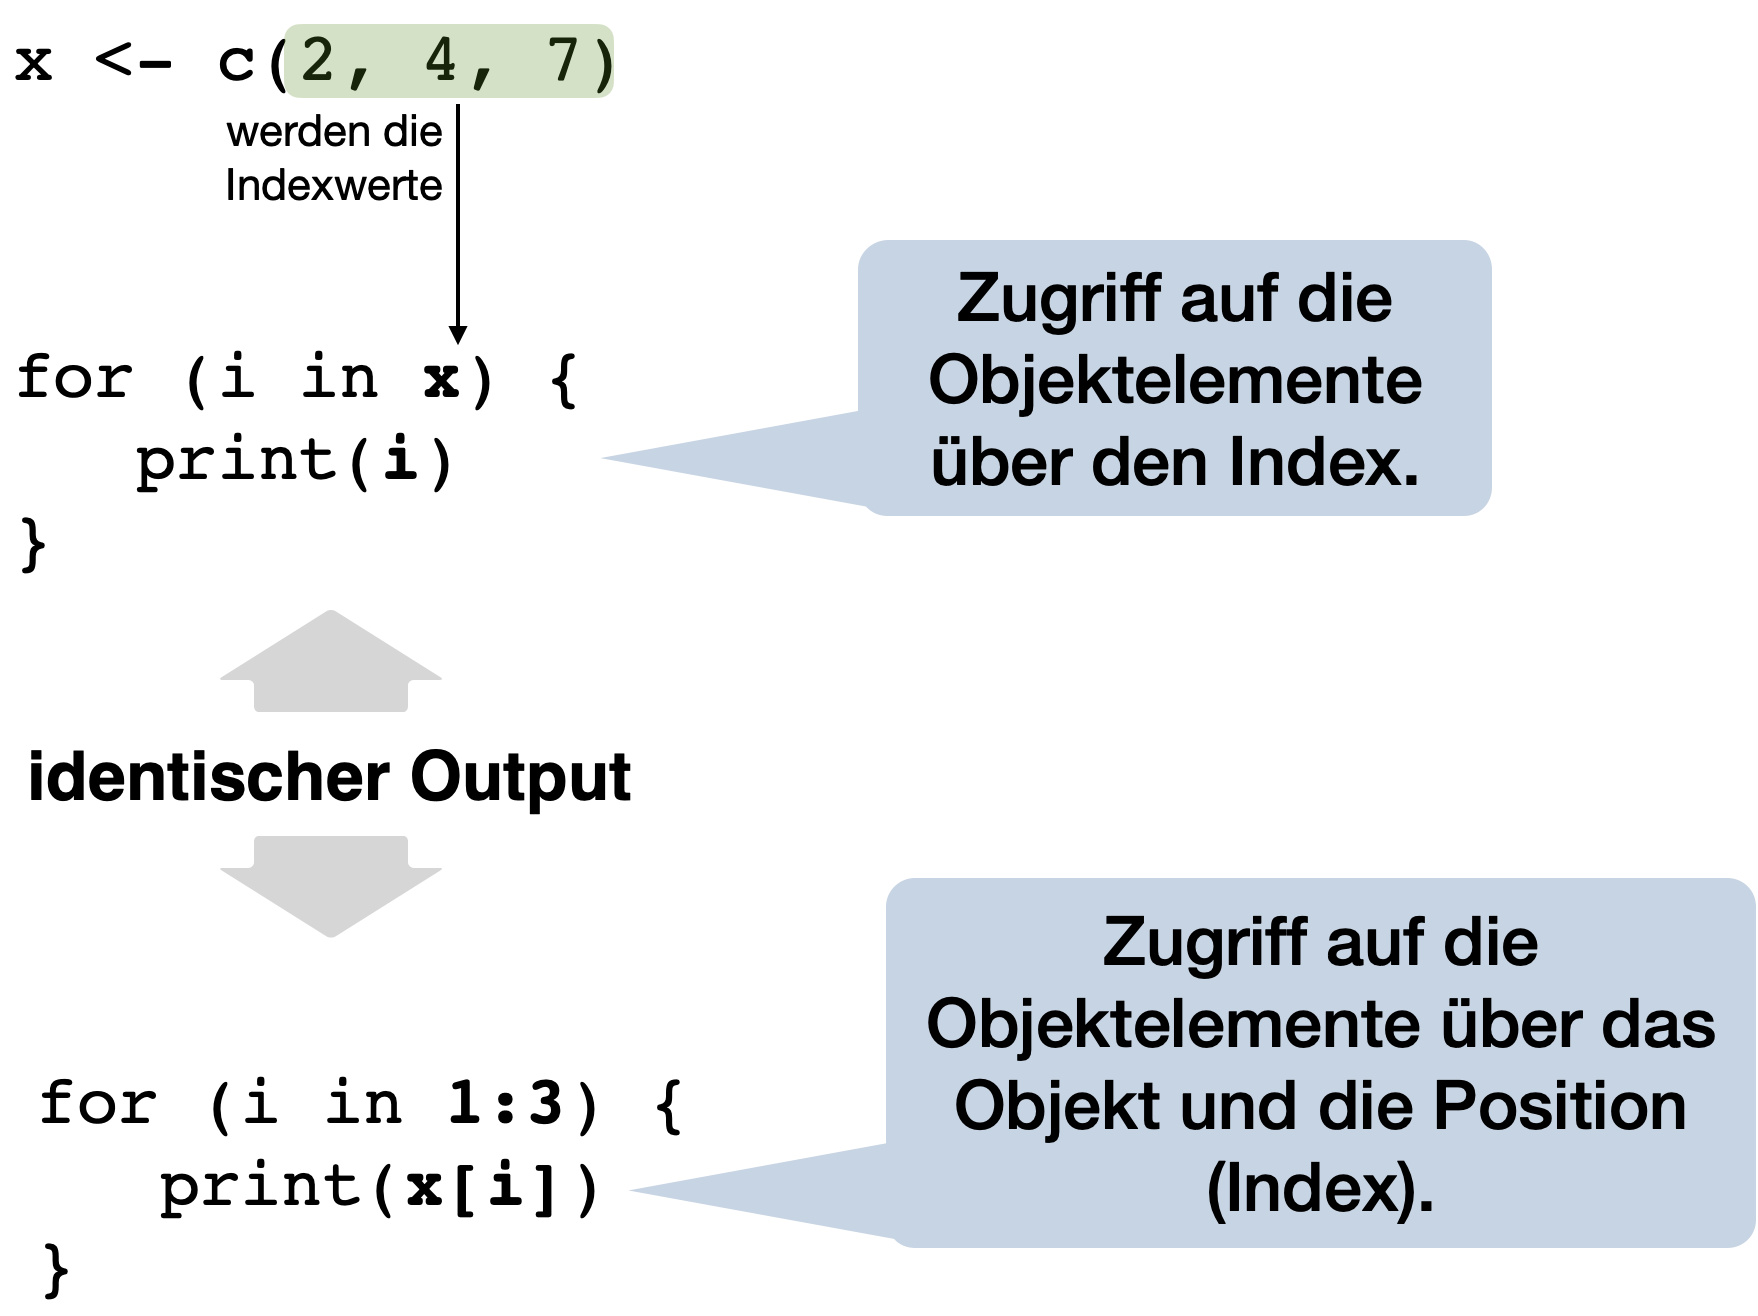
- Zählschleifen (
for): führen eine bestimmte Anzahl an Wiederholungen aus, die durch einen Zähler kontrolliert wird. - Kopf- (
while) bzw. fußgesteuerte Schleifen (repeat): laufen, solange eine logische Bedingung erfüllt ist. Achtung: Ändert sich die Bedingung nie, entsteht eine Endlosschleife!
for Schleife | Struktur 1
for Schleife | Struktur 2
for Schleife | Stile
Anwendungsbeispiel
Einlesen vieler Dateien

 [1] "file_001.csv" "file_002.csv" "file_003.csv" "file_004.csv" "file_005.csv"
 [6] "file_006.csv" "file_007.csv" "file_008.csv" "file_009.csv" "file_010.csv"
Import aller 10 Dateien und Zusammenführung zu EINEM Dataframe
# Leere Liste für die importierten Datensätze
data_list <- vector("list", length = length(files))

# Schleife, bei der in jeder Iteration eine Datei importiert wird
for (i in seq_along(files)) {
  data_list[[i]] <- read.csv(files[i])
}

# Zusammenfügen der einzelnen Dataframes in der Liste
data_df <- dplyr::bind_rows(data_list)'data.frame': 200 obs. of 3 variables:
$ station: chr "A" "A" "A" "A" ...
$ x : int 40 24 23 12 46 48 34 35 36 41 ...
$ y : num 28.93 14.49 1.67 9.51 20.64 ...# A tibble: 10 × 2
# Groups: station [10]
station n
<chr> <int>
1 A 20
2 B 20
3 C 20
4 D 20
5 E 20
6 F 20
7 G 20
8 H 20
9 I 20
10 J 20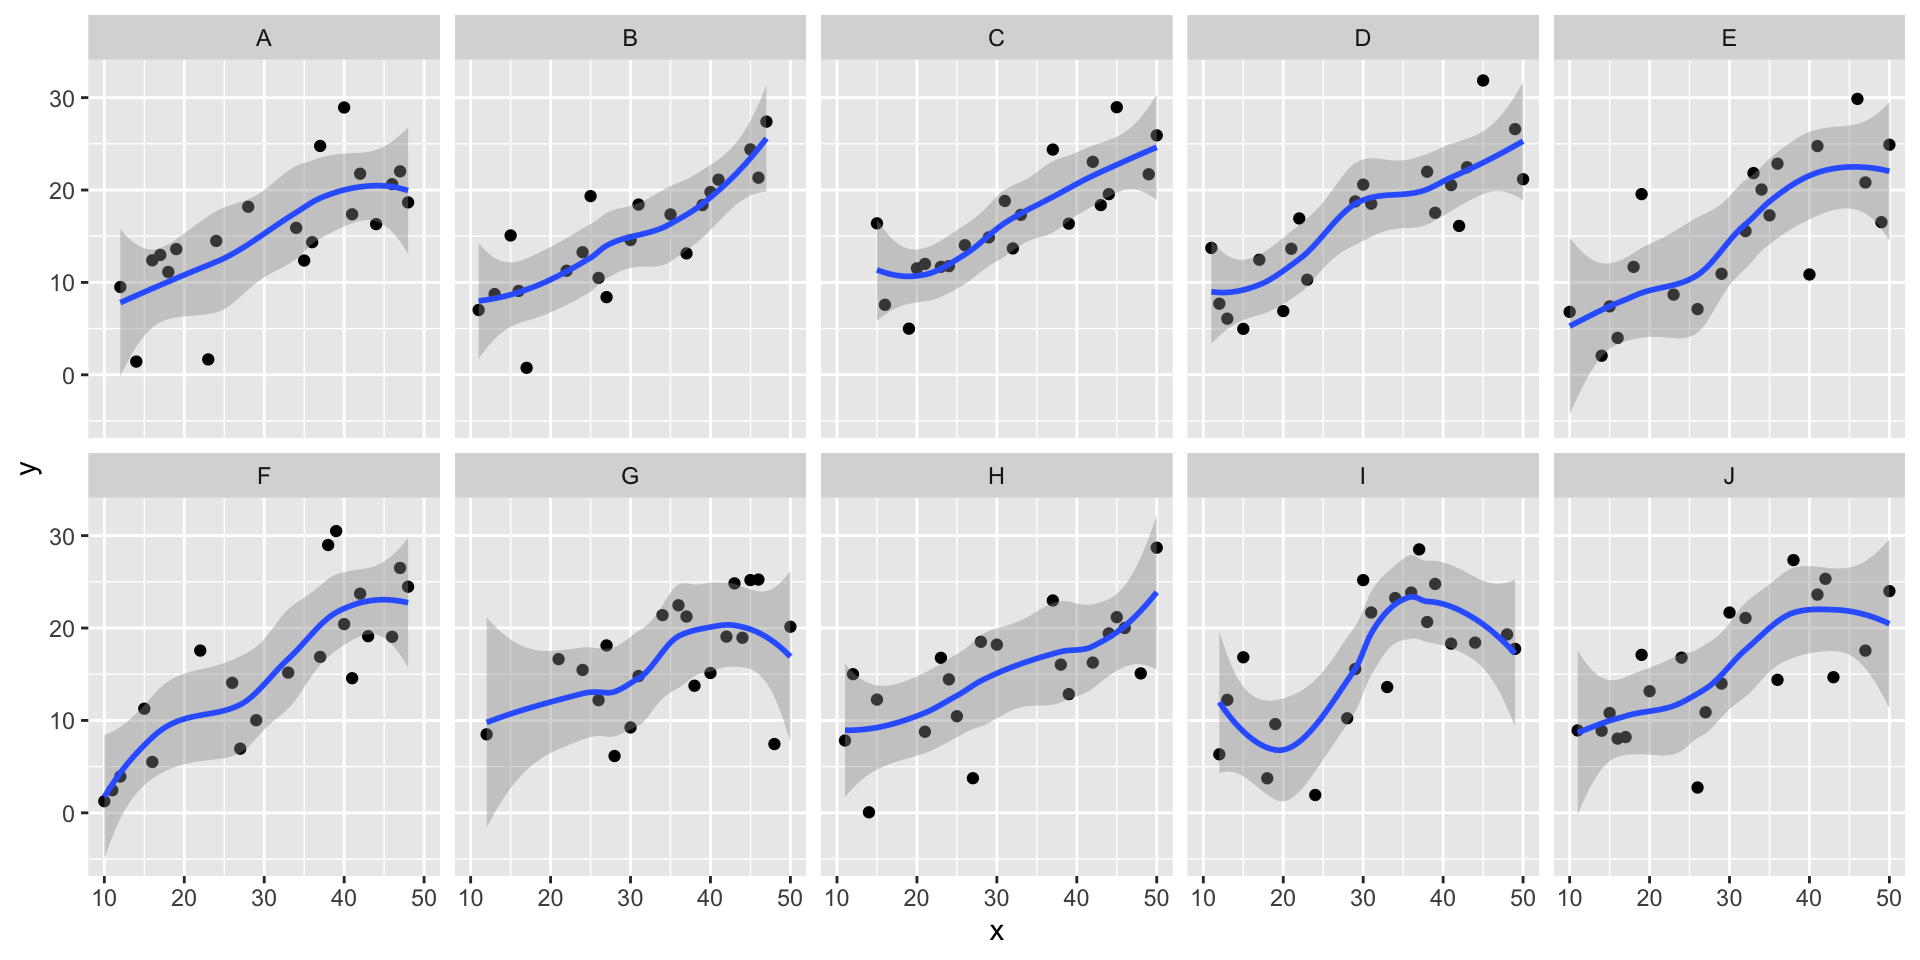
Your turn …
Quiz 8-9 | Schleifen
Q8
Q9
Hier ist keine Abfrage zu sehen, sondern es wird jeweils ein Zähler definiert. Also muss es sich um die Zählschleife (‘for..’) handeln, und zwar um 2 ineinander verschachtelte. Wichtig ist hierbei, dass der Zähler unterschiedlich ist: Die erste Schleife hat meist den Index i, die nächste j, usw.
Im innersten Schleifenkörper werden die beiden Indizes mit paste() und dem Trennzeichen ‘/’ zusammengefügt. Damit dies in der Konsole sichtbar ist, braucht es die Funktion print().
Eigene Funktionen
Komponenten von Funktionen
Eine Funktion ist eine Sammlung von Code, die jederzeit über ihren Namen aufgerufen werden kann. Funktionen strukturieren die Arbeit und unterteilen komplexe Probleme in kleine, einfache Einheiten.
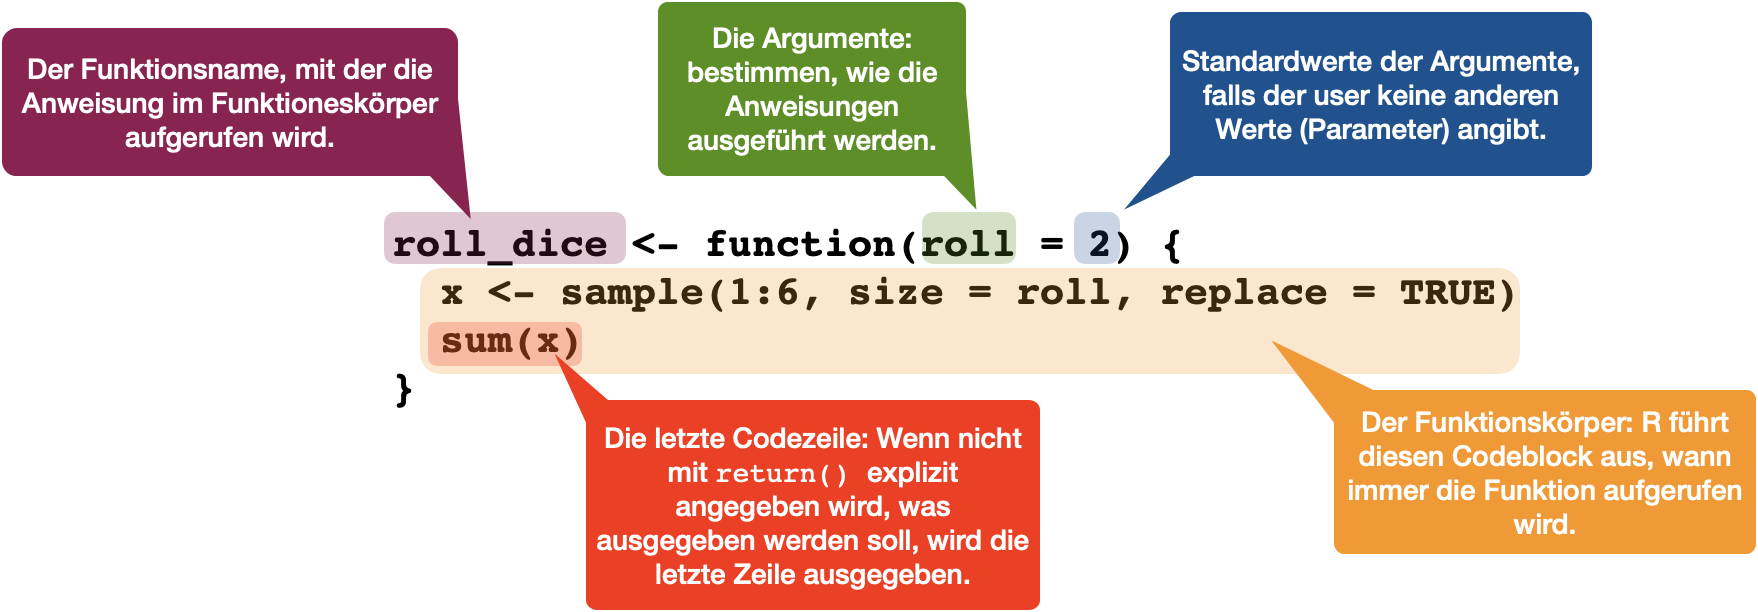
Funktion zur Berechnung der Schiefe | 1
\[g_1 = \frac{\frac{1}{n}\sum\limits_{i=1}^{n}\left(x_i - \bar{x}\right)^3} {\left(\frac{1}{n}\sum\limits_{i=1}^{n}\left(x_i - \bar{x}\right)^2\right)^{3/2}}\]
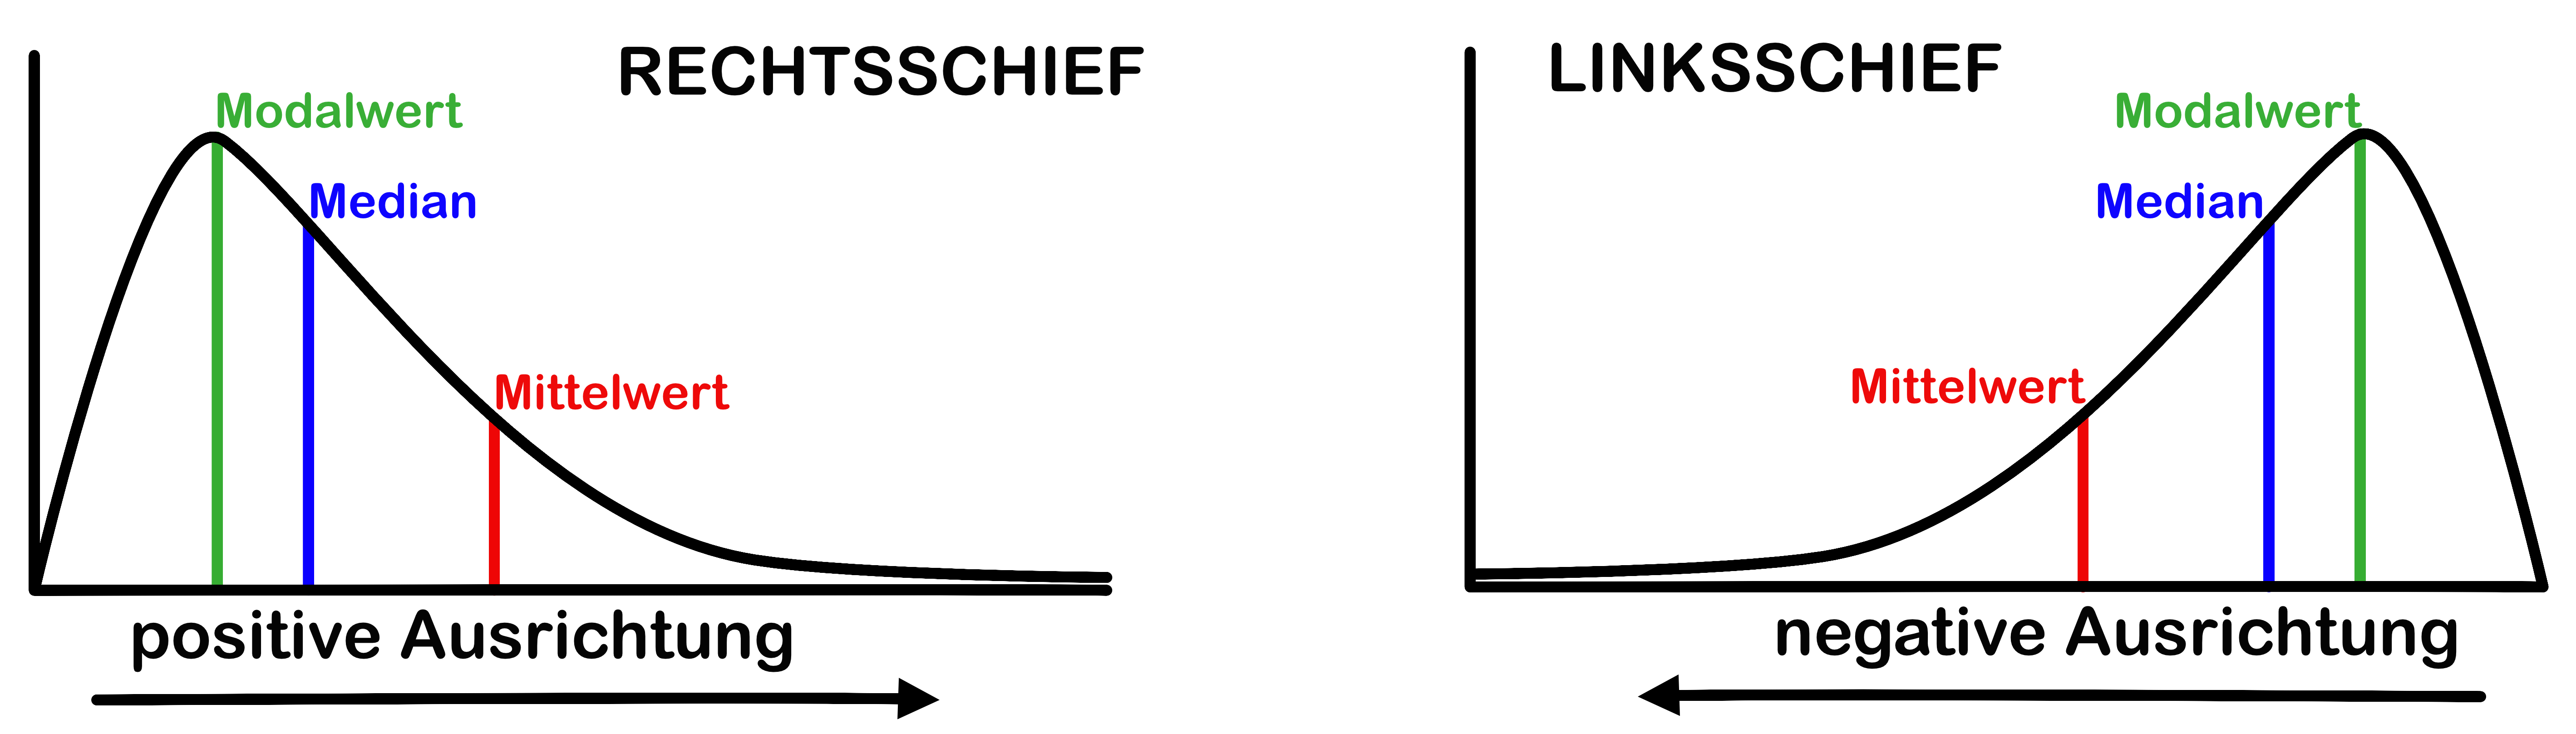
Eine Funktion gibt immer nur ein Objekt zurück. Sollen mehrere Ergebnisse ausgegeben werden, fassen Sie diese mit list() zu einem Listenobjekt zusammen, z.B. return(list(mean = m, sd = s)).
Your turn …
Quiz 10 | Funktionen
Eine Funktion wird mit function() definiert. Sie sollte nicht auf Objekte zugreifen, die nicht innerhalb der Funktion definiert oder als Argument übergeben werden. Hier wird auf x und y zugegriffen, daher müssen diese als Argumente definiert werden (function(x, y)). Das berechnete Produkt z wird explizit mit return(z) ausgegeben.
Funktionale Programmierung
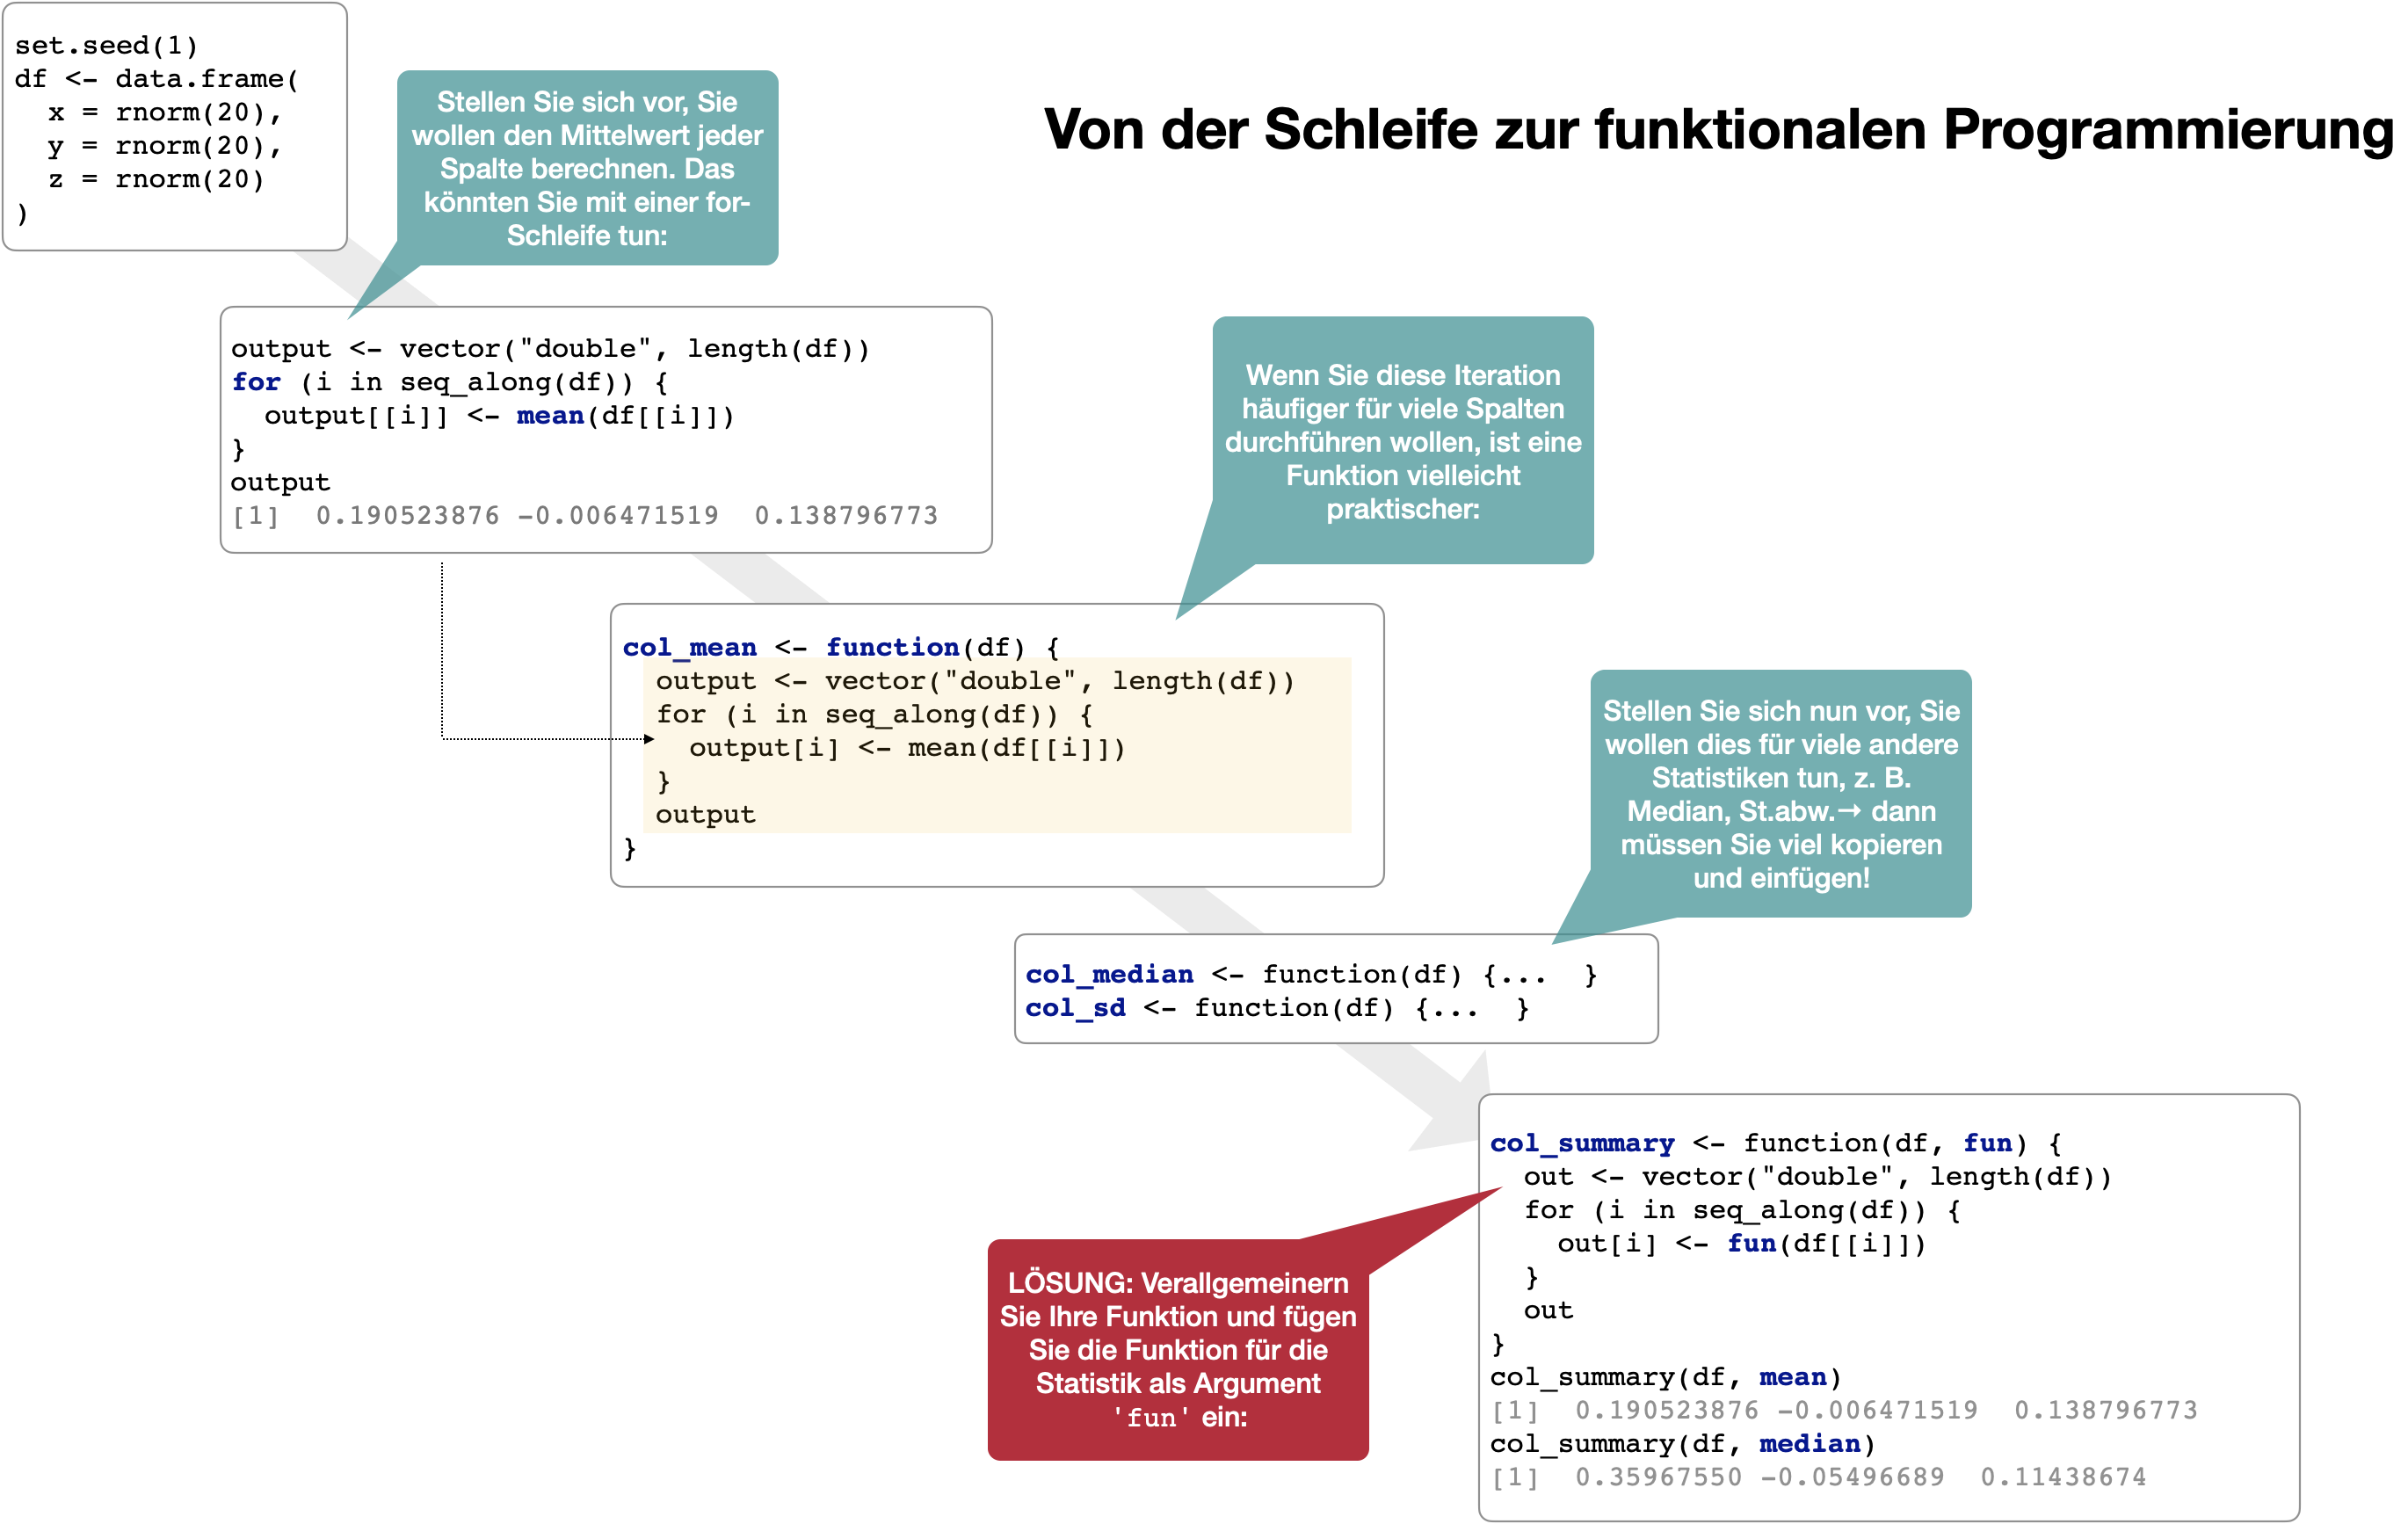
Von der Schleife zur funktionalen Programmierung
- R ist eine funktionale Programmiersprache:
forSchleifen lassen sich in eine Funktion packen, der man dann eine andere Funktion als Argument übergibt. - Das reduziert Code, ‘copy & paste’-Fehler und macht den Code leichter verallgemeinerbar.
apply-Familie und das Paket purrr
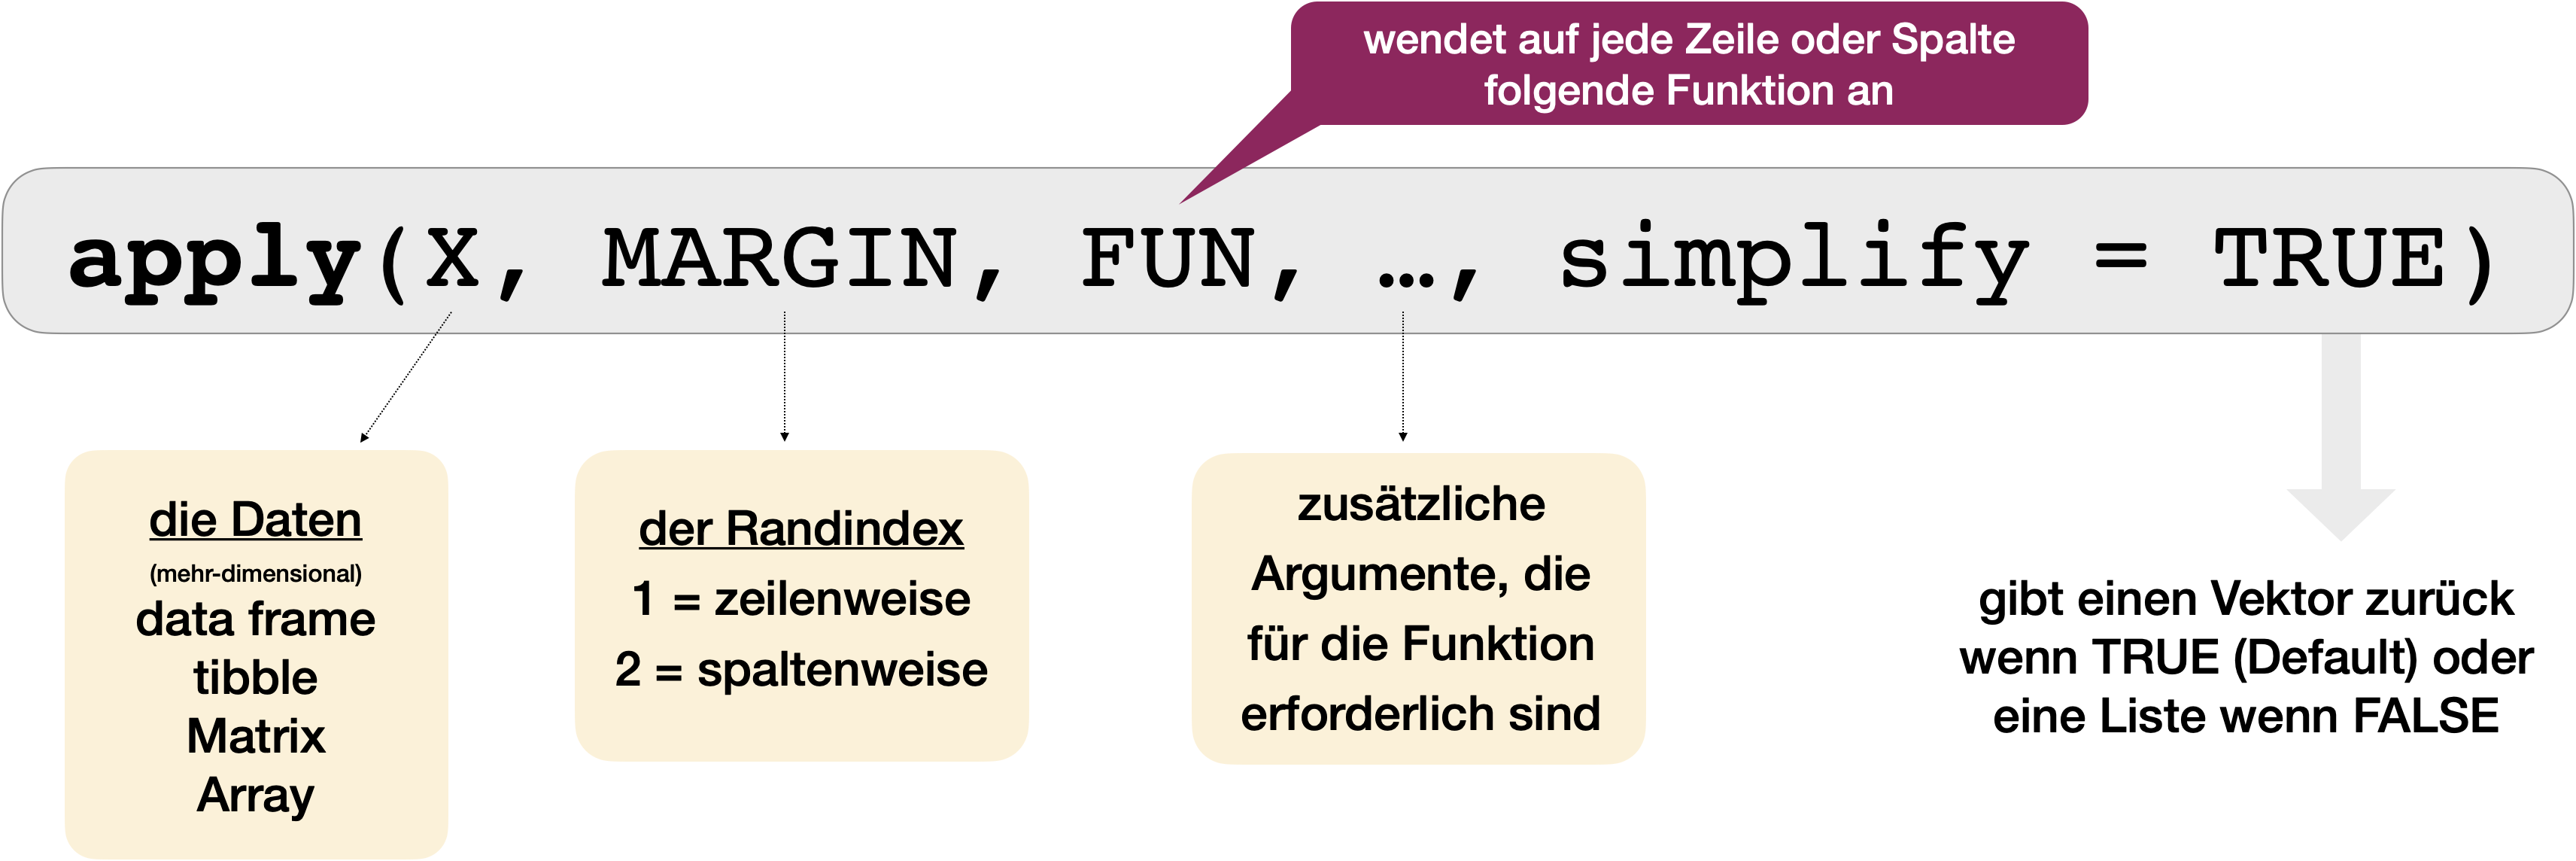
Die ‘*apply’ Familie in base R (apply(), lapply(), sapply(), …) und die ‘map’ Familie im tidyverse-Paket purrr wenden eine Funktion auf jedes Element einer Liste, jede Spalte eines Datensatzes usw. an – ohne eine Schleife schreiben zu müssen:
base R
Übungen
Optionale swirl-Lektionen zur Vertiefung

Kurs DS1-05-Handling spezieller Datentypen
- L01-Faktoren
- L02-Faktoren_und_das_forcats_Paket
- L03-Datum_und_Zeit_in_R
- L04-Datum_Zeit_und_das_lubridate_Paket
- L05-Grundfunktionen_zur_Textmanipulation
- L06-Zeichenketten_und_das_stringr_Paket
- L07-Textmanipulation_und_regulaere_Ausdruecke
Kurs DS1-06-Fortgeschrittene R Programmierung
- L01-Dateihandling aus R heraus
- L02-Bedingungen
- L03-Eigene Funktionen schreiben
- L04-Schleifen und erste Simulationen
- L05-FizzBuzz
- L06-Funktionales Programmieren mit apply Funktionen
Übungsaufgaben Woche 13
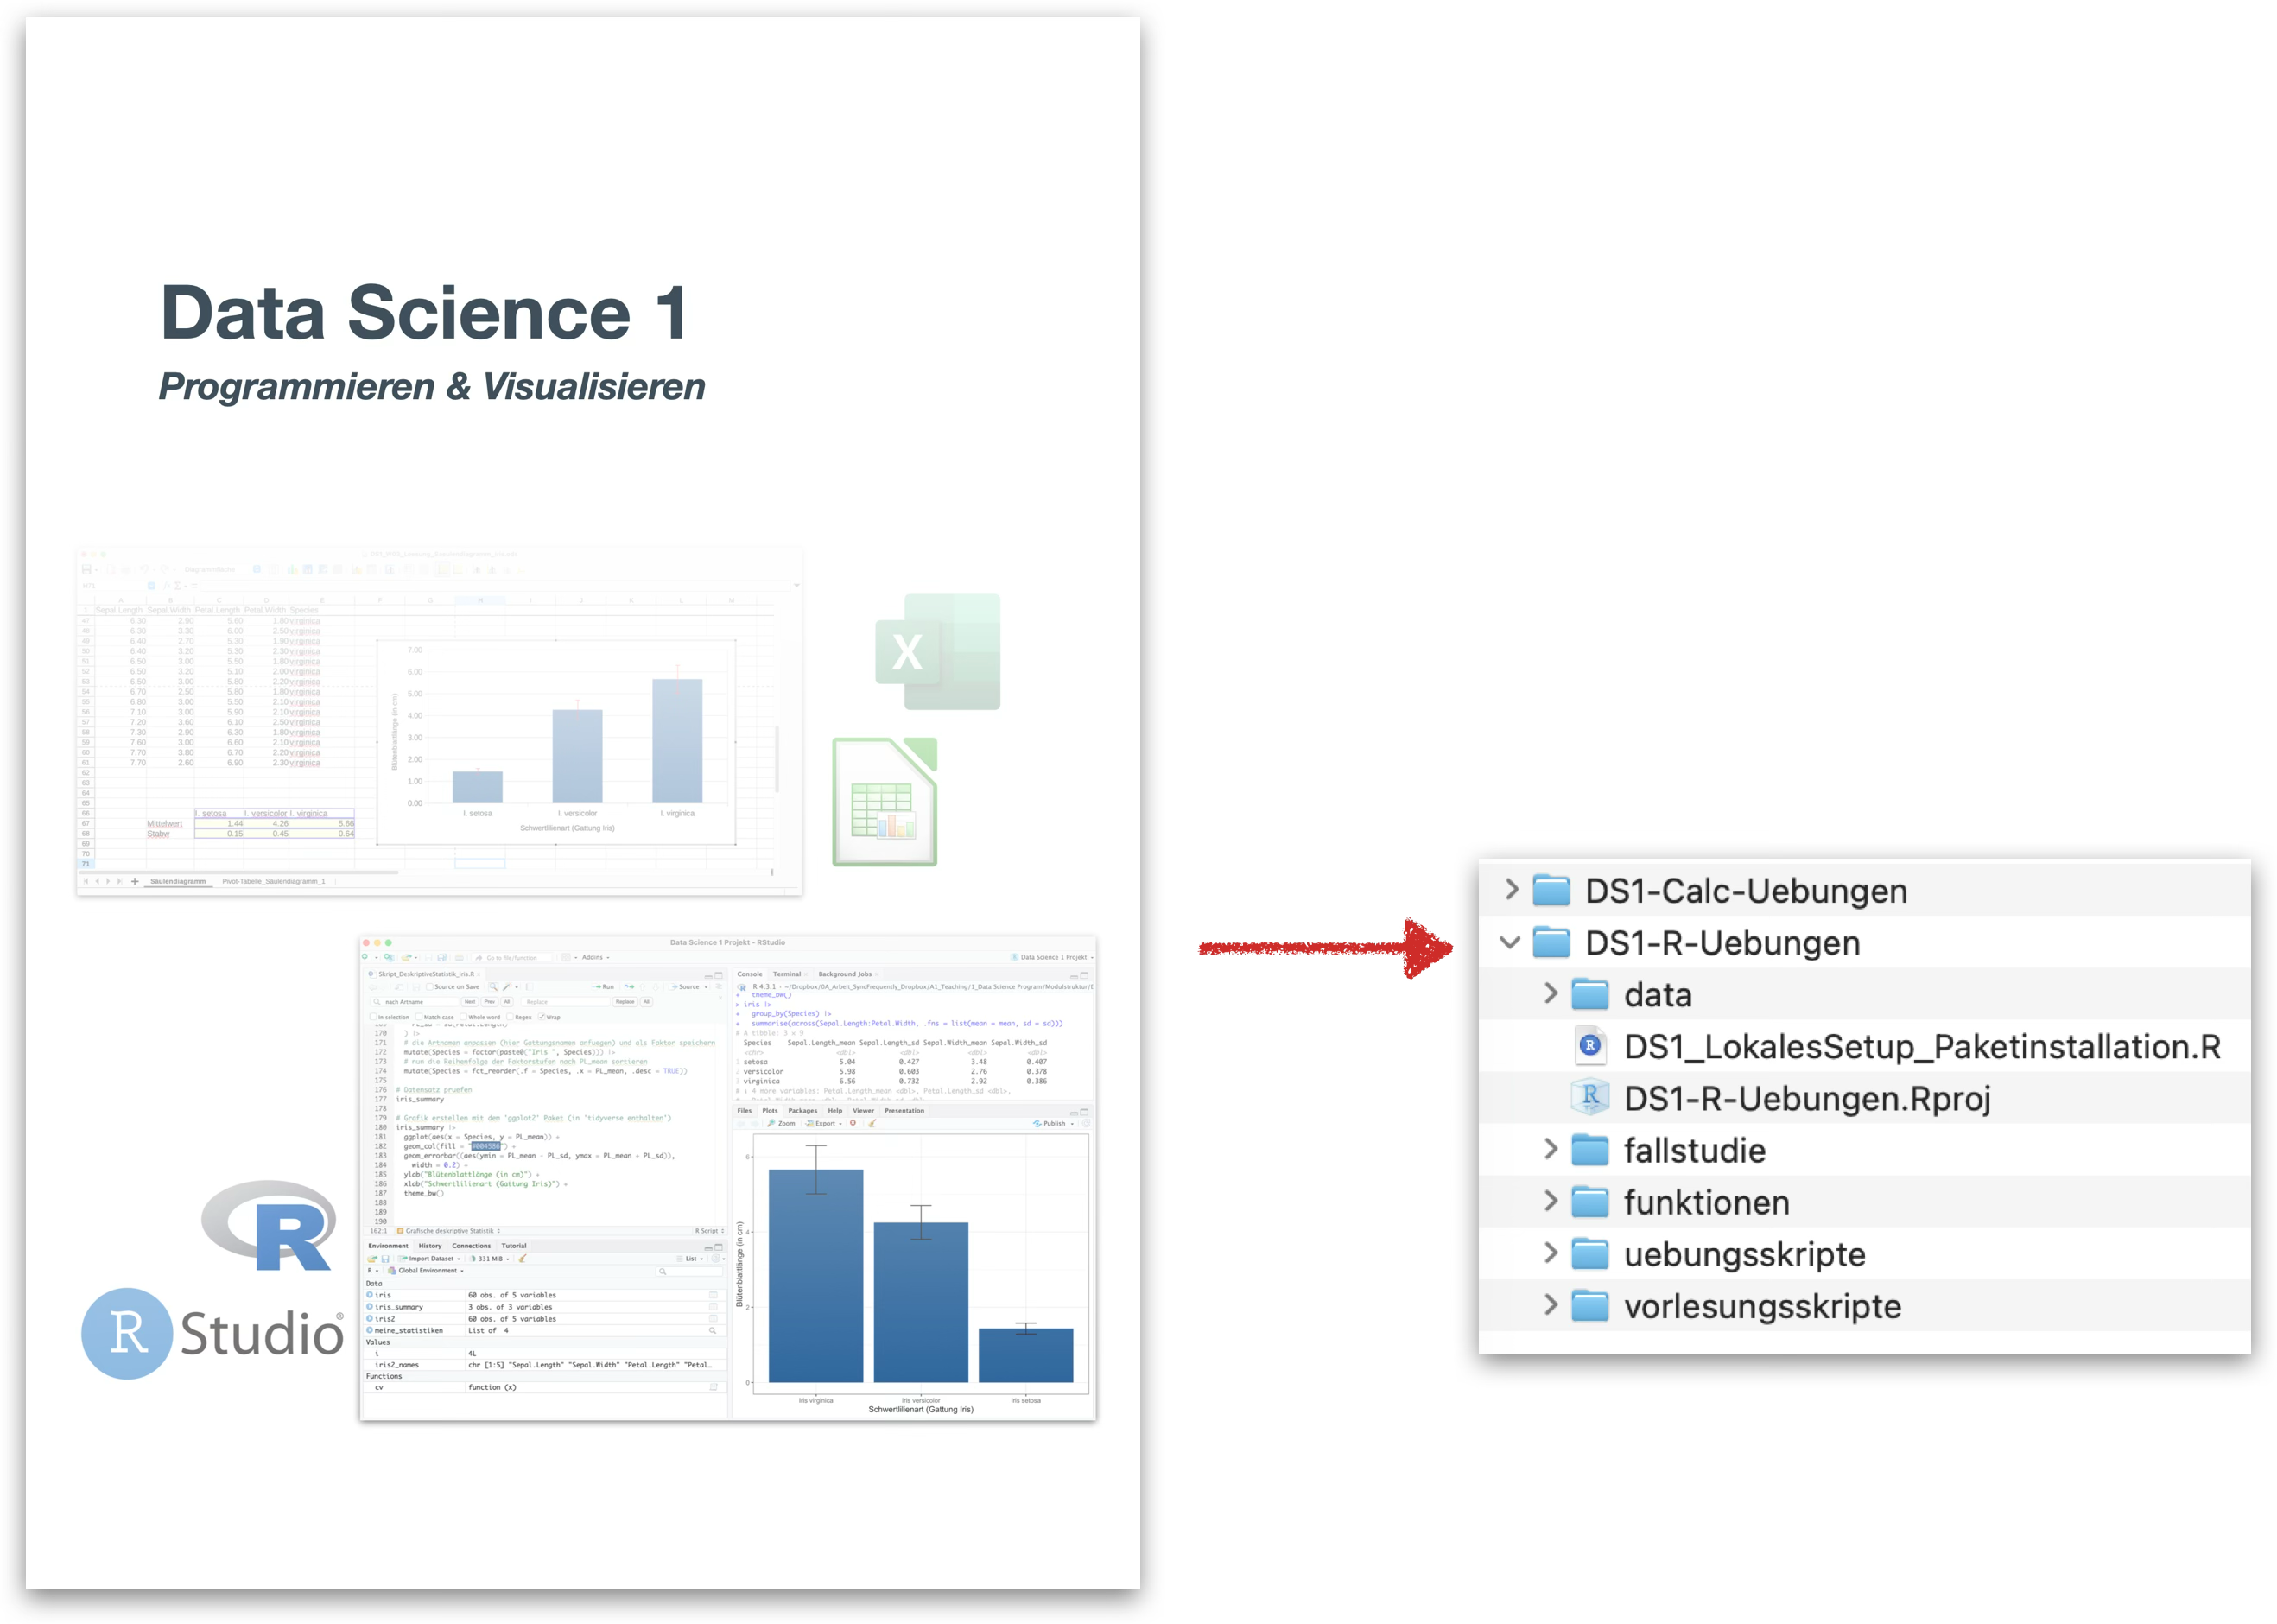
Alle Aufgaben der Übungswoche finden Sie im Handbuch:
- die zu bearbeitenden Übungsskripte
- die (optionalen) swirl-Lektionen und
- den aktuellen Stand der Fallstudie.
- Die Übungsskripte und Daten liegen in Ihrem R-Projektordner DS1-R-Uebungen (Unterordner uebungsskripte bzw. data).
- Öffnen Sie immer zuerst die Projektdatei DS1-R-Uebungen.Rproj, dann stimmen alle Dateipfade.
Wie fühlen Sie sich jetzt…?
Total konfus?
Dann empfehle ich Ihnen:
- Die Kapitel in ‘R for Data Science’ (2. Auflage) zu Faktoren, Datum und Zeit, Strings und regulären Ausdrücken sowie zu Funktionen und Iterationen.
- Zum Üben regulärer Ausdrücke die Webseite www.regular-expressions.info.
- Die Posit Cheatsheets zu forcats, lubridate, stringr und purrr.
- Wer tiefer in Funktionen einsteigen möchte: das Buch Advanced R von Hadley Wickham.
Total gelangweilt?
Dann testen Sie doch Ihr Wissen in folgendem Abschlussquiz…
Abschlussquiz
Bei weiteren Fragen: saskia.otto(at)uni-hamburg.de

Diese Arbeit is lizenziert unter einer Creative Commons Attribution-ShareAlike 4.0 International License mit Ausnahme der entliehenen und mit Quellenangabe versehenen Abbildungen.