Datenvisualisierung mit base R und ggplot2
Data Science 1 - Programmieren & Visualisieren
Universität Hamburg, IMF
Wintersemester
Lernziele

Am Ende dieser VL- und Übungseinheit werden Sie
- einfache Diagramme zur Datenexploration mithilfe der R Basisfunktionen erstellen können.
- wissen, wie Grafiken als PDF, JPEG oder PNG Dateien gespeichert werden können.
- das Prinzip der geschichteten Diagrammerstellung in ggplot2 verstanden haben.
- die wichtigsten geom_XXX() Funktionen kennen und anwenden können (Histogramm, Säulendiagramm, Boxplot, Streudiagramm).
- den Unterschied zwischen geom_bar() und geom_col() verstehen.
2 verbreitete Typen
Grafiken mit base R
- Funktionen sind bereits Bestandteil der Basisversion.
- Gut geeignet für eine einfache und schnelle Datenexploration.
- Nicht sehr intuitiv und weniger geeignet für komplexe Grafiken.
- Dokumentation ist vollständig, aber wenig einsteigerfreundlich.
Grafiken mit ggplot2 Paket
- Besser geeignet bei komplexeren Grafiken.
- Klarere Syntax.
- Besser dokumentiert.
- Viele Beispiele im Internet.
Grafiken mit base R
2 Funktionstypen
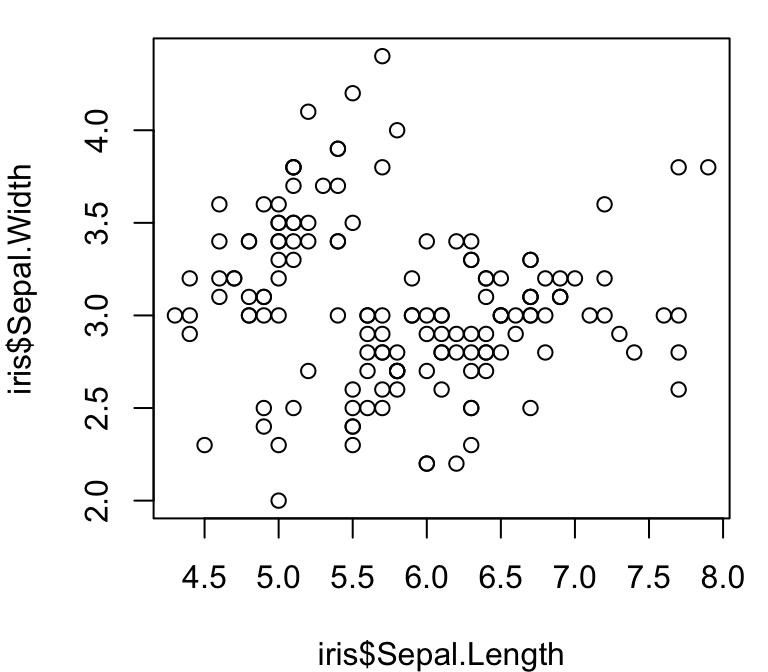
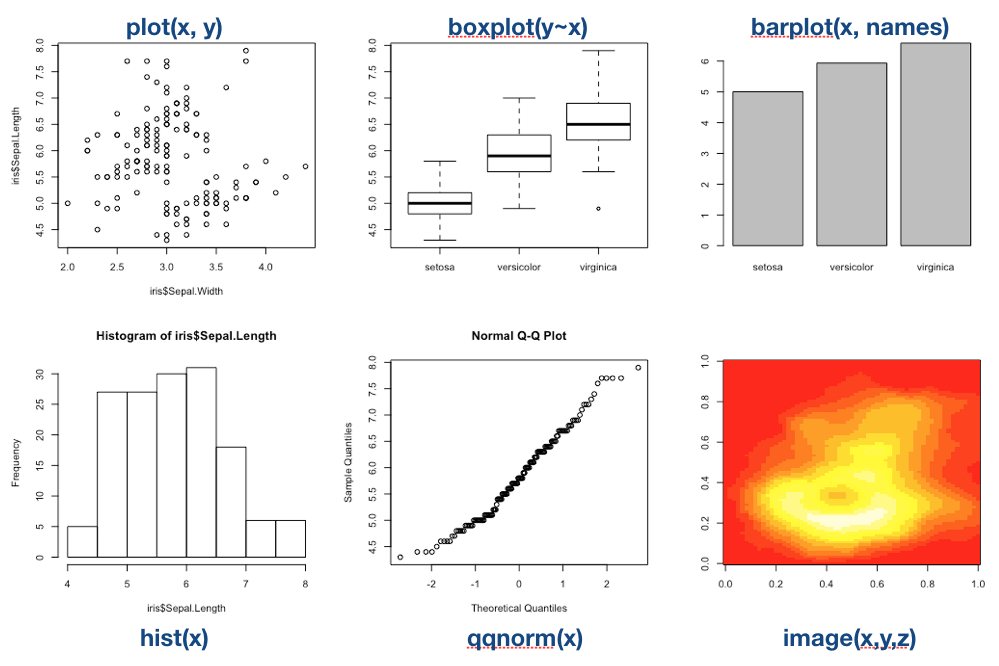
High-level Funktionen | Beispiele
High-level Argumente | Demonstration 1
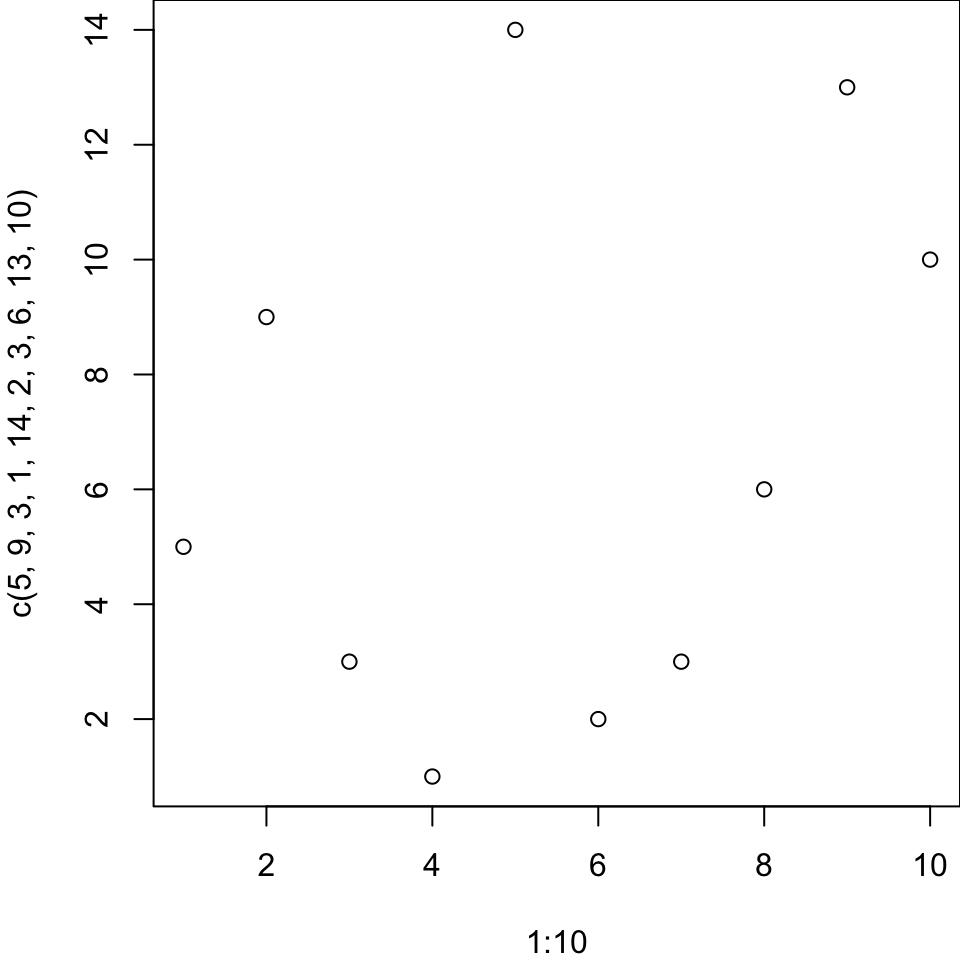
High-level Argumente | Demonstration 2
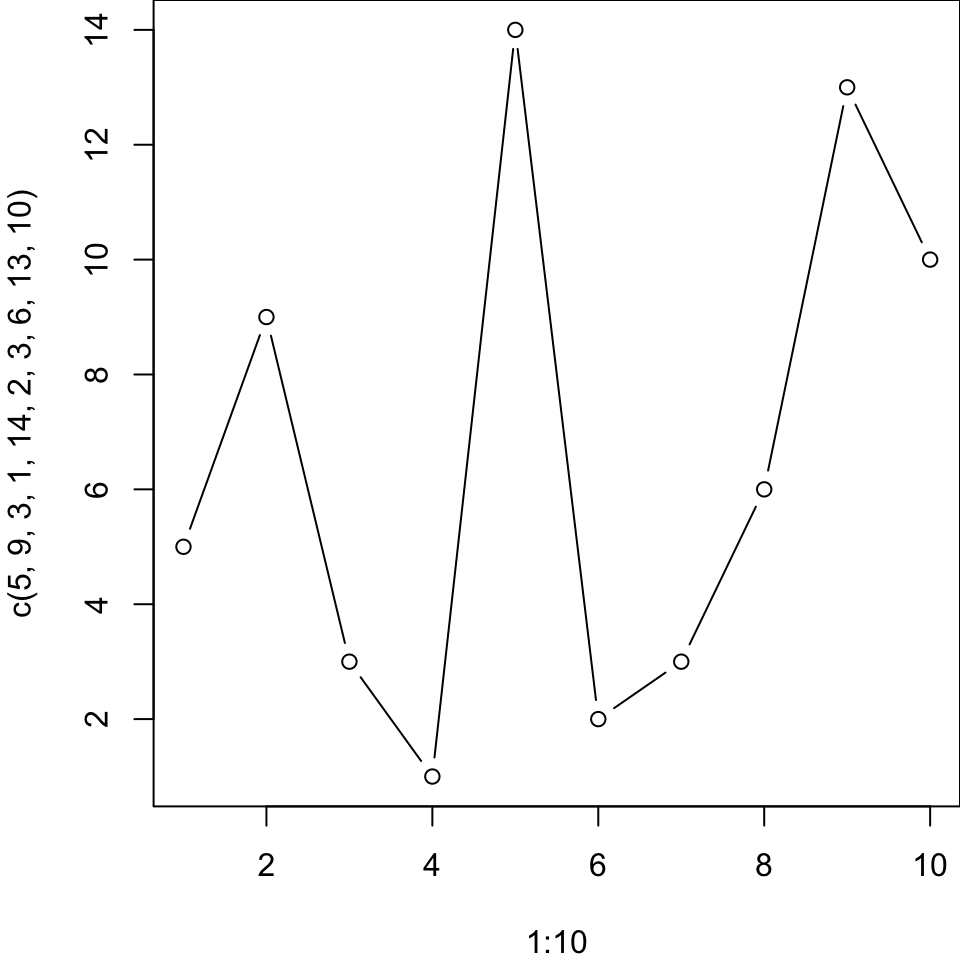
High-level Argumente | Demonstration 3
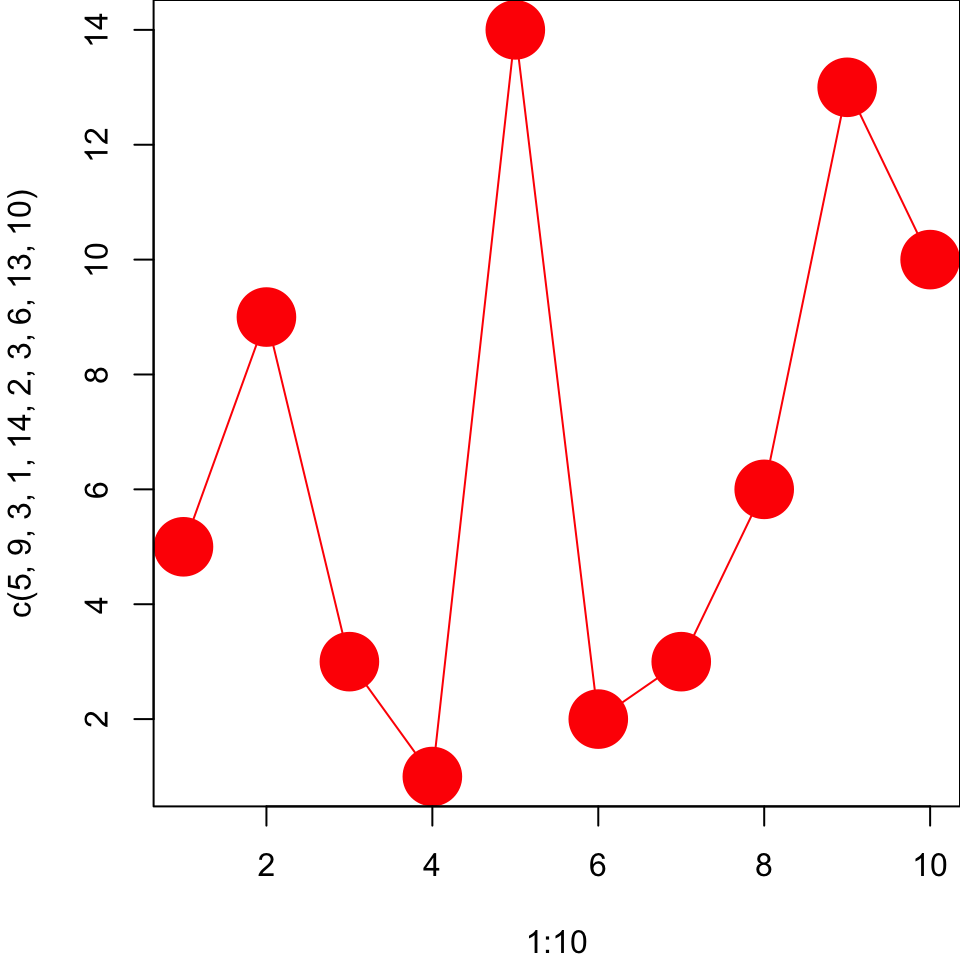
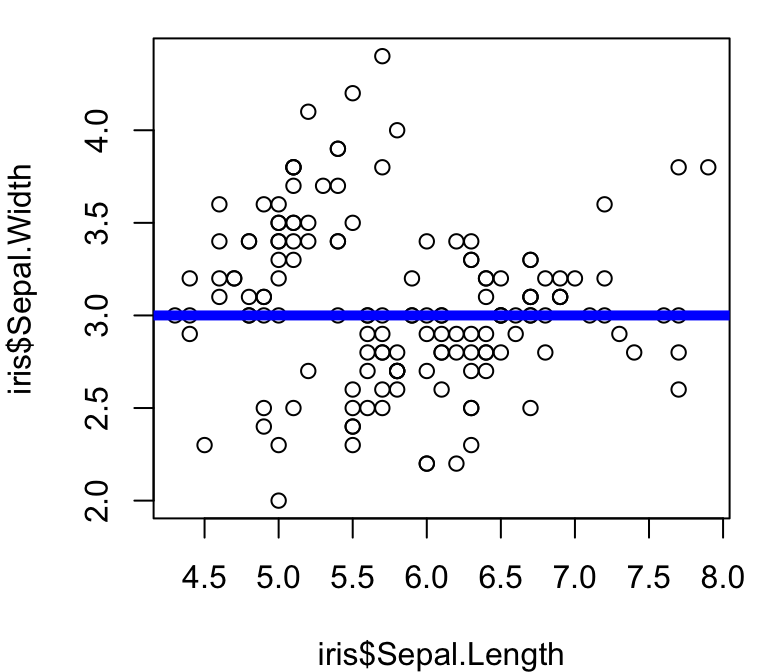
High-level Argumente | Demonstration 4
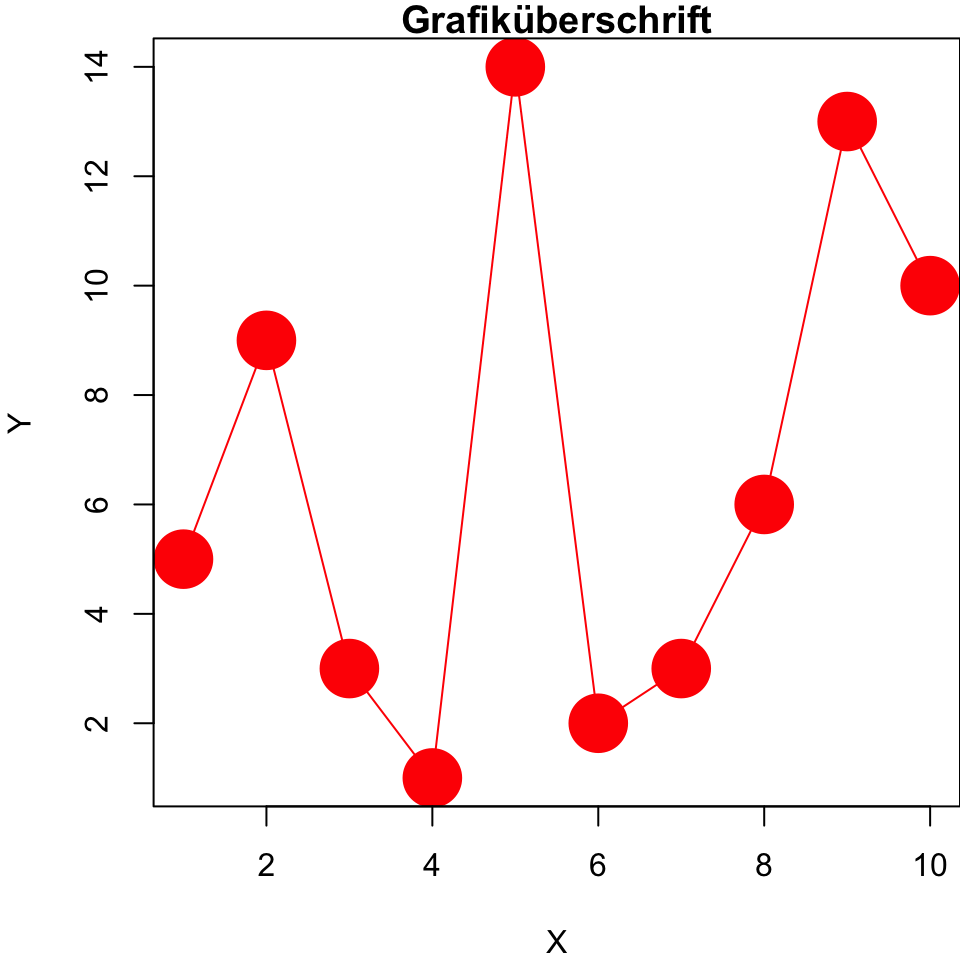
Wo soll die Grafik erscheinen?
Die sog. ‘graphics devices’

Screen device (default) - Fenster im Programm

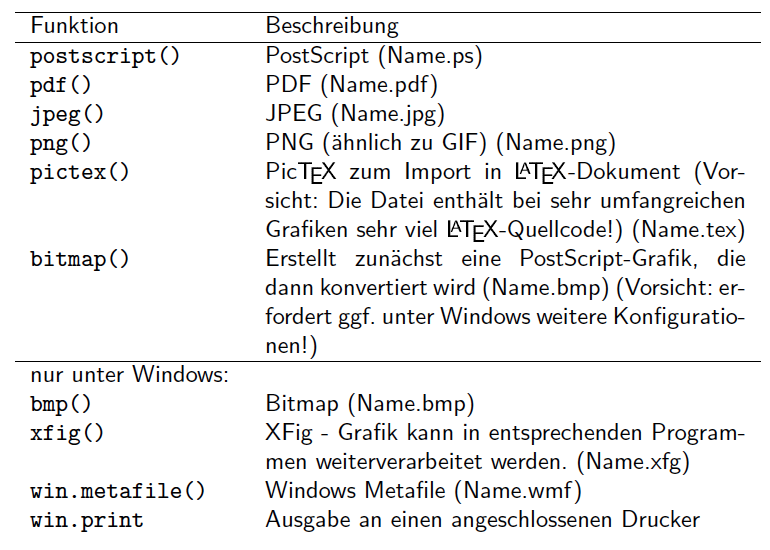
File device - Ausgabeformat als Rasterdatei (JPEG, PNG, TIFF,..) oder Vektordatei (PDF, EPS)
Ausgabeformate und ihre Funktionen
Ein System für kreative Grafiken
- Basierend auf ‘The Grammar of Graphics’.
- Das heutige Fundament für die Erstellung von Diagrammen in R nach dem visual encoding Prinzip
- Sehr gute Dokumentation.
- https://ggplot2.tidyverse.org
- Übersicht aller ggplot2 Funktionen gibt es auf https://ggplot2.tidyverse.org/reference/
- RStudio/Posit cheatsheet
- komplettes Buch (Onlineversion)
- Eine steigende Anzahl von Erweiterungen, die von ‘R Usern’ in der R Gemeinschaft entwickelt wurden: https://exts.ggplot2.tidyverse.org/
Galerie der ggplot2 Erweiterungen

Weblink: https://exts.ggplot2.tidyverse.org
Umsetzung des visual encoding in ggplot2
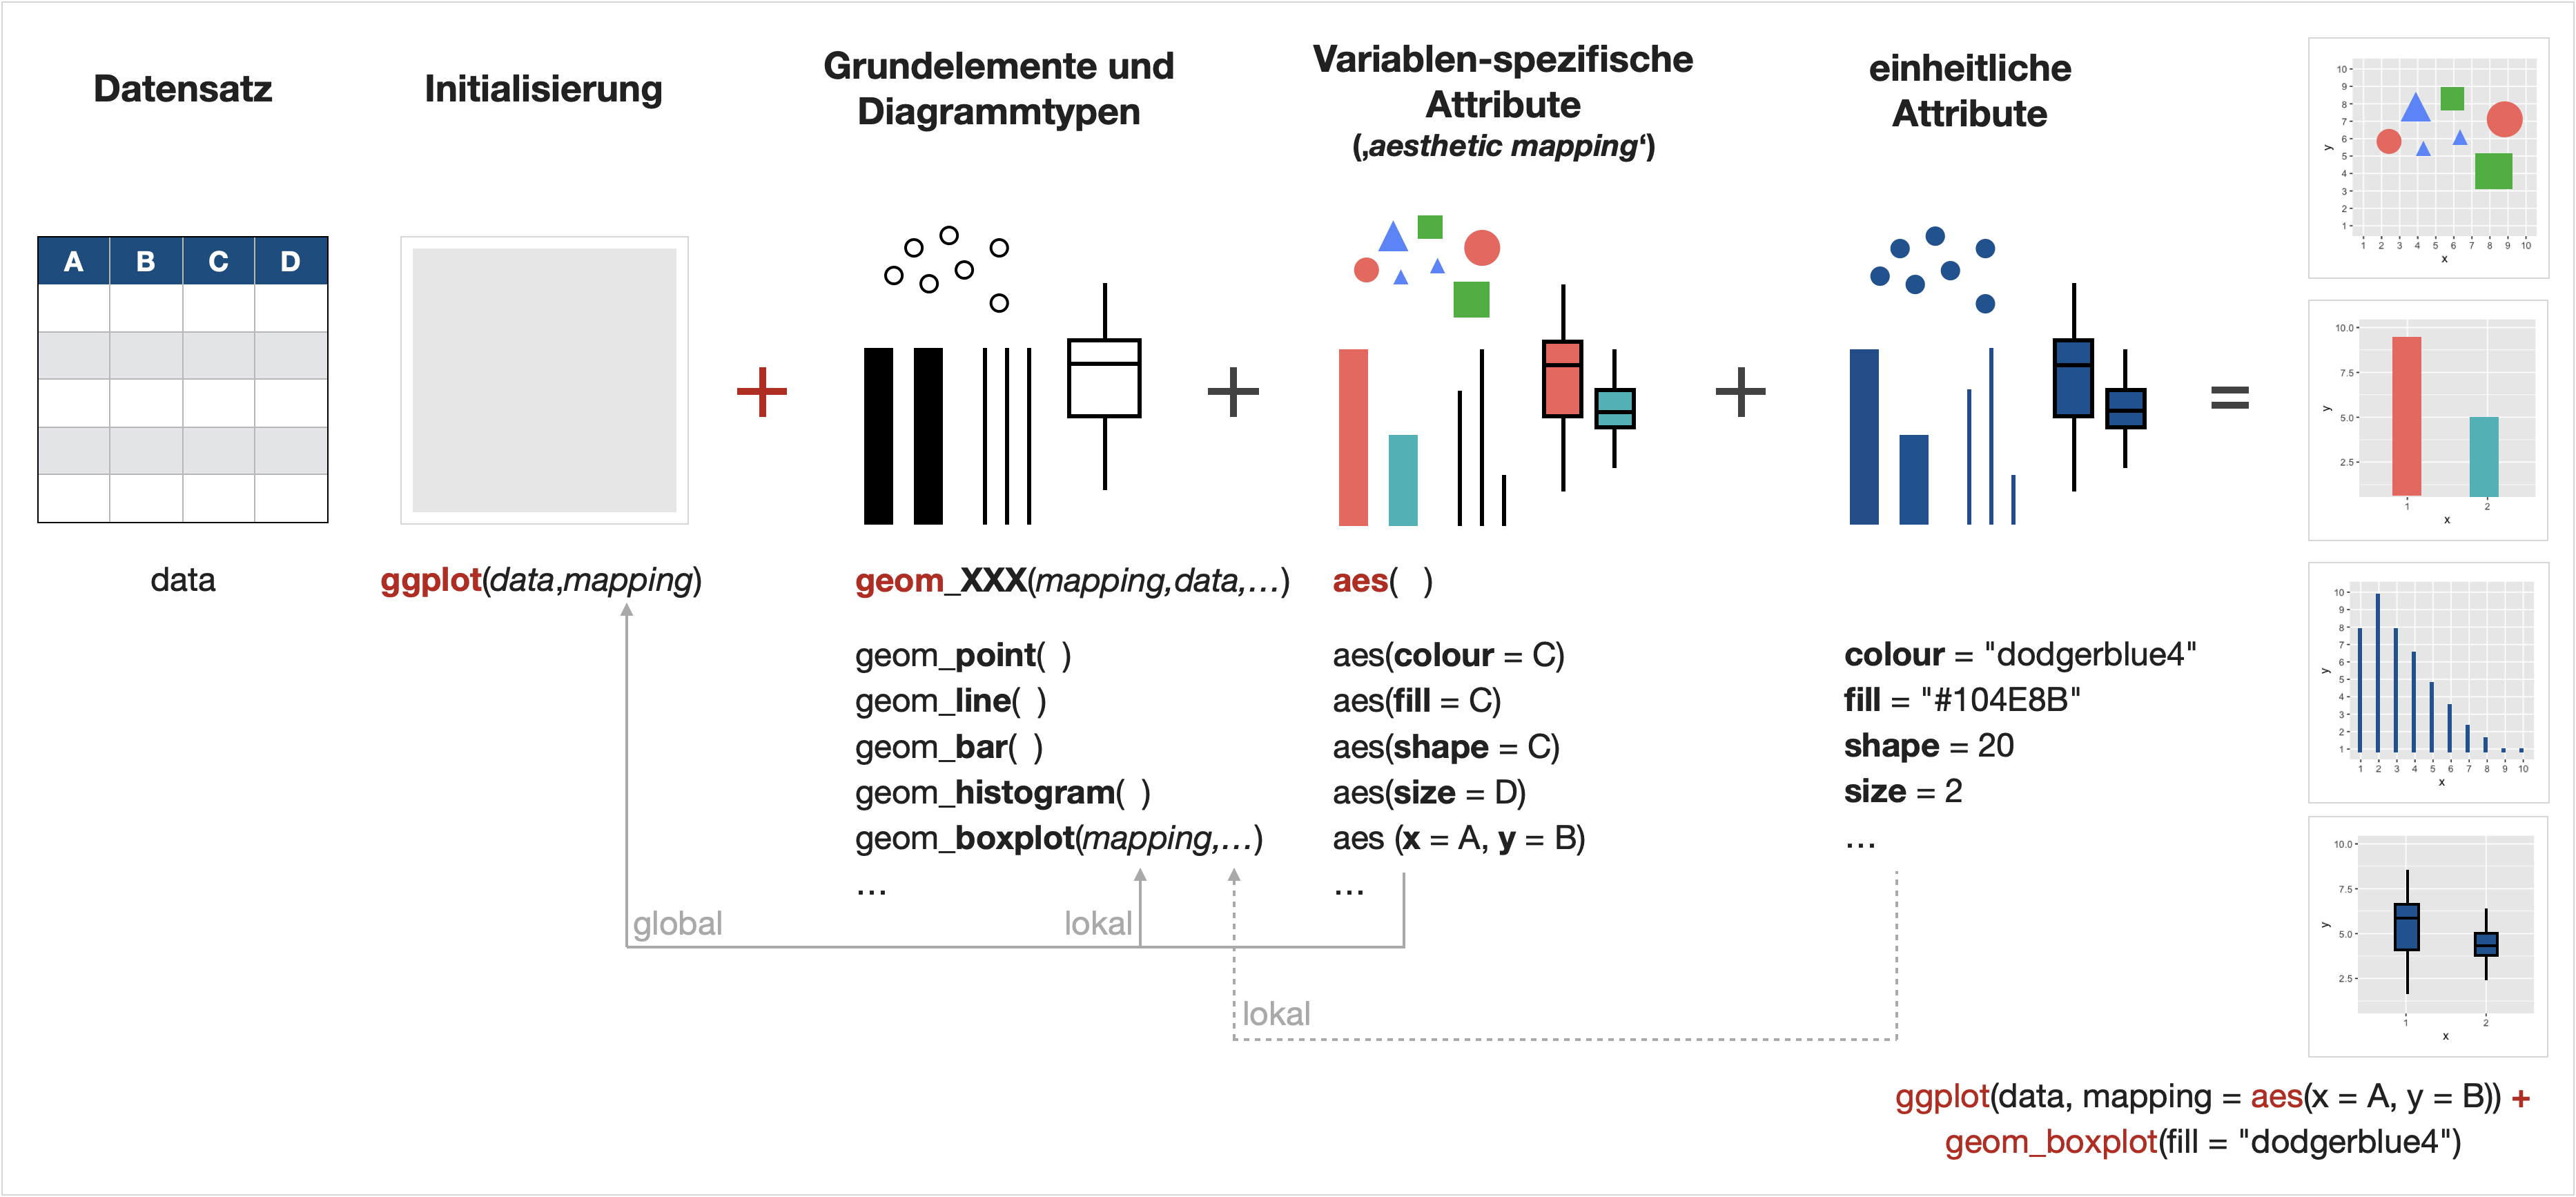
Mehr zum Thema ‘visual encoding’ in der Vorlesung 11 (Grundlagen der Datenvisualisierung).
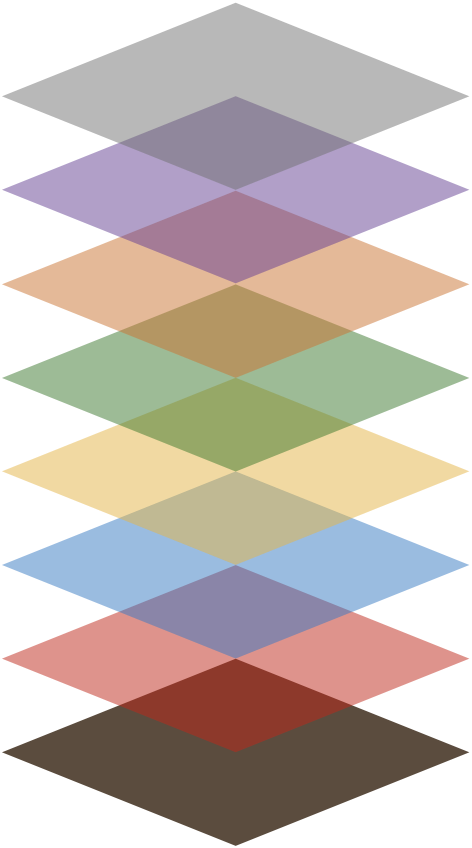
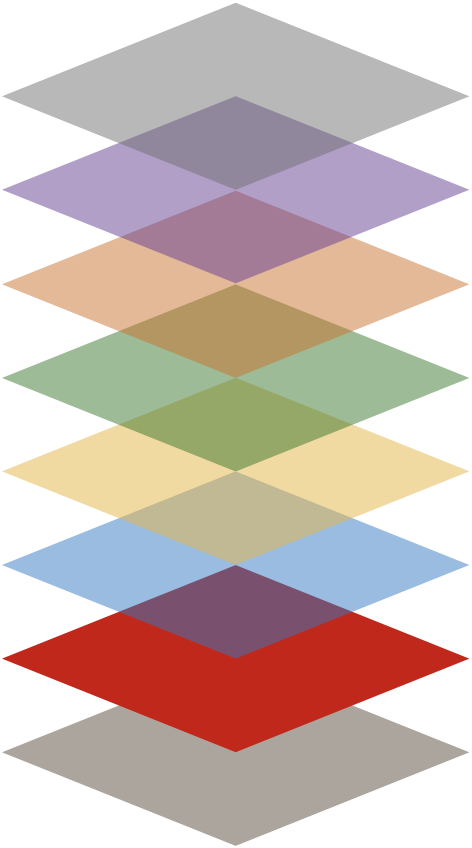
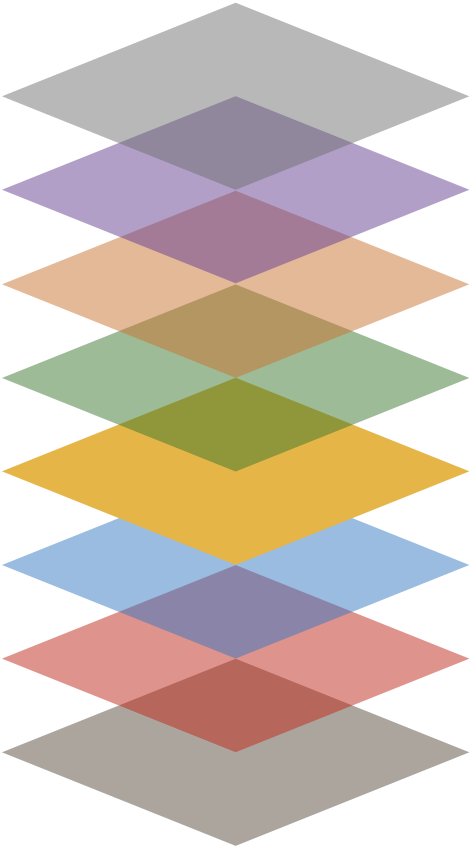
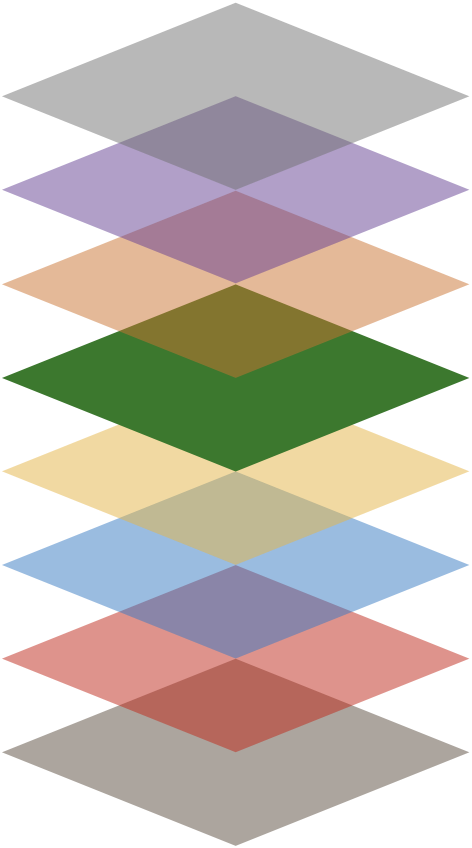
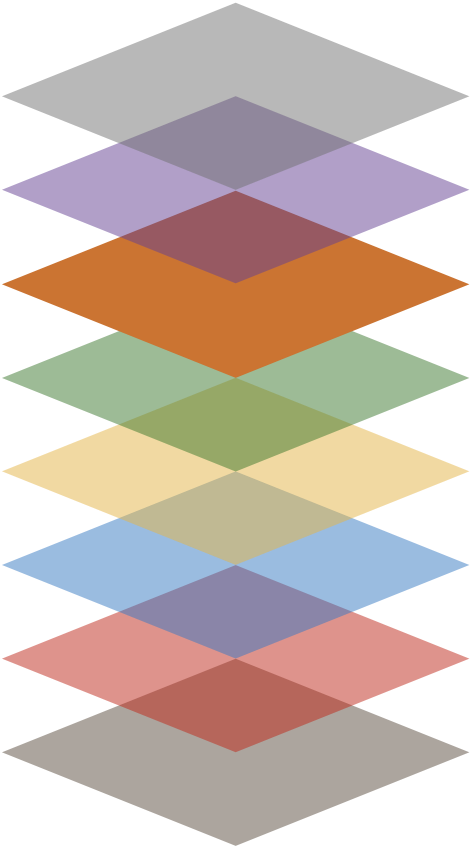
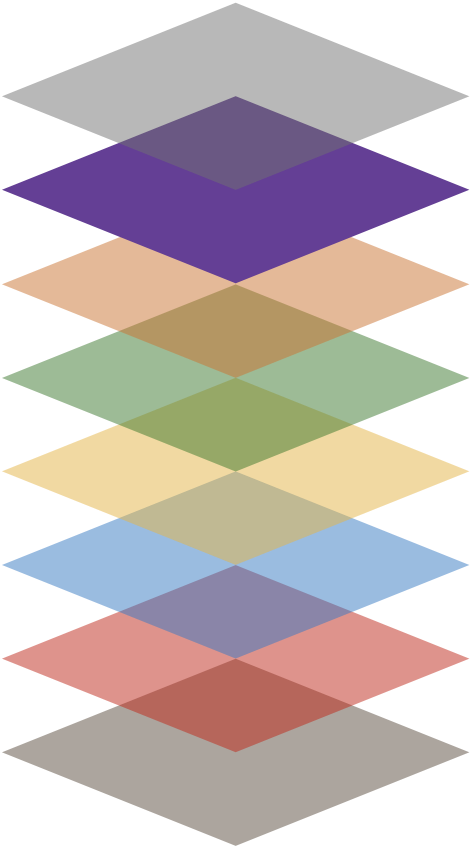
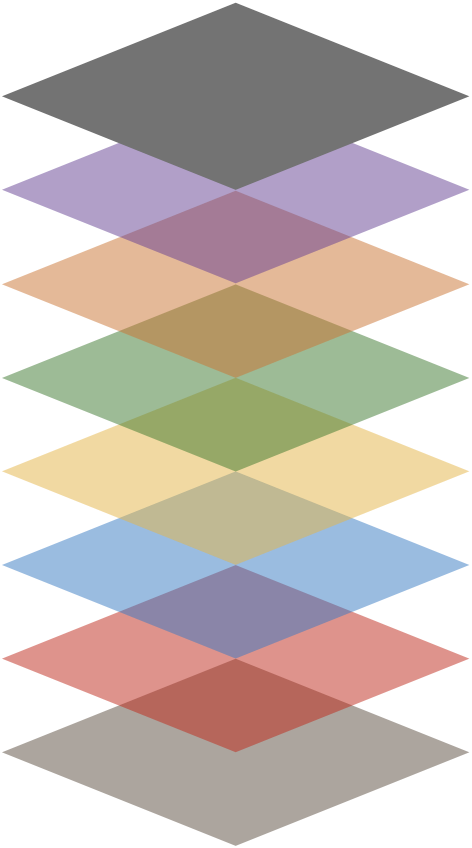
Die 8 Ebenen in ggplot2
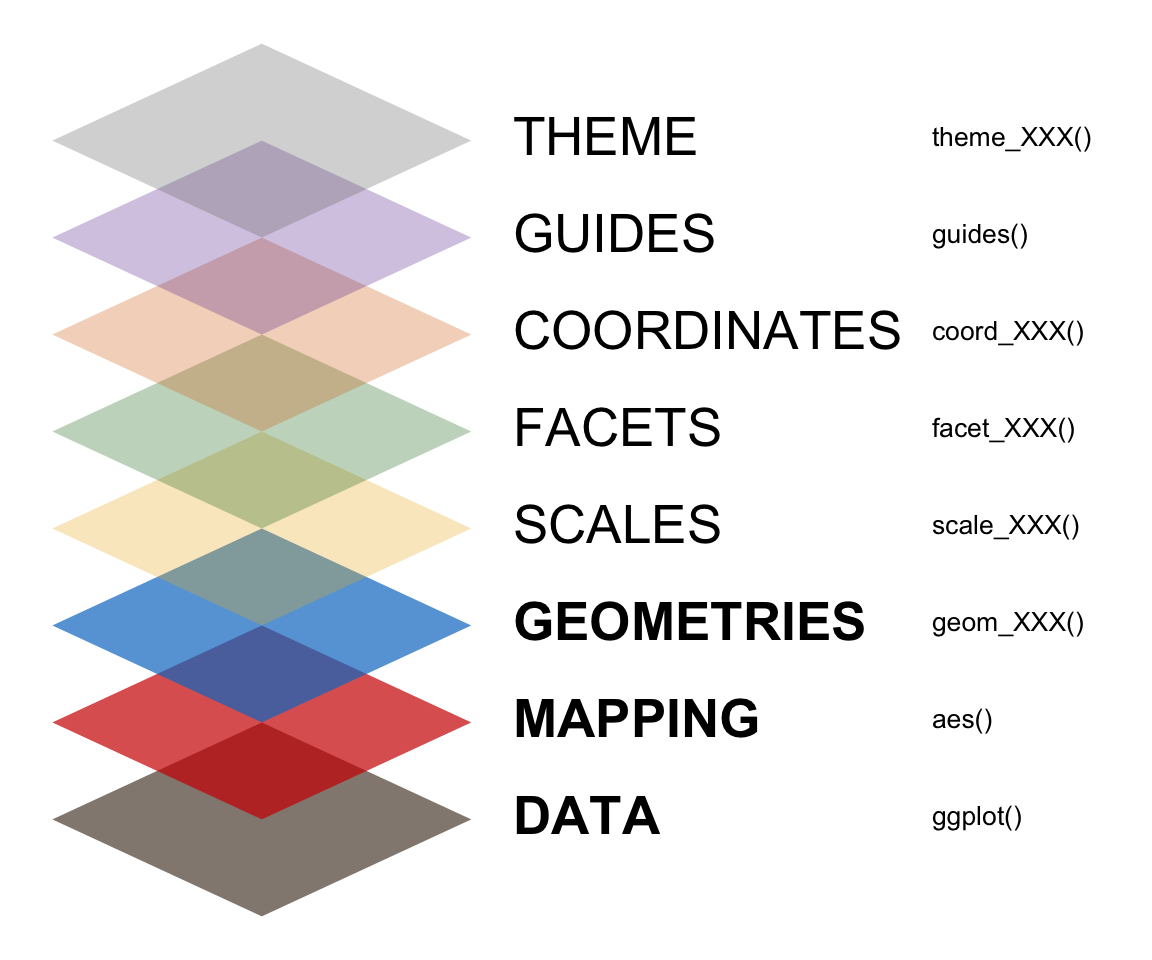
Eine Demonstration mit dem internen Datensatz ‘iris’
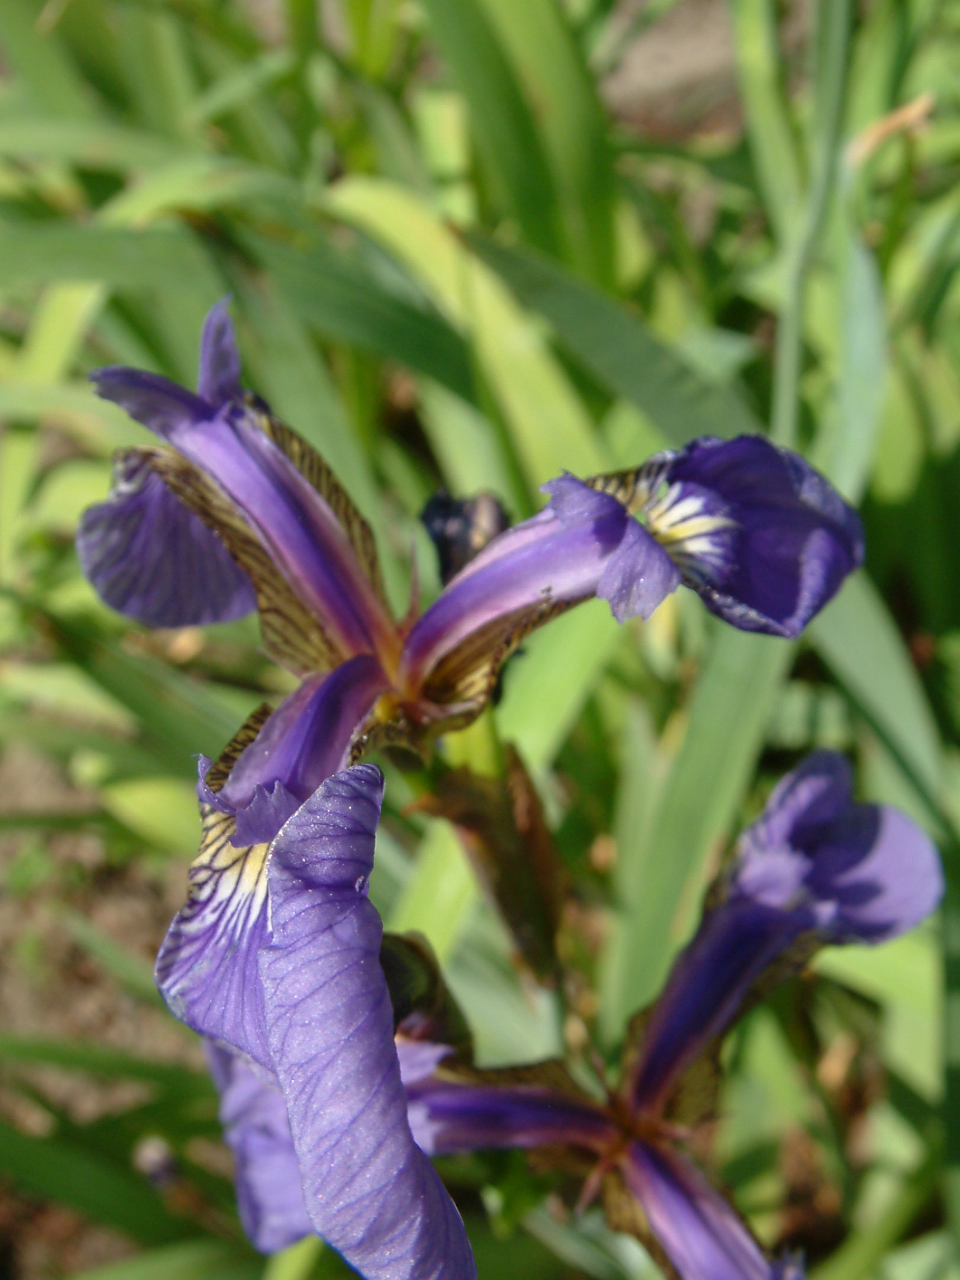
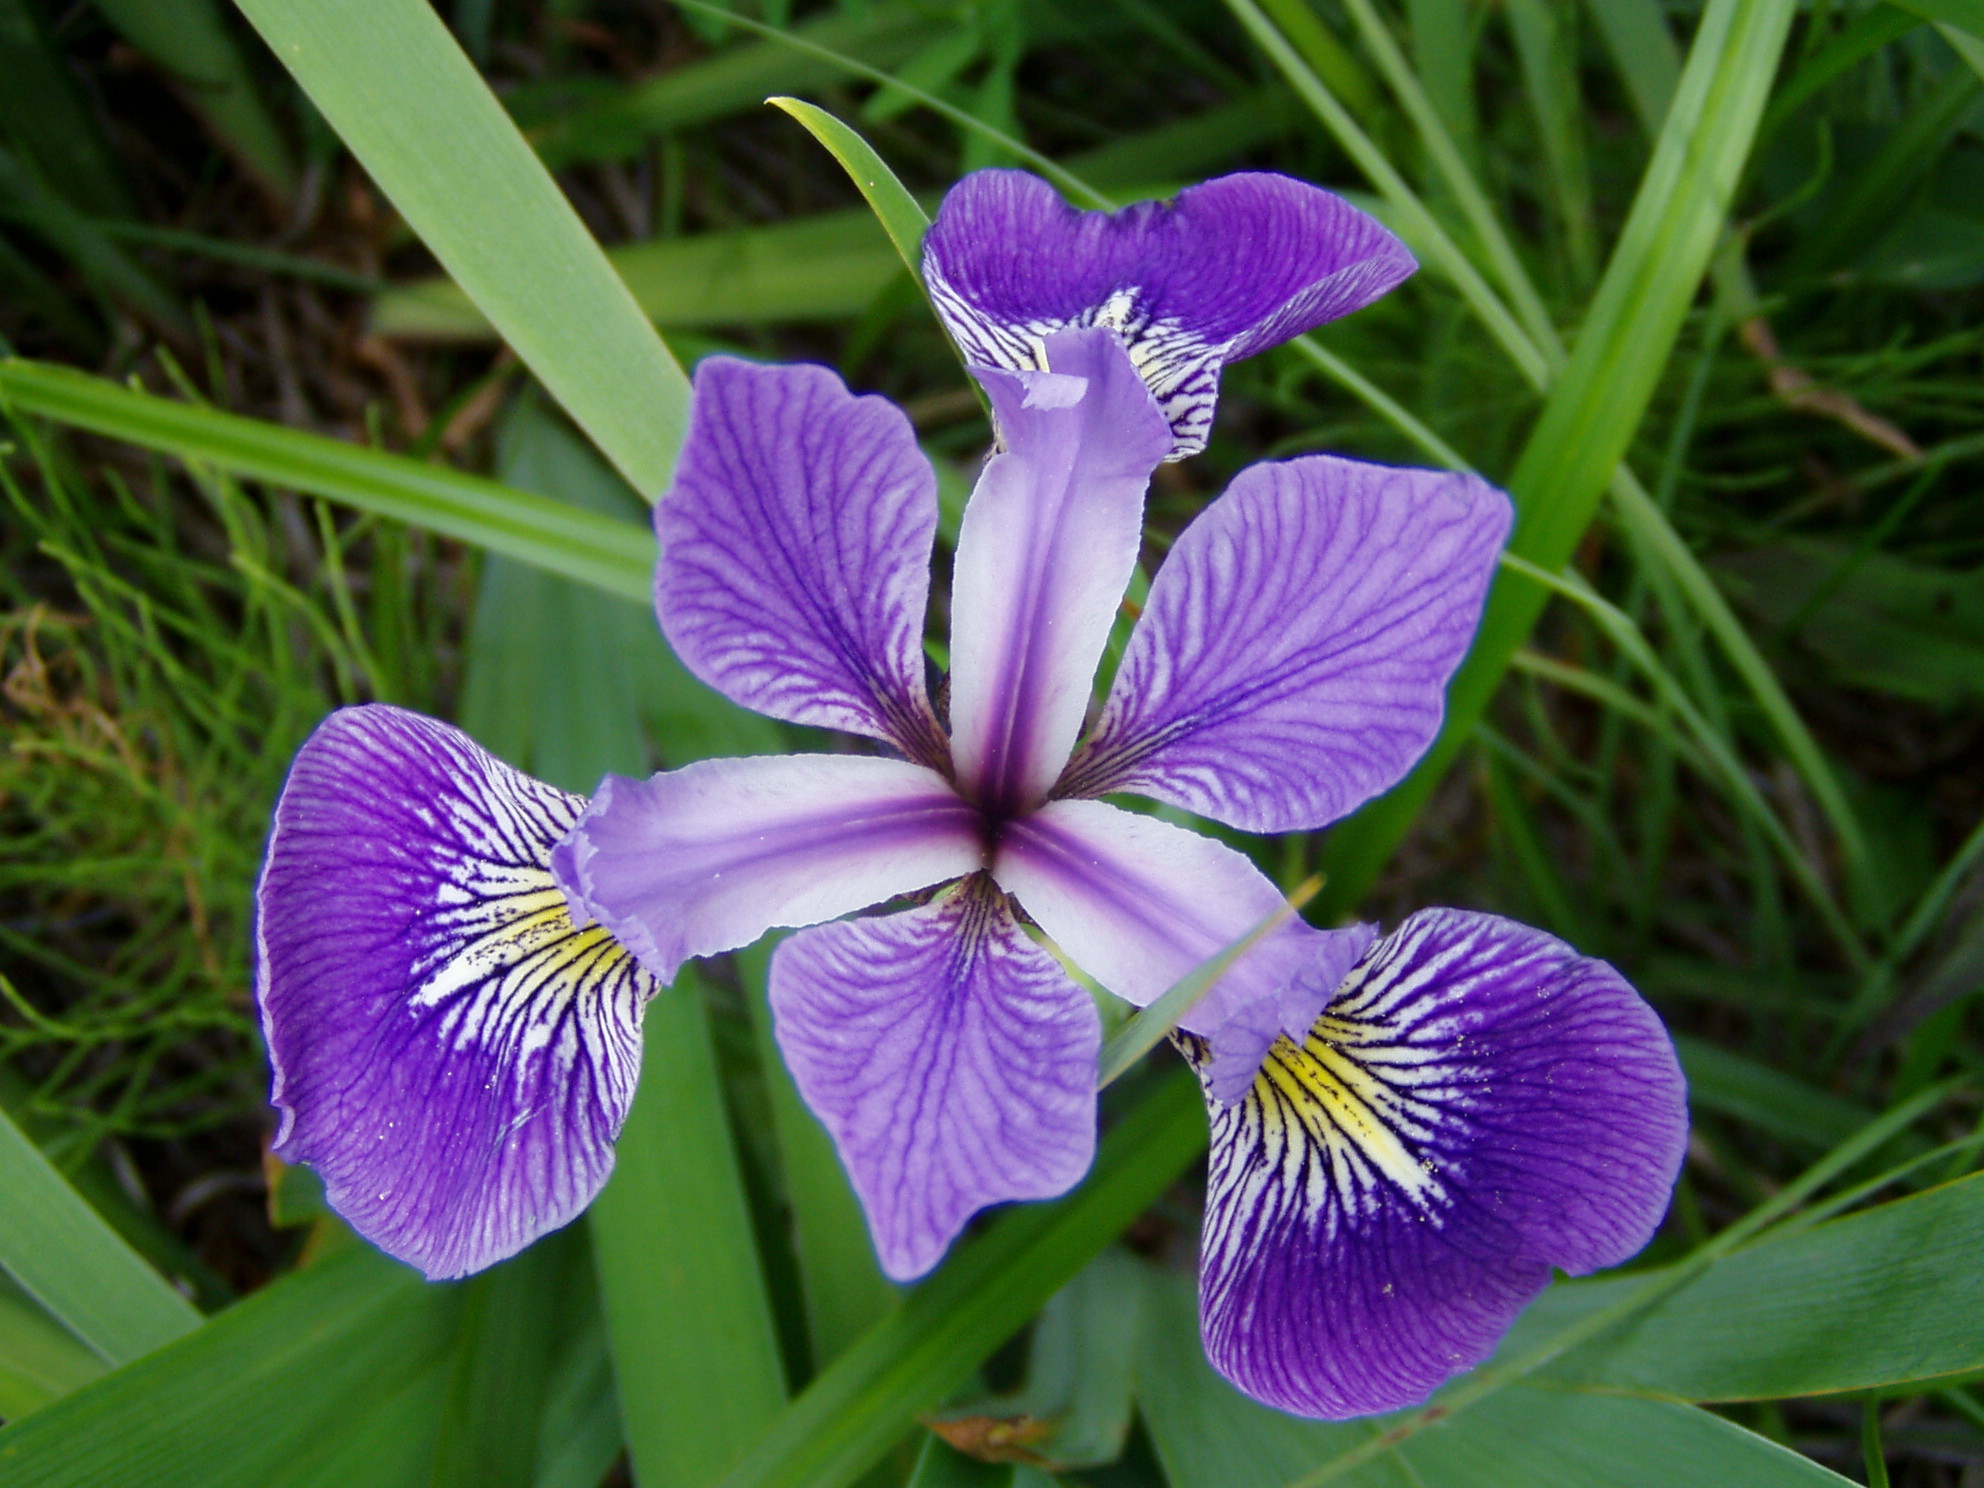
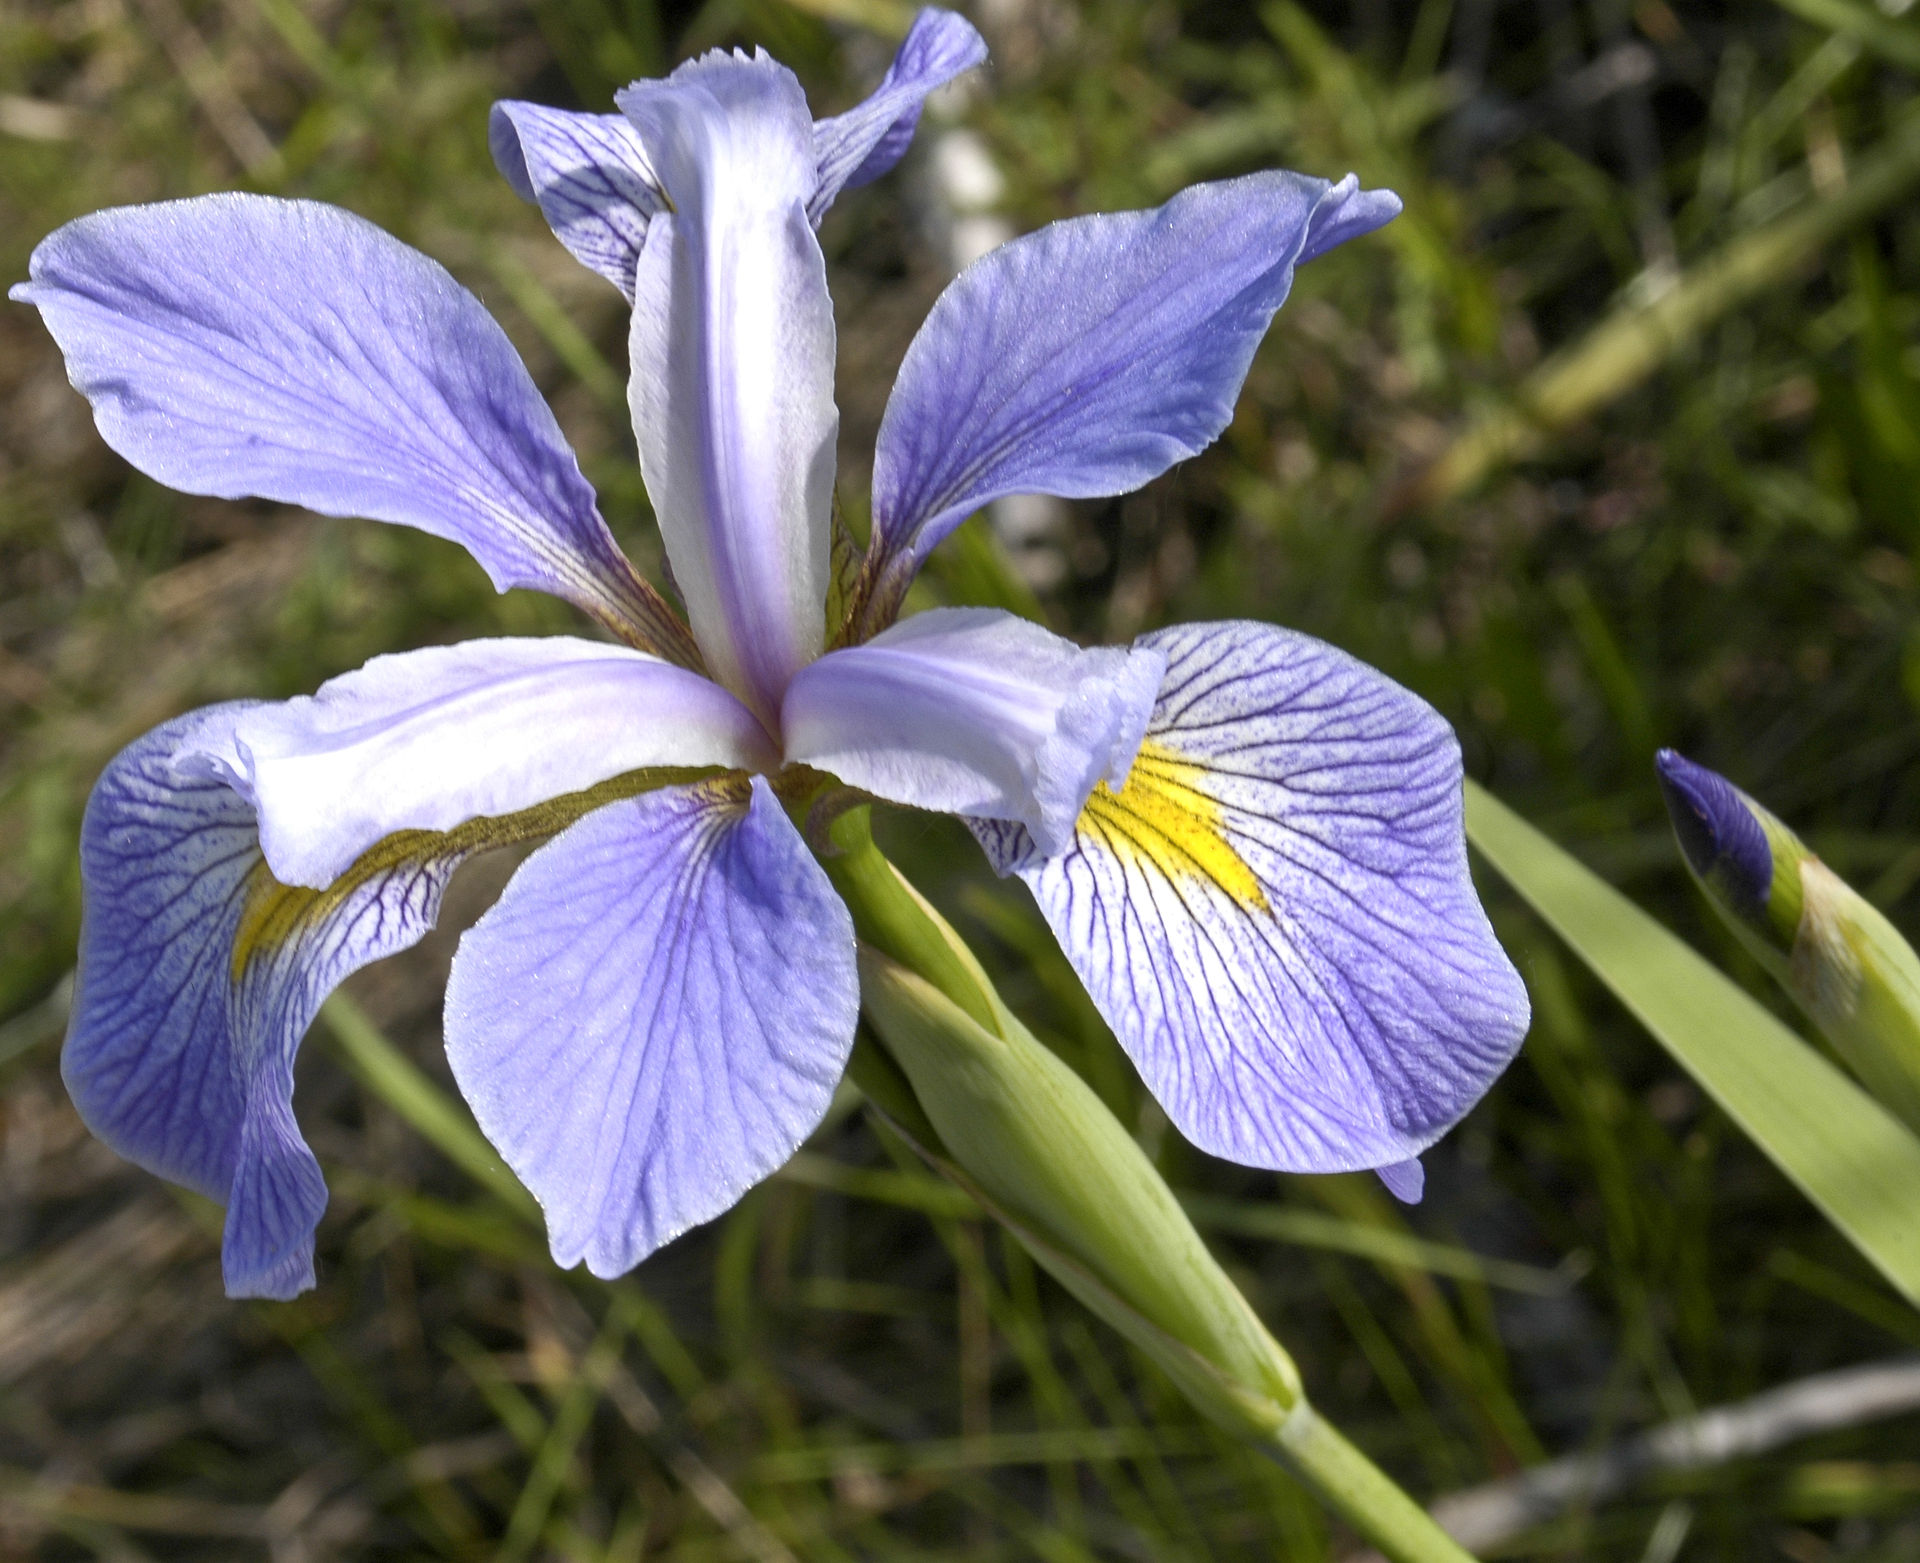
Fotos von Radomil Binek, Danielle Langlois, und Frank Mayfield (von links nach rechts); Zugriff über Wikipedia (unter CC-BY-SA 3.0 Lizenz).
Ebene 1 - Data
Grafik starten mit ggplot()

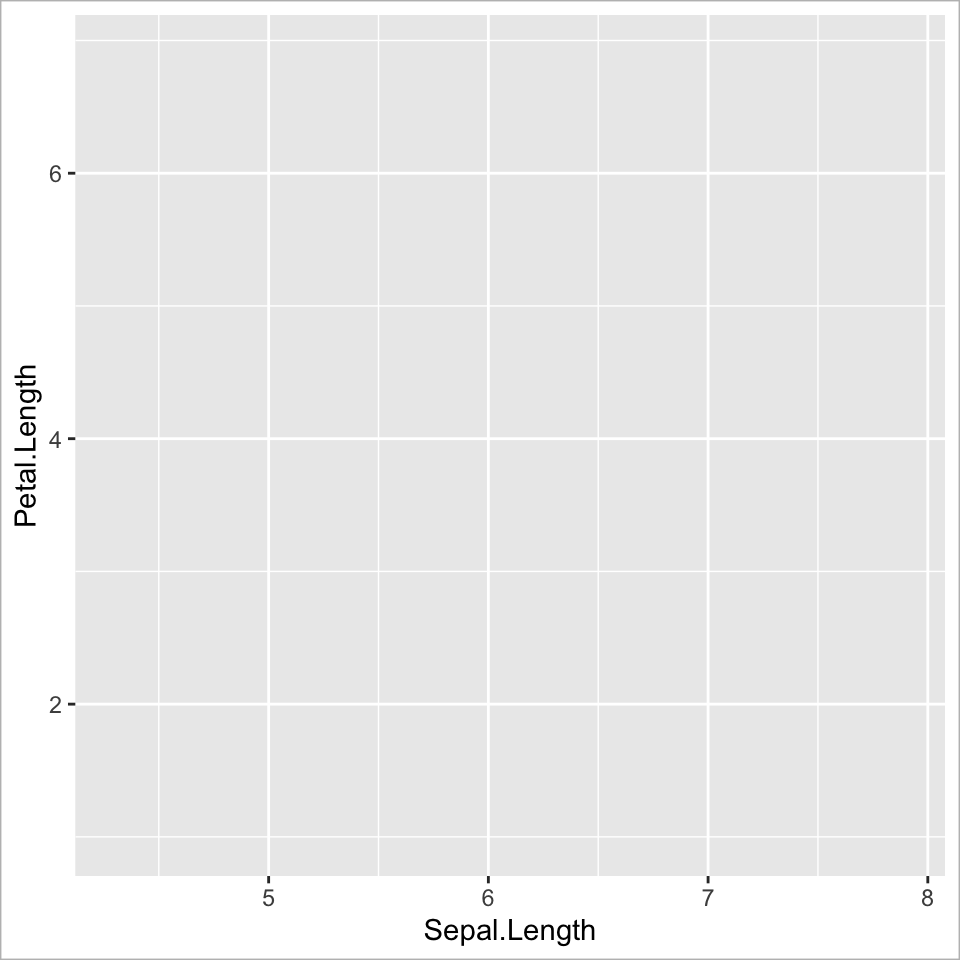
Ebene 2 - Aesthetic mapping | 1
Globale Variablenzuordnung von x und y
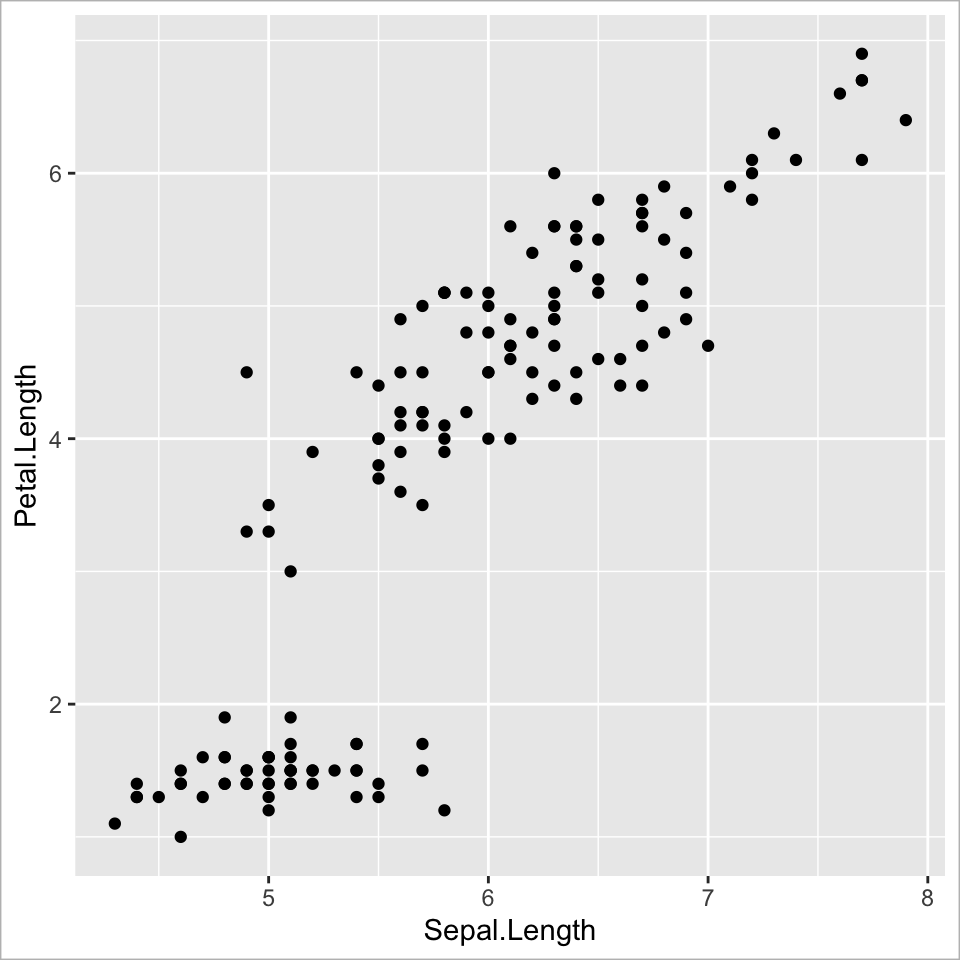
Ebene 3 - Geometries | 1
Punkte-Geometrie hinzufügen
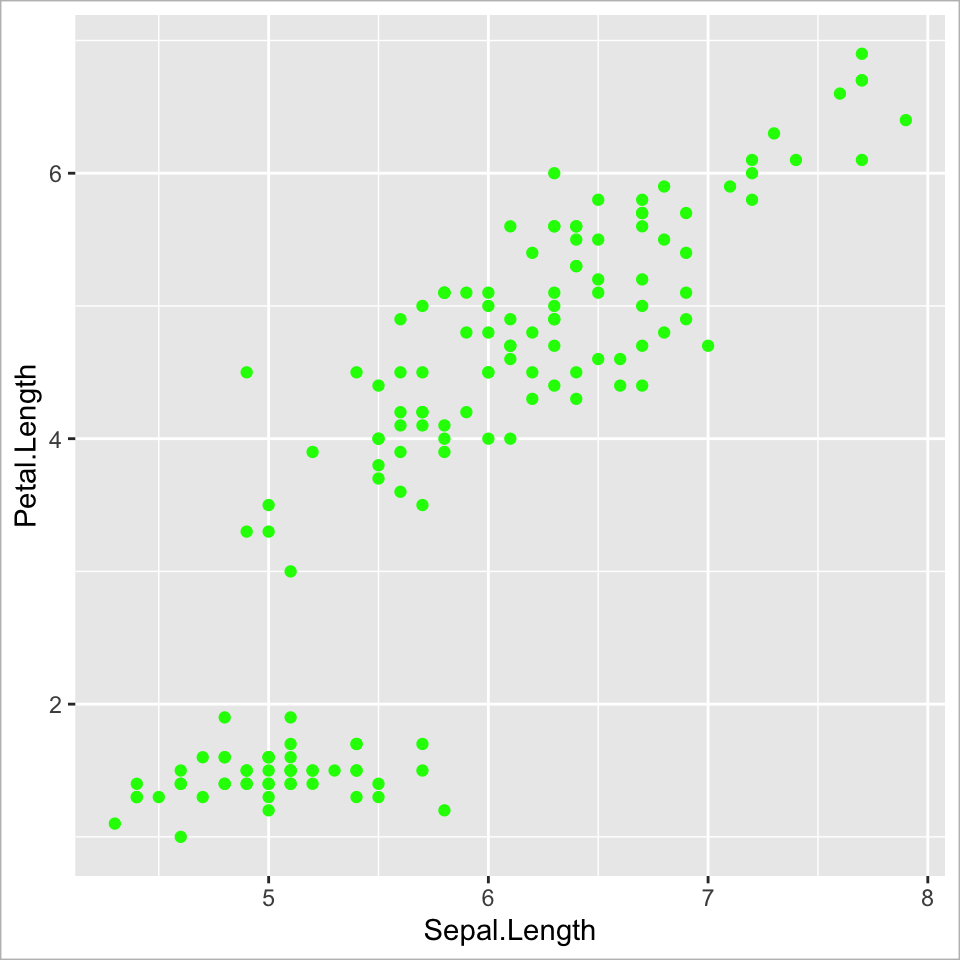
Ebene 3 - Geometries | 2
Die Punktfarbe einheitlich anpassen
Ebene 2 - Aesthetic mapping | 2
Variablen-spezifische Farbwahl (lokal)
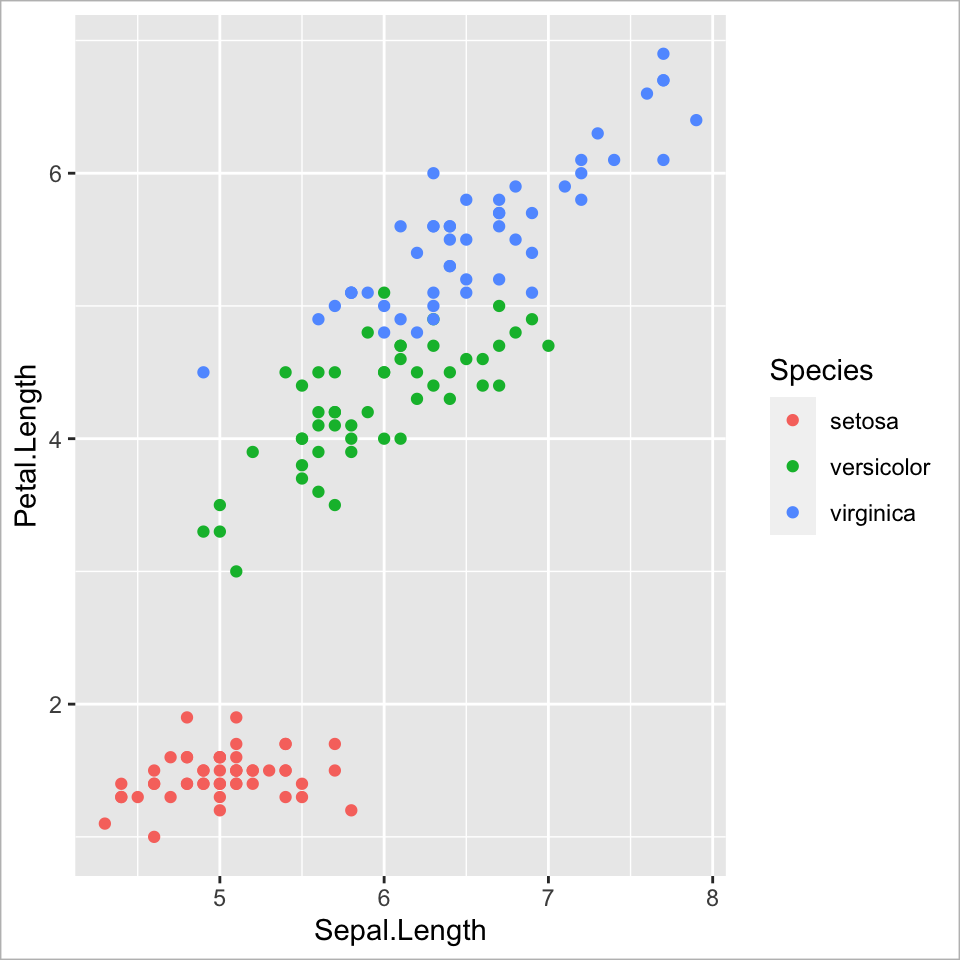
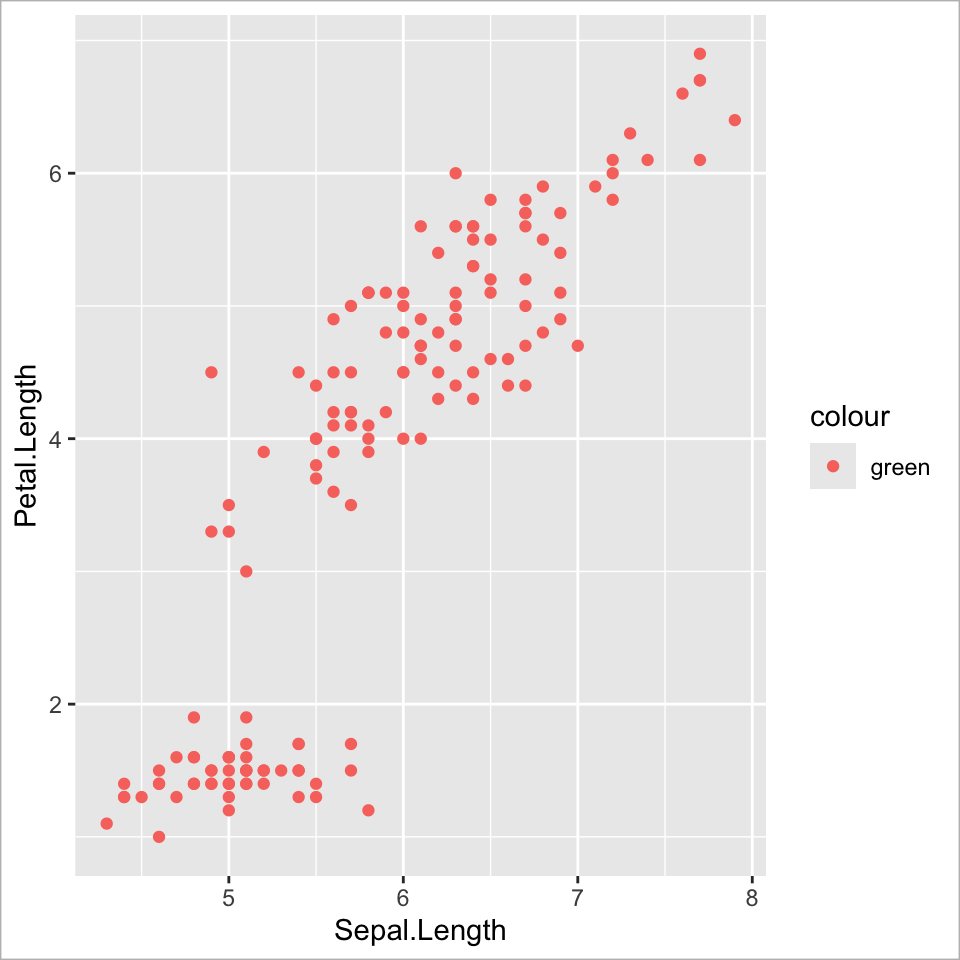
Ebene 2 - Aesthetic mapping | 3
Falsch: Einheitliche Farbwahl ‘mappen’
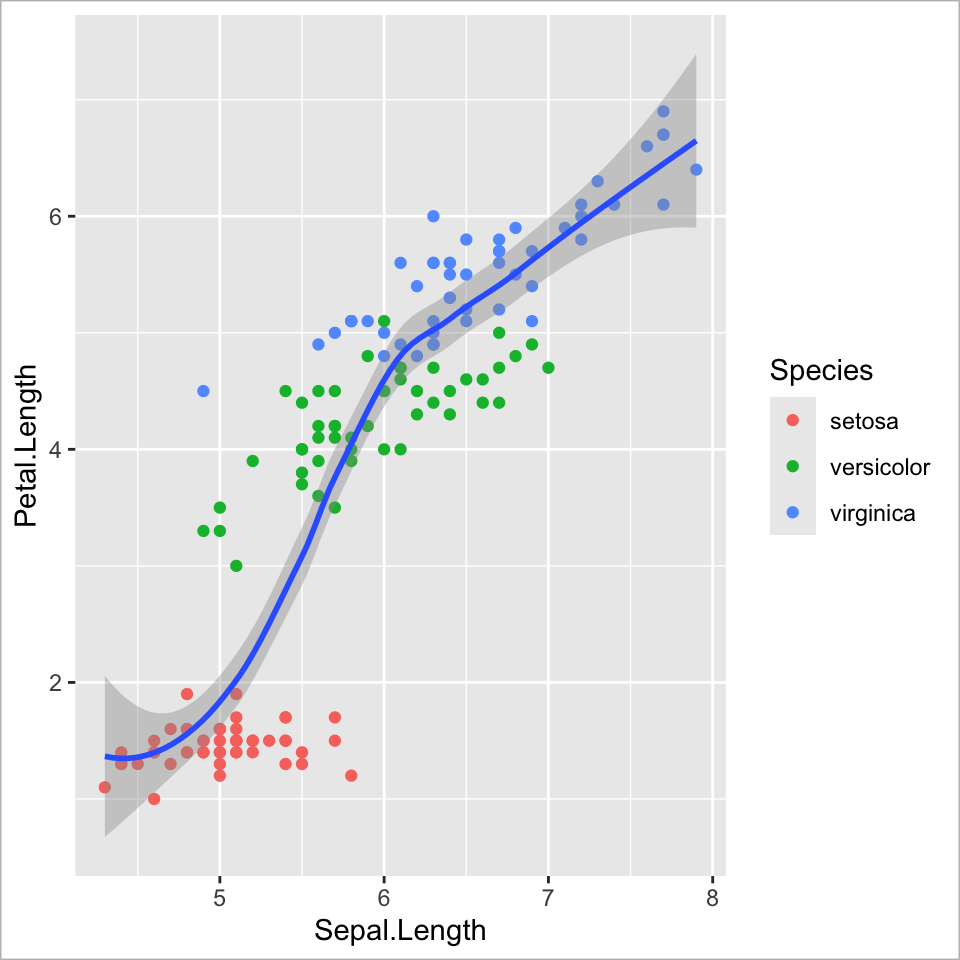
Ebene 3 - Geometries | 3
Weitere Geometrie hinzufügen: geglättete Kurve
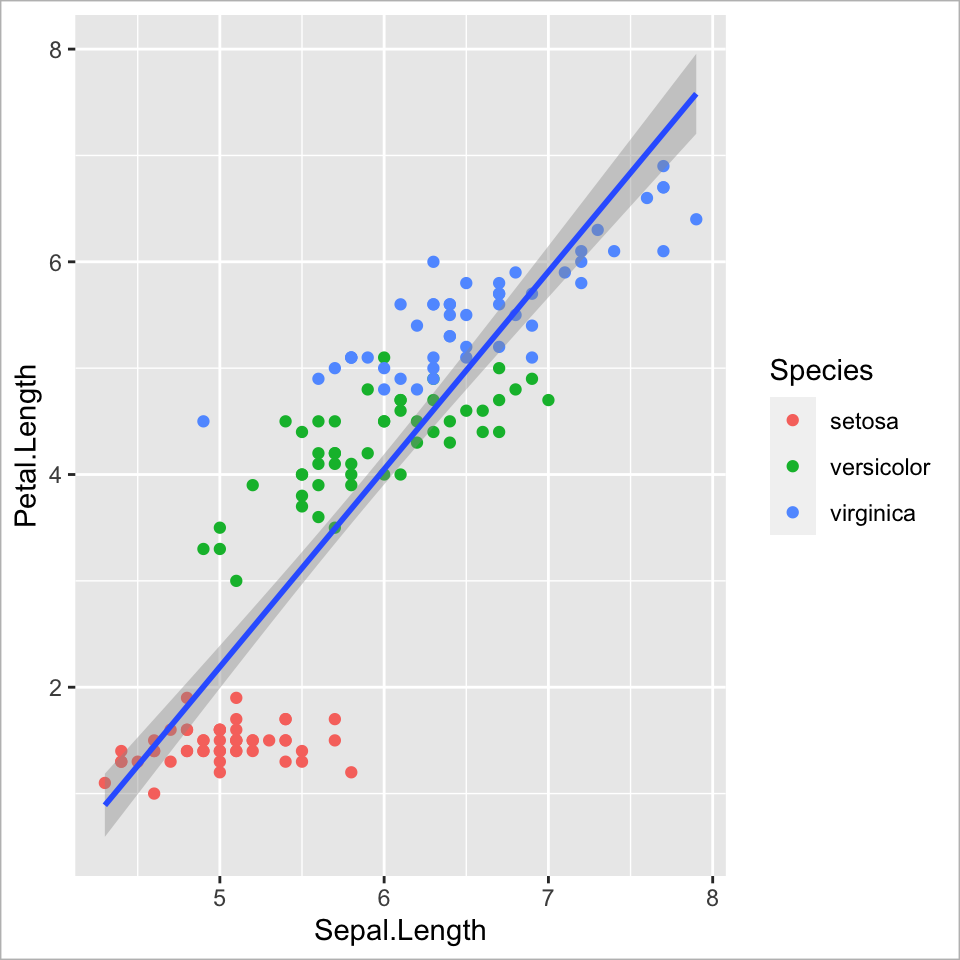
Ebene 3 - Geometries | 4
Weitere Geometrie hinzufügen: Trendlinie
Ebene 2 - Aesthetic mapping | 4
Art-spezifische Trendlinien über die Farbe (lokal)
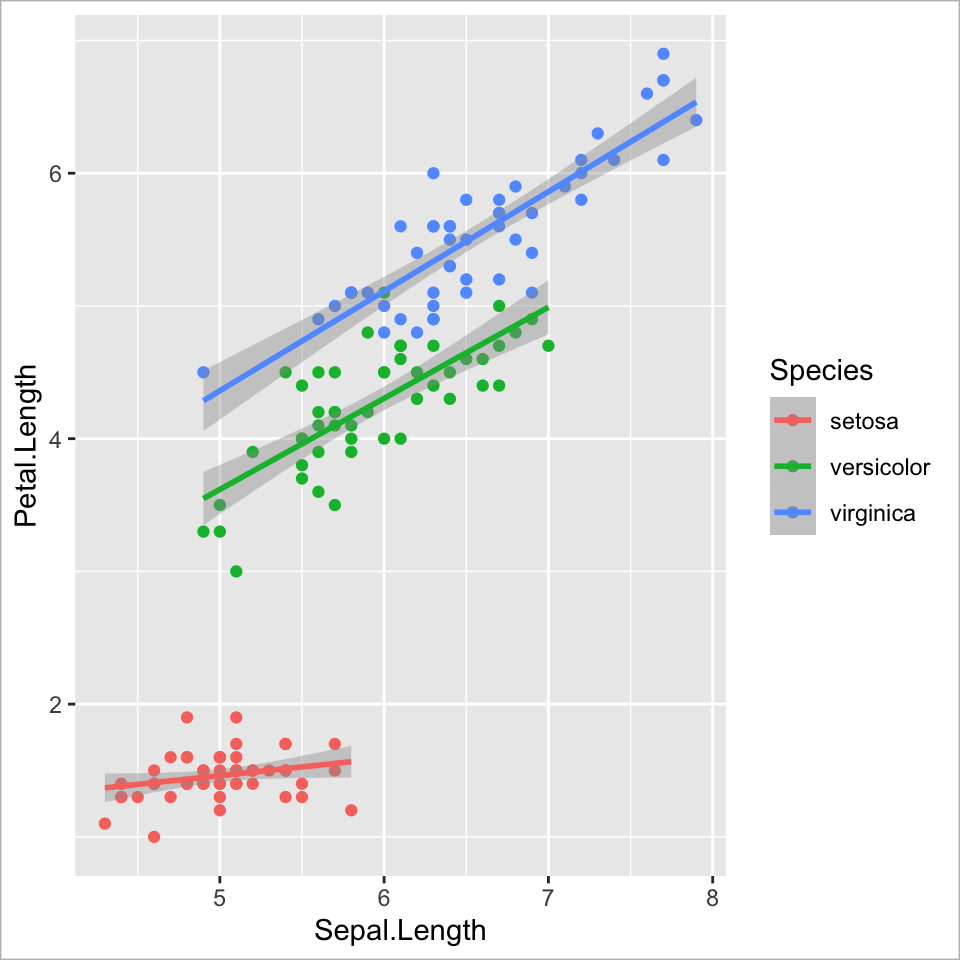
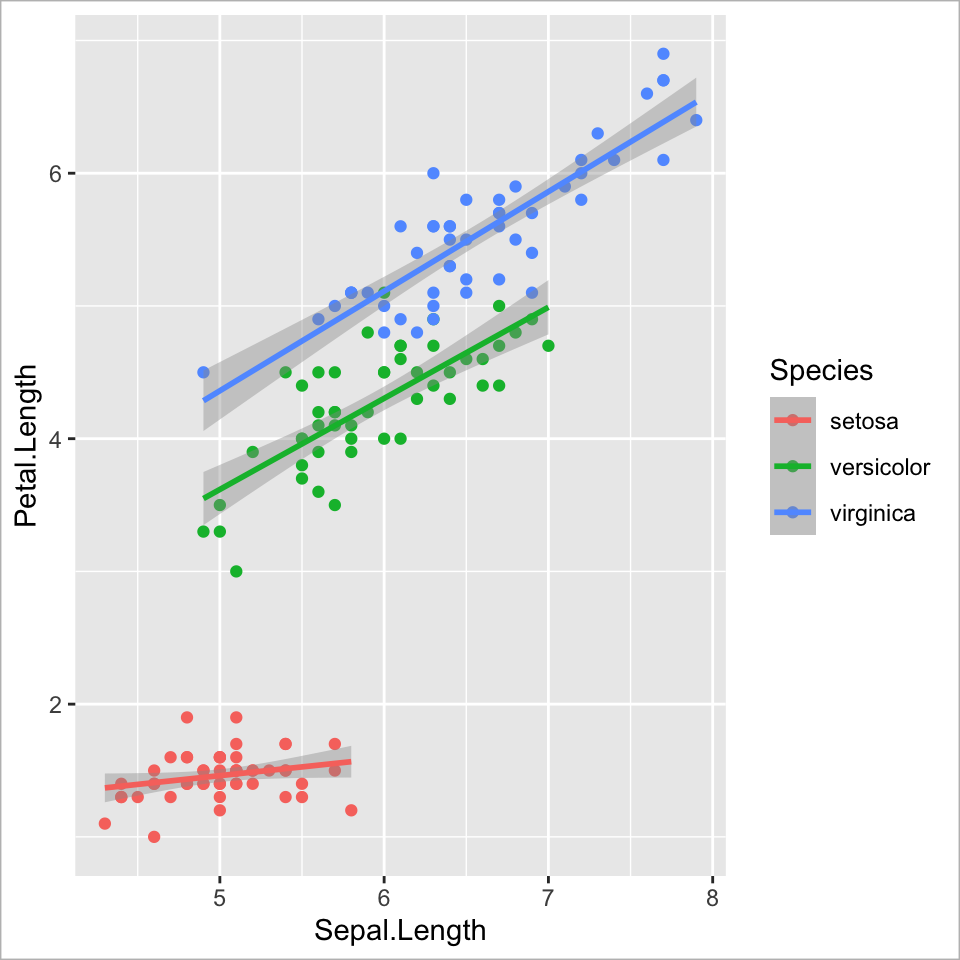
Ebene 2 - Aesthetic mapping | 5
Globale Farbwahl (für alle Geometrien)
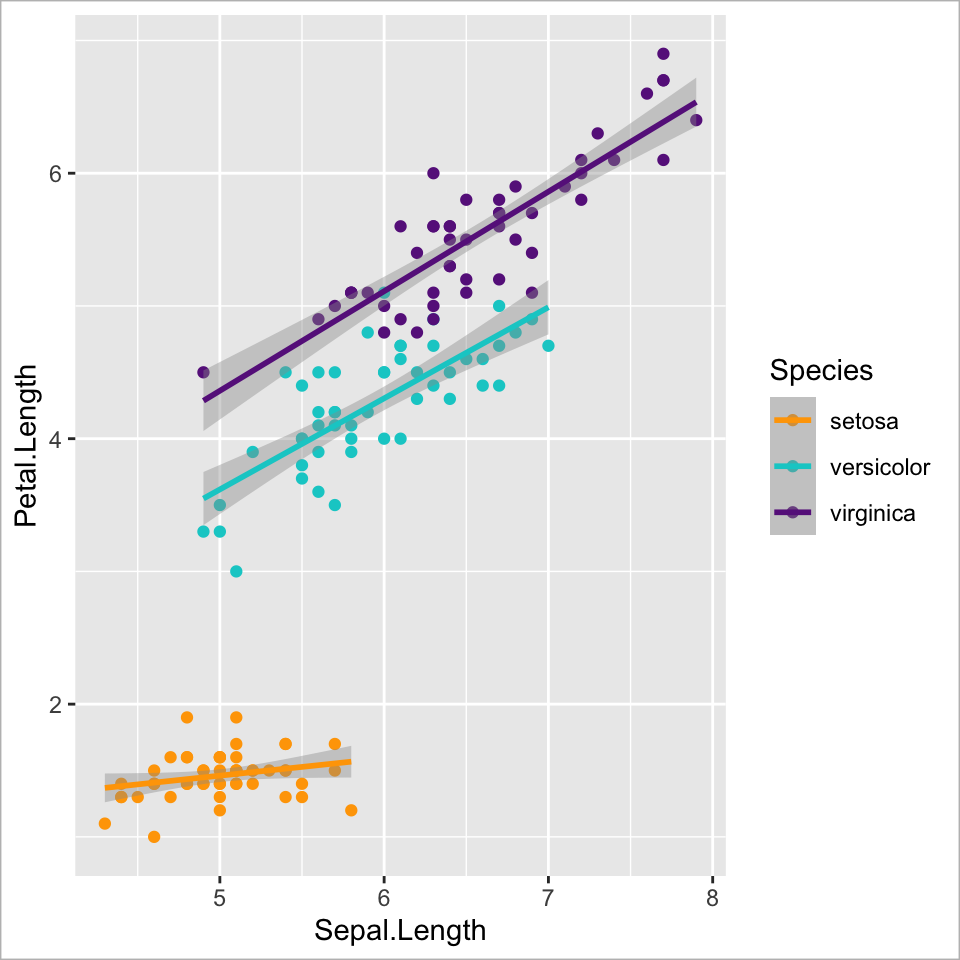
Ebene 4 - Scales
Farbskala anpassen
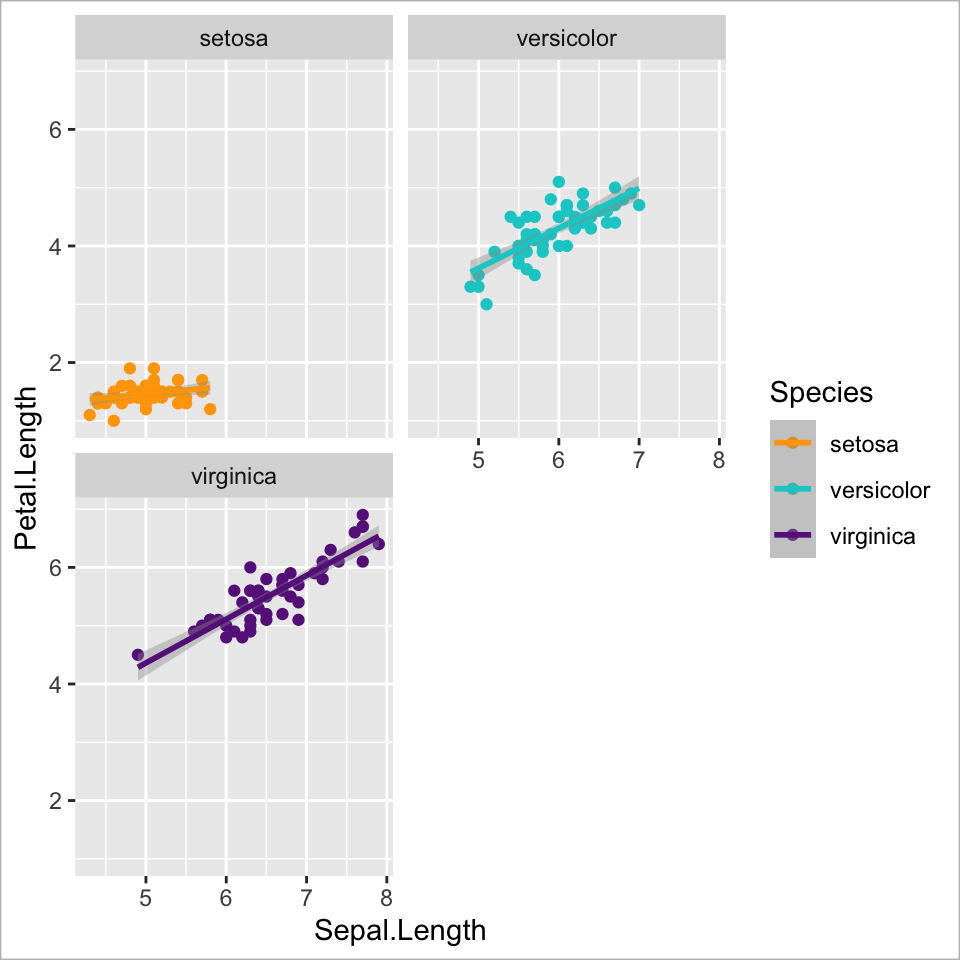
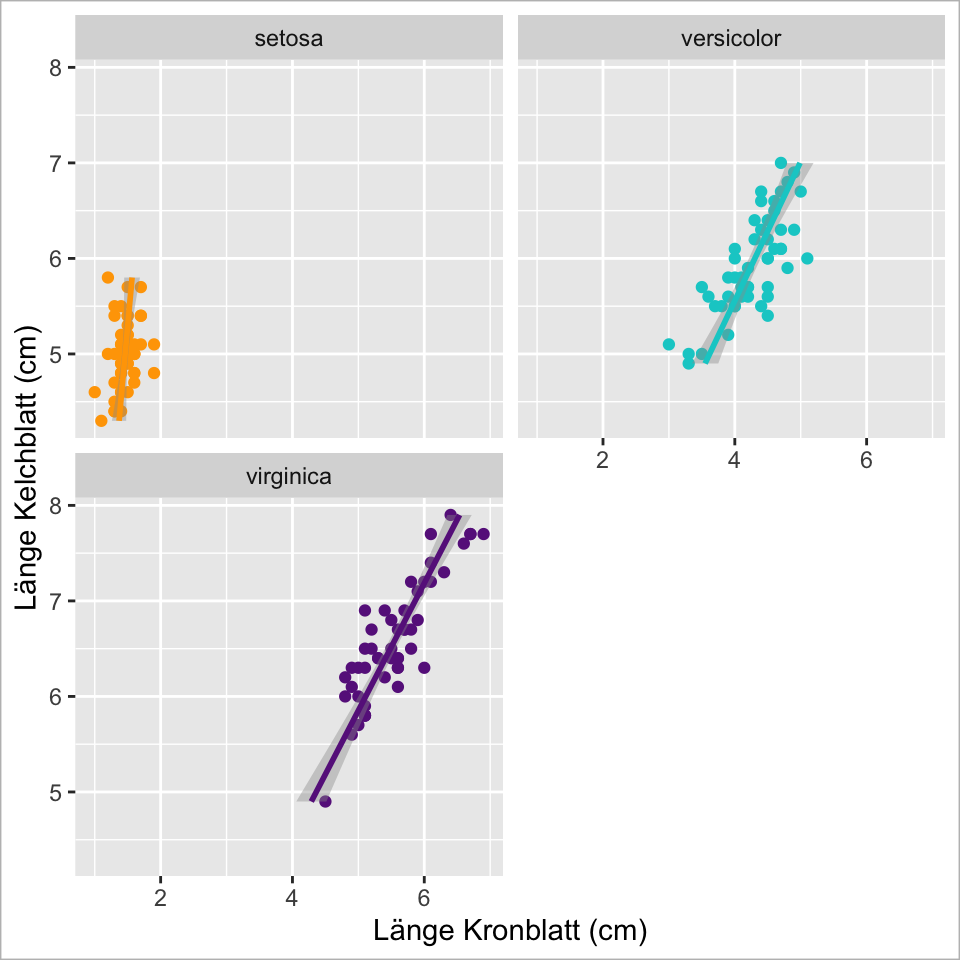
Ebene 5 - Facets
Datenpunkte aufteilen
Ebene 6 - Coordinates
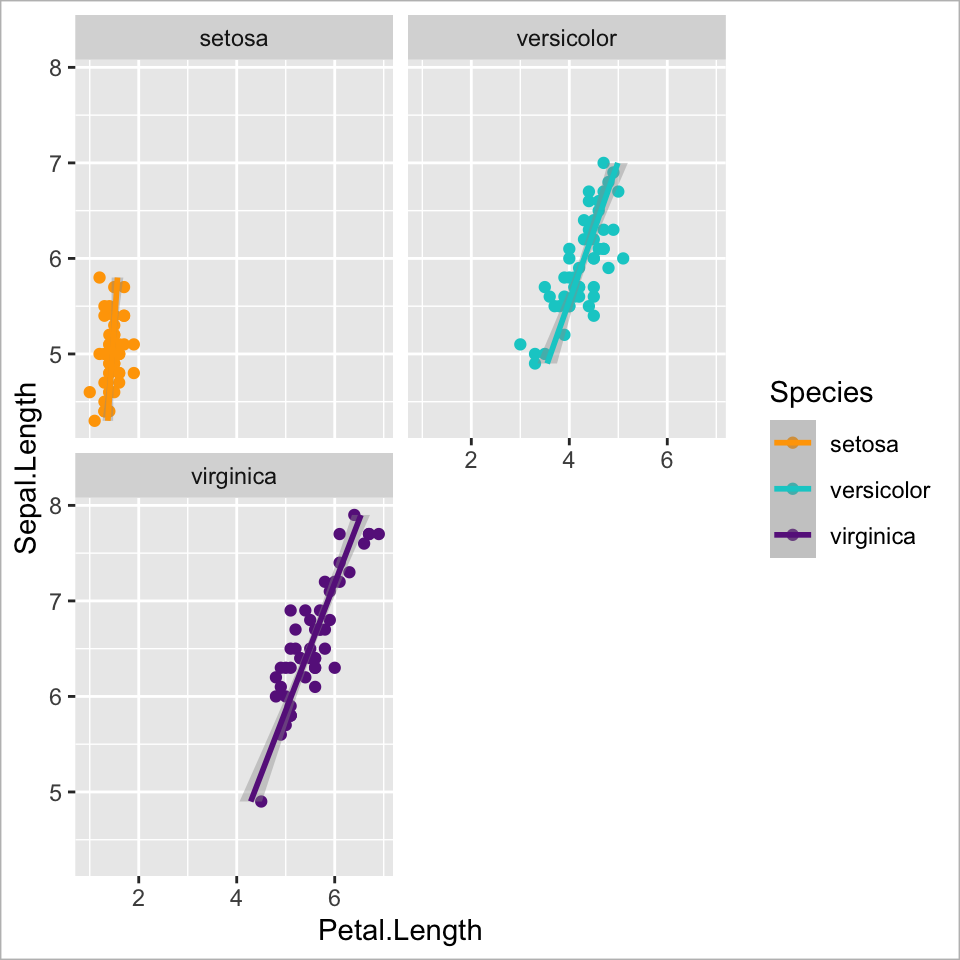
Das Koordinatensystem bspw. drehen
Ebene 7 - Guides
Legende und Achsenbeschriftung anpassen
ggplot(
  data = iris,
  mapping = aes(
    x = Sepal.Length,
    y = Petal.Length,
    colour = Species)
  ) +
  geom_point() +
geom_smooth(method = "lm") +
scale_colour_manual(values =
c("orange","cyan3", "#68228B")) +
facet_wrap(~Species, nrow = 2) +
coord_flip() +
guides(colour = guide_none()) +
labs(x = "Länge Kelchblatt (cm)",
y = "Länge Kronblatt (cm)")Kurzform für das Ausblenden der Legende: guides(colour = "none")
Ebene 8 - Theme
Ändern des Layouts (der Nicht-Datenelemente)
ggplot(
  data = iris,
  mapping = aes(
    x = Sepal.Length,
    y = Petal.Length,
    colour = Species)
  ) +
  geom_point() +
  geom_smooth(method = "lm") +
  scale_colour_manual(values =
c("orange","cyan3", "#68228B")) +
facet_wrap(~Species, nrow = 2) +
coord_flip() +
guides(colour = guide_none()) +
labs(x = "Länge Kelchblatt (cm)",
y = "Länge Kronblatt (cm)") +
theme_dark()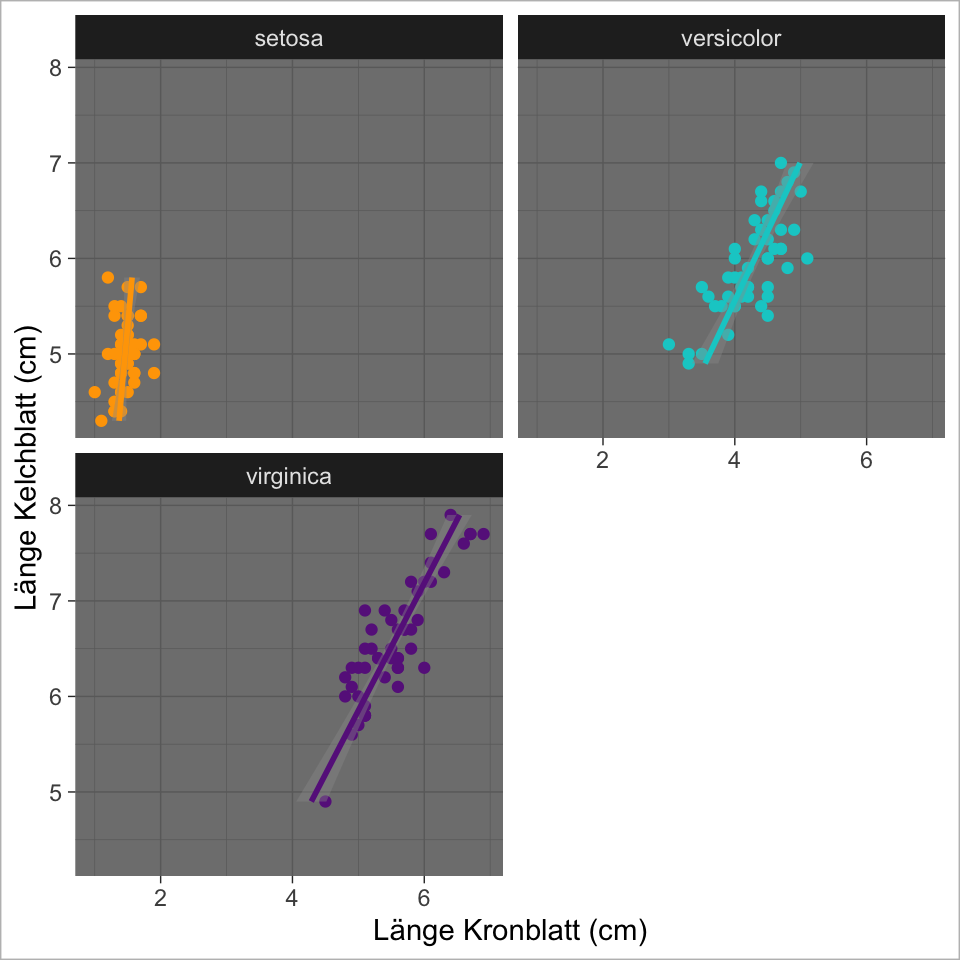
Zusammenfassung der einzelnen Ebenen

1. Daten
Starte mit dieser Funktion und übergebe einen Datensatz an die Funktion: ggplot(data)
2. Aesthetic mapping
Als nächstes müssen die Datenvariablen den Koordinaten zugeordnet werden, damit ein leeres Koordinatensystem dargestellt wird. Dies geschieht in der aes() Funktion. Weitere visuelle Eigenschaften (sog. aesthetics) sind z.B. Größe, Farbe, Form, etc.
- Zuordnung alleinstehend oder innerhalb von
ggplot()gilt für alle Ebenen. - Zuordnung in
geom_XXX()Funktion gilt nur für diese Ebene.
3. Geometrien
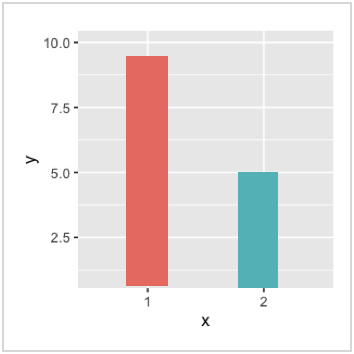
geom_XXX(): Kombiniere ein geometrisches Objekt/Grundelement, welches die Daten repräsentiert, mit den Abbildungseigenschaften, einer Statistik und einer Positionsanpassung, z.B. geom_point() oder geom_col().
4. ‘Scales’
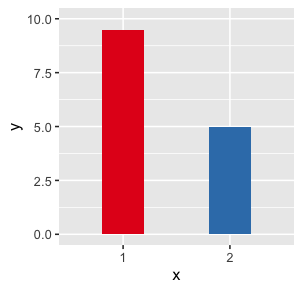 Sog. ‘scale’ Funktionen bestimmen, wie Datenwerte in visuelle Eigenschaften übersetzt werden (überschreiben die Standardeinstellungen), wie z.B.
scale_fill_manual().
5. ‘Faceting’
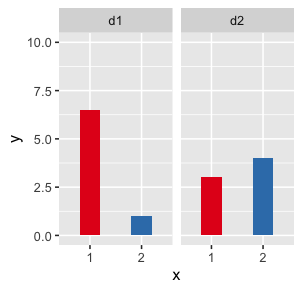
facet_XXX() Funktionen erstellen kleinere Diagramme, die verschiedene Teilmengen der Daten anzeigen; nützlich zur Untersuchung von Interaktionen mit kategorialen Variablen.
6. Koordinatensystem
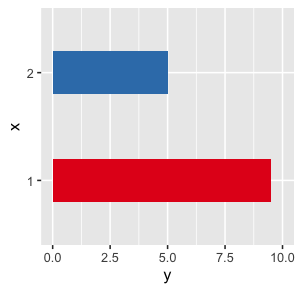 Funktionen wie
coord_flip() bestimmen die Darstellung des XY-Koordinatensystems und somit die Positionierung der Daten.
7. ‘Guides’
Mit der guides() Funktion und weiteren guide_XXX() Helferfunktionen kann die Anzeige der Achsen und Legende bestimmt werden.
8. ‘Themes’
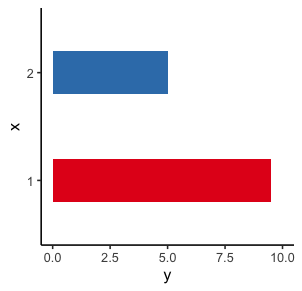 Sog. ‘theme’ Funktionen bestimmen die Anzeige aller Nicht-Datenelemente des Plots. Es können alle Einstellungen mit einem kompletten Thema wie
theme_classic() überschrieben oder einzelne Einstellungen mit theme() verändert werden.
Grafik speichern
Das aktuell angezeigte ggplot Diagramm lässt sich mit ggsave() speichern: ggsave("plot.png", width = 5, height = 5) → speichert den Plot als PNG mit 5 x 5 inch ab (das Format ergibt sich aus der Dateiendung).
ggplots als Objekte abspeichern | 1
- Nützlich, um weitere Ebenen später hinzuzufügen,
- wenn der Basisplot Grundlage für mehrere Diagramme sein soll (reduziert Tipparbeit)
- oder wenn mehrere Diagramme kombiniert werden sollen.
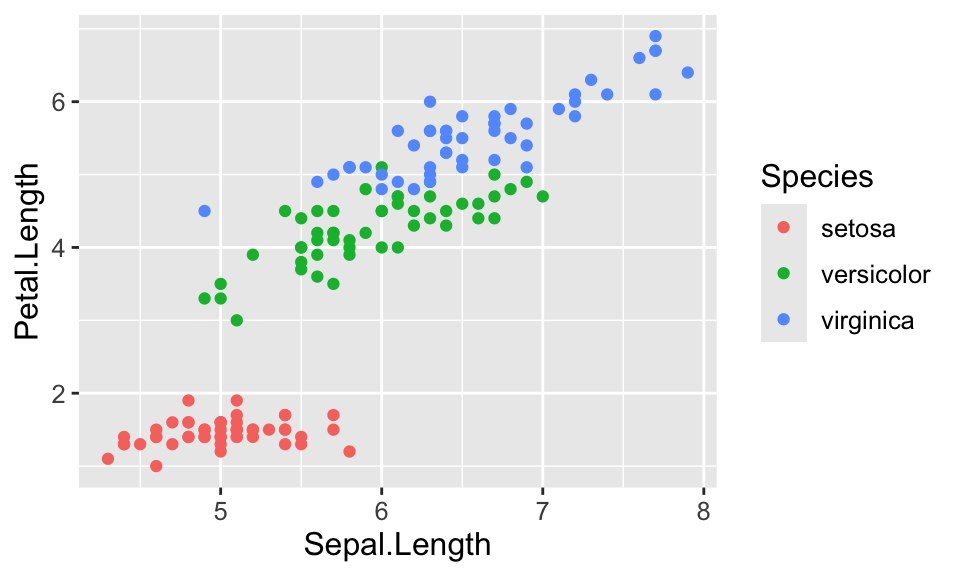
ggplots als Objekte abspeichern | 2
- Nützlich, um weitere Ebenen später hinzuzufügen,
- wenn der Basisplot Grundlage für mehrere Diagramme sein soll (reduziert Tipparbeit)
- oder wenn mehrere Diagramme kombiniert werden sollen.
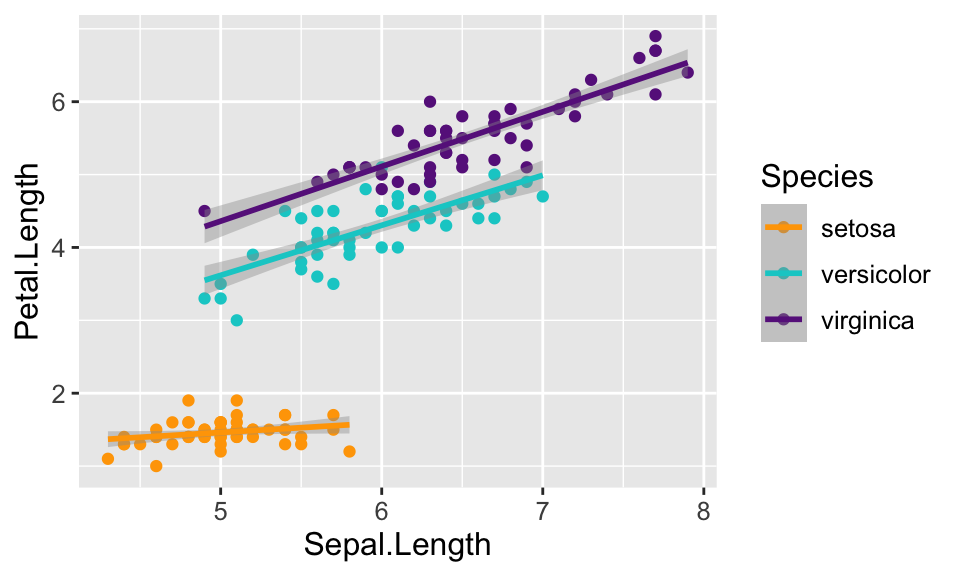
ggplot - Die wichtigsten geom_XXX() Funktionen
Histogramm | geom_histogram()
Nur eine metrische Variable auf der x-Achse – die Häufigkeiten (y) berechnet ggplot2 selbst:
Verteilung der Kronblattlänge
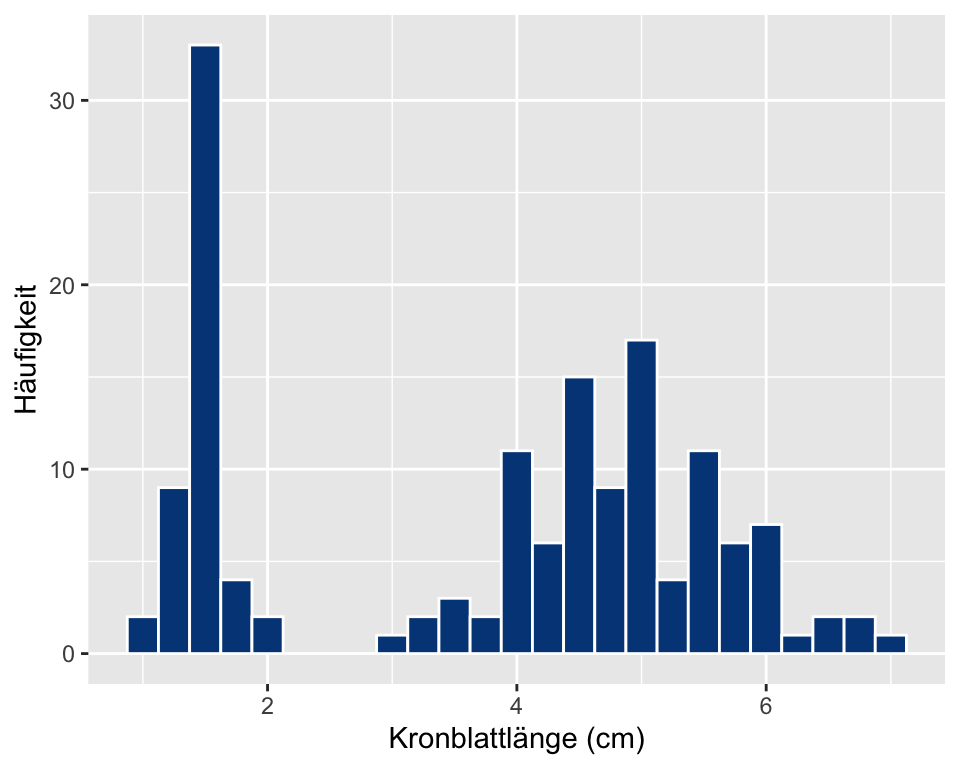
→ Mit binwidth (Klassenbreite) oder bins (Anzahl Klassen) legen Sie die Einteilung fest. Probieren Sie verschiedene Werte aus, die Form der Verteilung kann sich deutlich ändern!
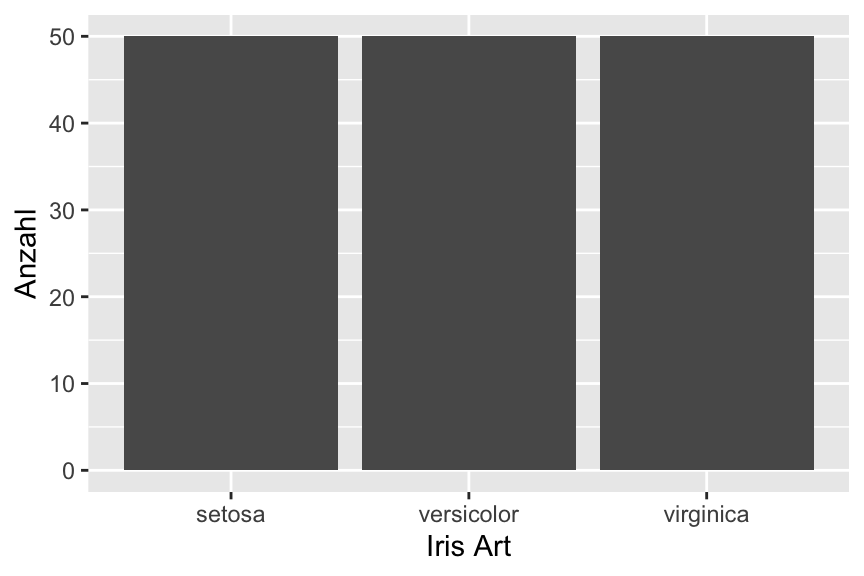
Säulendiagramm | geom_bar() - ggplot2 zählt selbst
Nur x angeben, die Höhe = Anzahl der Zeilen pro Kategorie:
Anzahl Messwerte pro Art
x (Species) ist hier bereits kategorial (nominal):
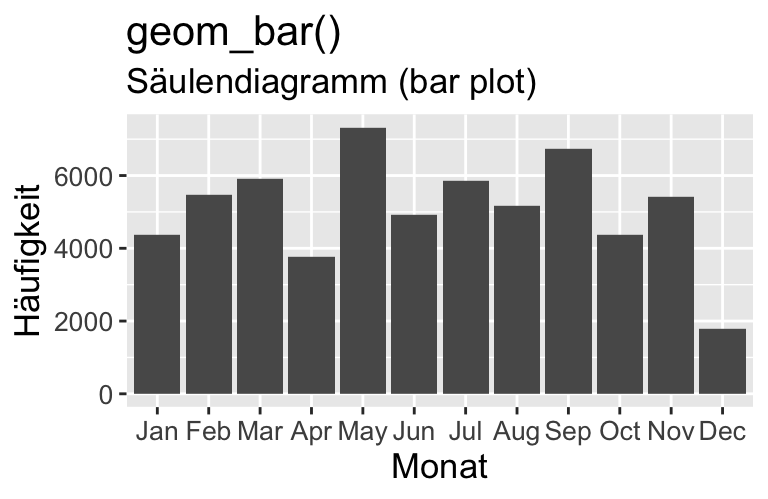
Anzahl Blüten pro Kronblattbreiten-Klasse
x (Petal.Width) in Klassen (ordinal) umwandeln:
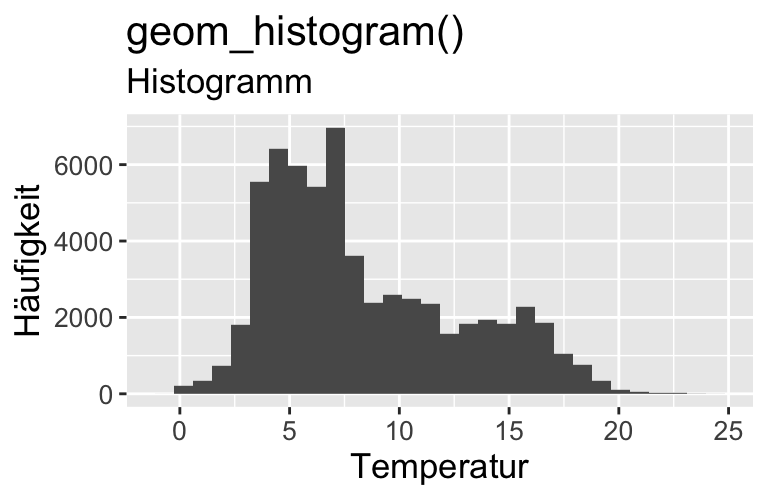
Säulendiagramm | geom_col() - Werte liegen schon vor
x und y angeben, z.B. nach einer Aggregation mit dplyr:
Säulendiagramm | geom_col() - Werte liegen schon vor
x und y angeben, z.B. nach einer Aggregation mit dplyr:
Gruppenvergleich: Mittlere Kronblattlänge pro Art
Mittelwerte immer mit Fehlerbalken zeigen! Und angeben, welches Maß sie darstellen: SD (Streuung der Daten), SE (Genauigkeit des Mittelwerts: sd(x) / sqrt(n())) oder 95 %-KI.
Boxplot | geom_boxplot()
Eine kategoriale Variable (x) und eine metrische Variable (y) – für den Vergleich von Verteilungen zwischen Gruppen:
→ Zur Erinnerung: Die Box umfasst die mittleren 50% der Werte (1. bis 3. Quartil), der Strich in der Box ist der Median, Punkte außerhalb der ‘Whisker’ sind potenzielle Ausreißer.
Streudiagramm | geom_point()
Zwei metrische Variablen – für die Untersuchung von Beziehungen:
→ Mit geom_smooth() wird eine Glättungskurve hinzugefügt, mit geom_smooth(method = "lm") eine Regressionsgerade.
Ausblick: Welches Diagramm wann?
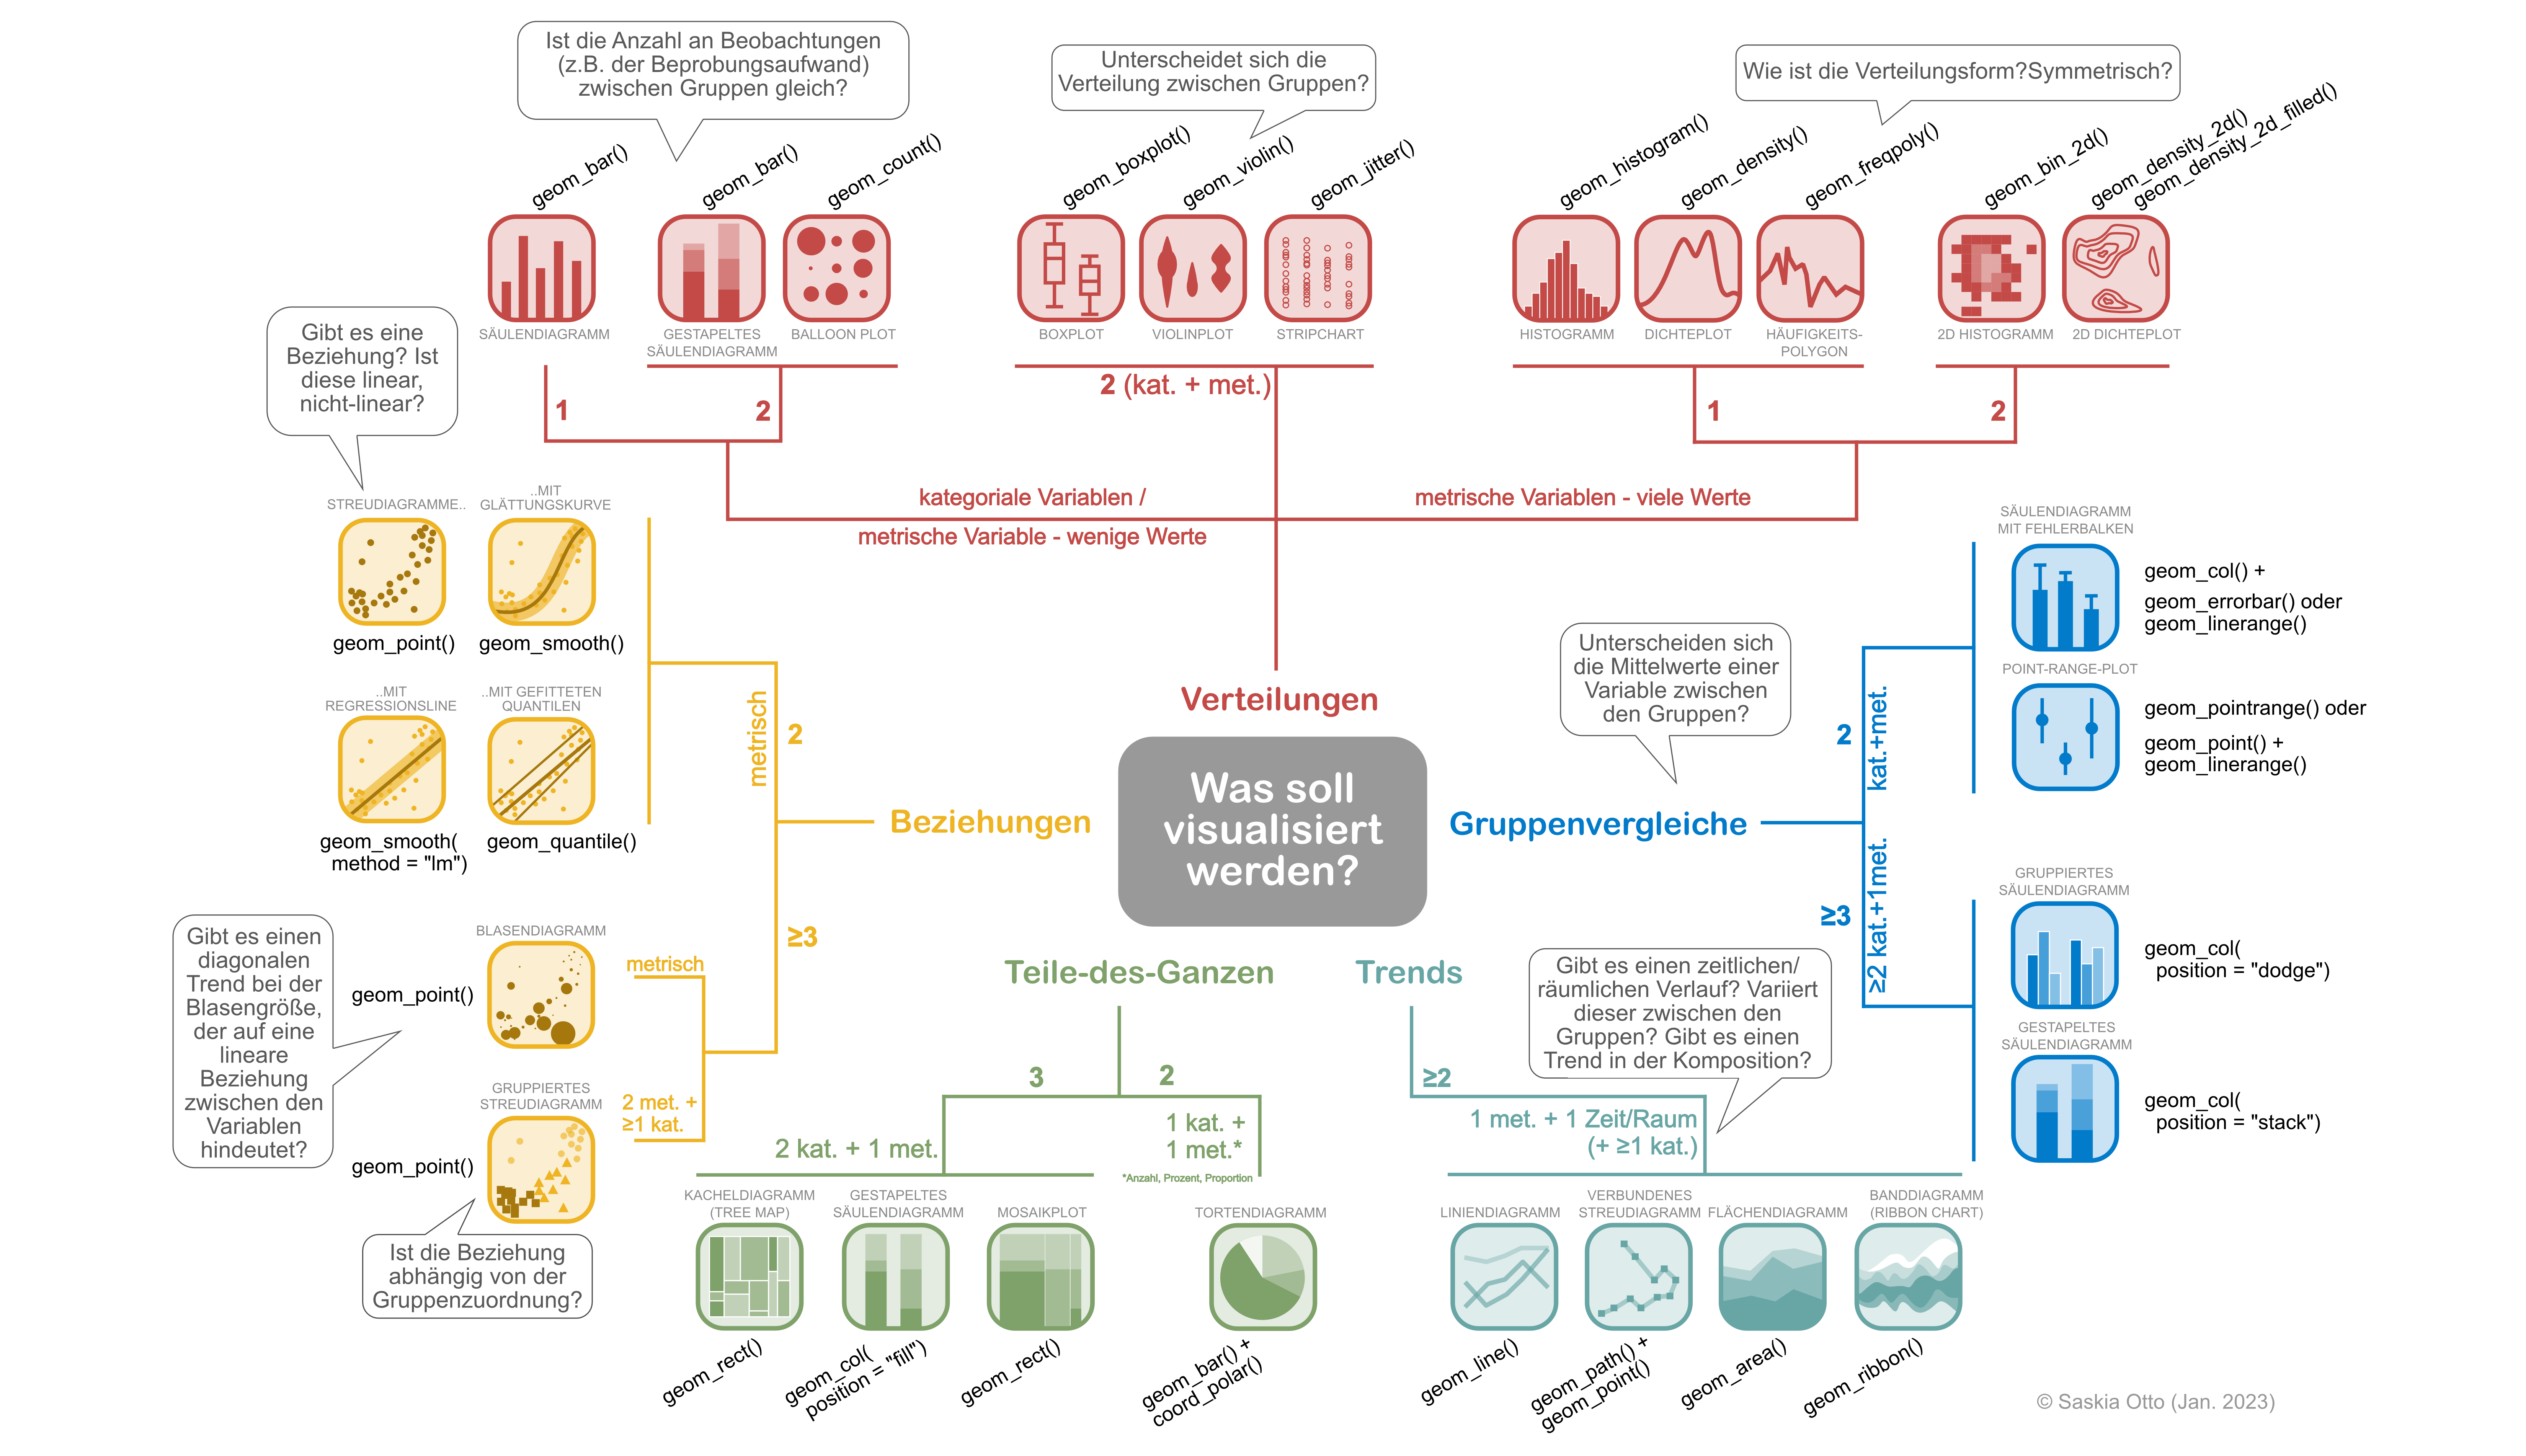
Es gibt noch viele weitere Diagrammtypen und geom-Funktionen. Dieser Entscheidungsbaum hilft bei der Wahl – wie man ihn nutzt und welche Diagramme für welche Fragestellung geeignet sind, besprechen wir in der VL zu den Grundlagen der Datenvisualisierung.
Your turn …

Quiz 1-5 | ggplots

Q1 | Häufigkeitsverteilung
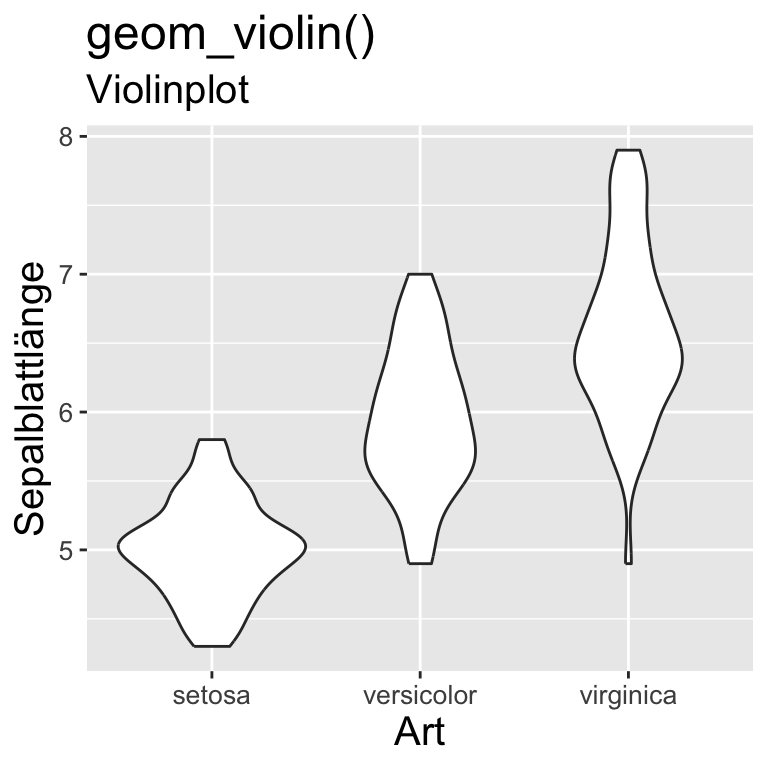
Q2 | Gruppenvergleich
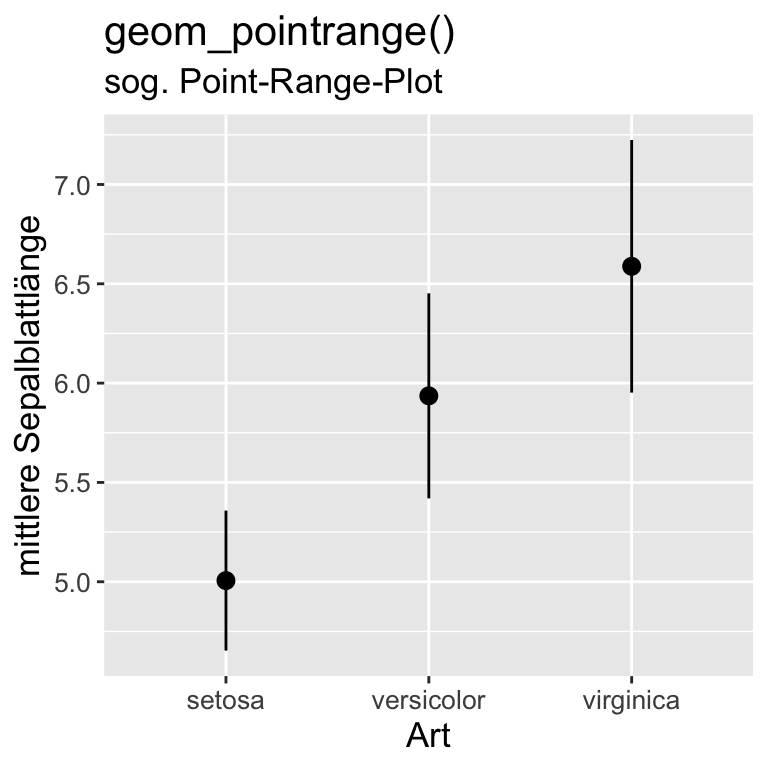
Q3 | Gruppenvergleich
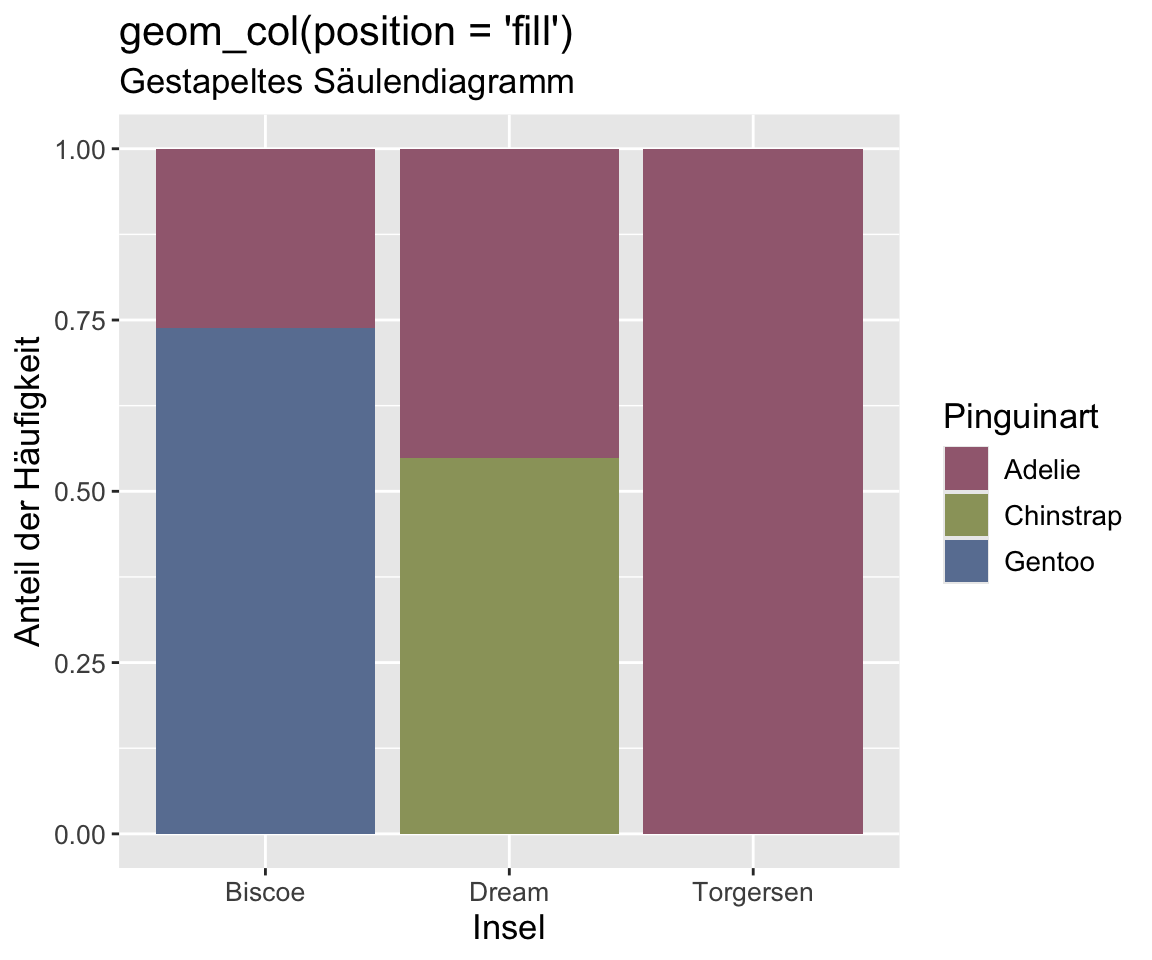
Q4 | Beziehung
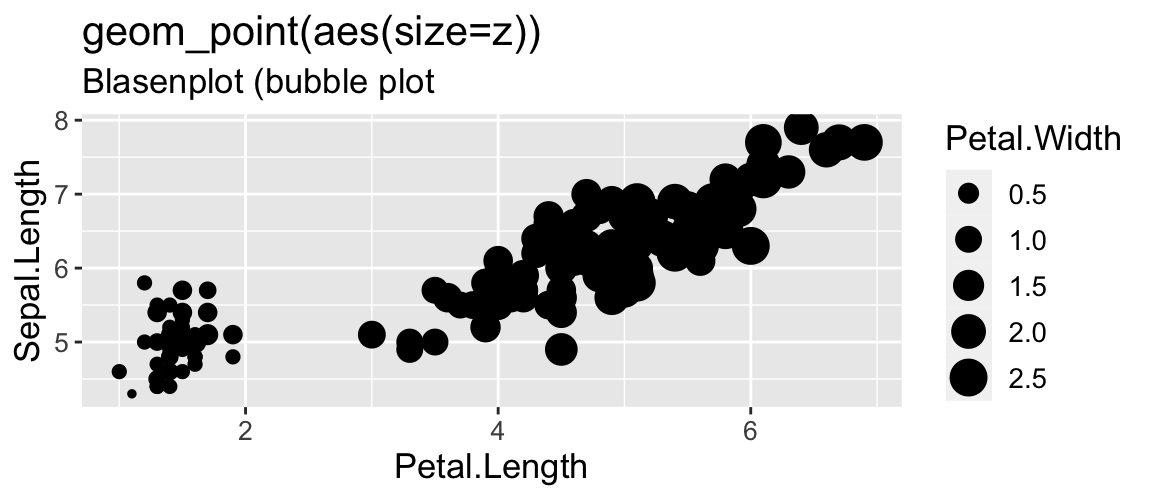
Q5 | Beziehung
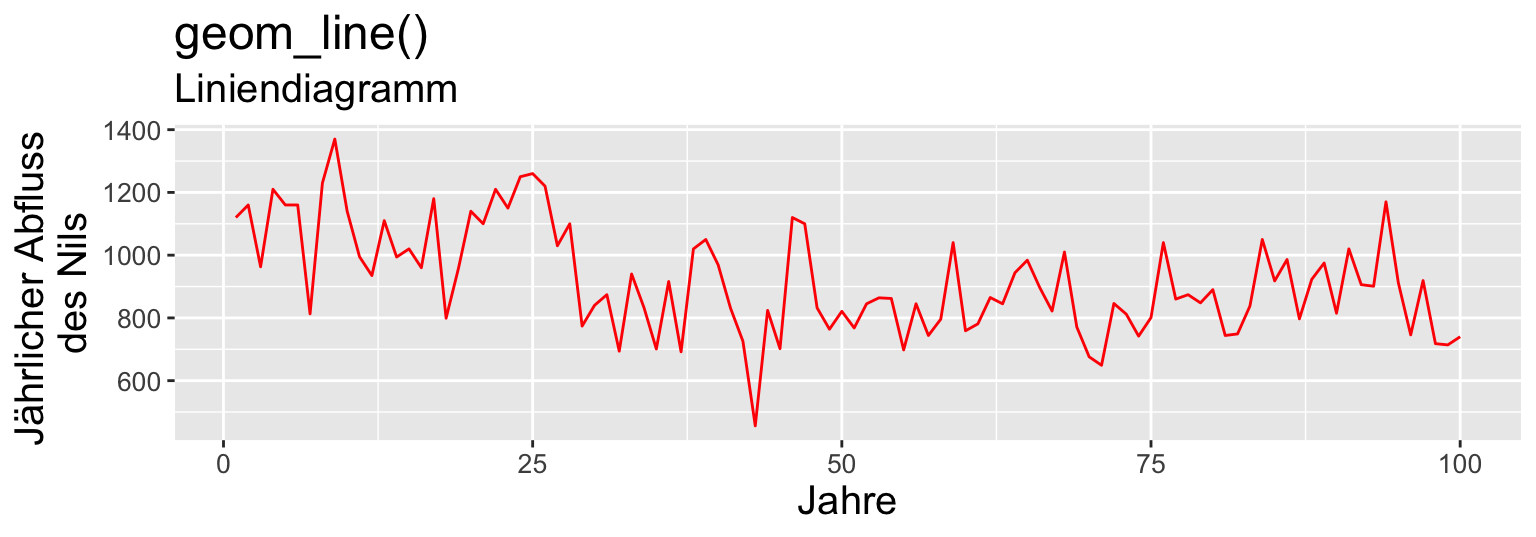
Zurück zu unseren Demos..
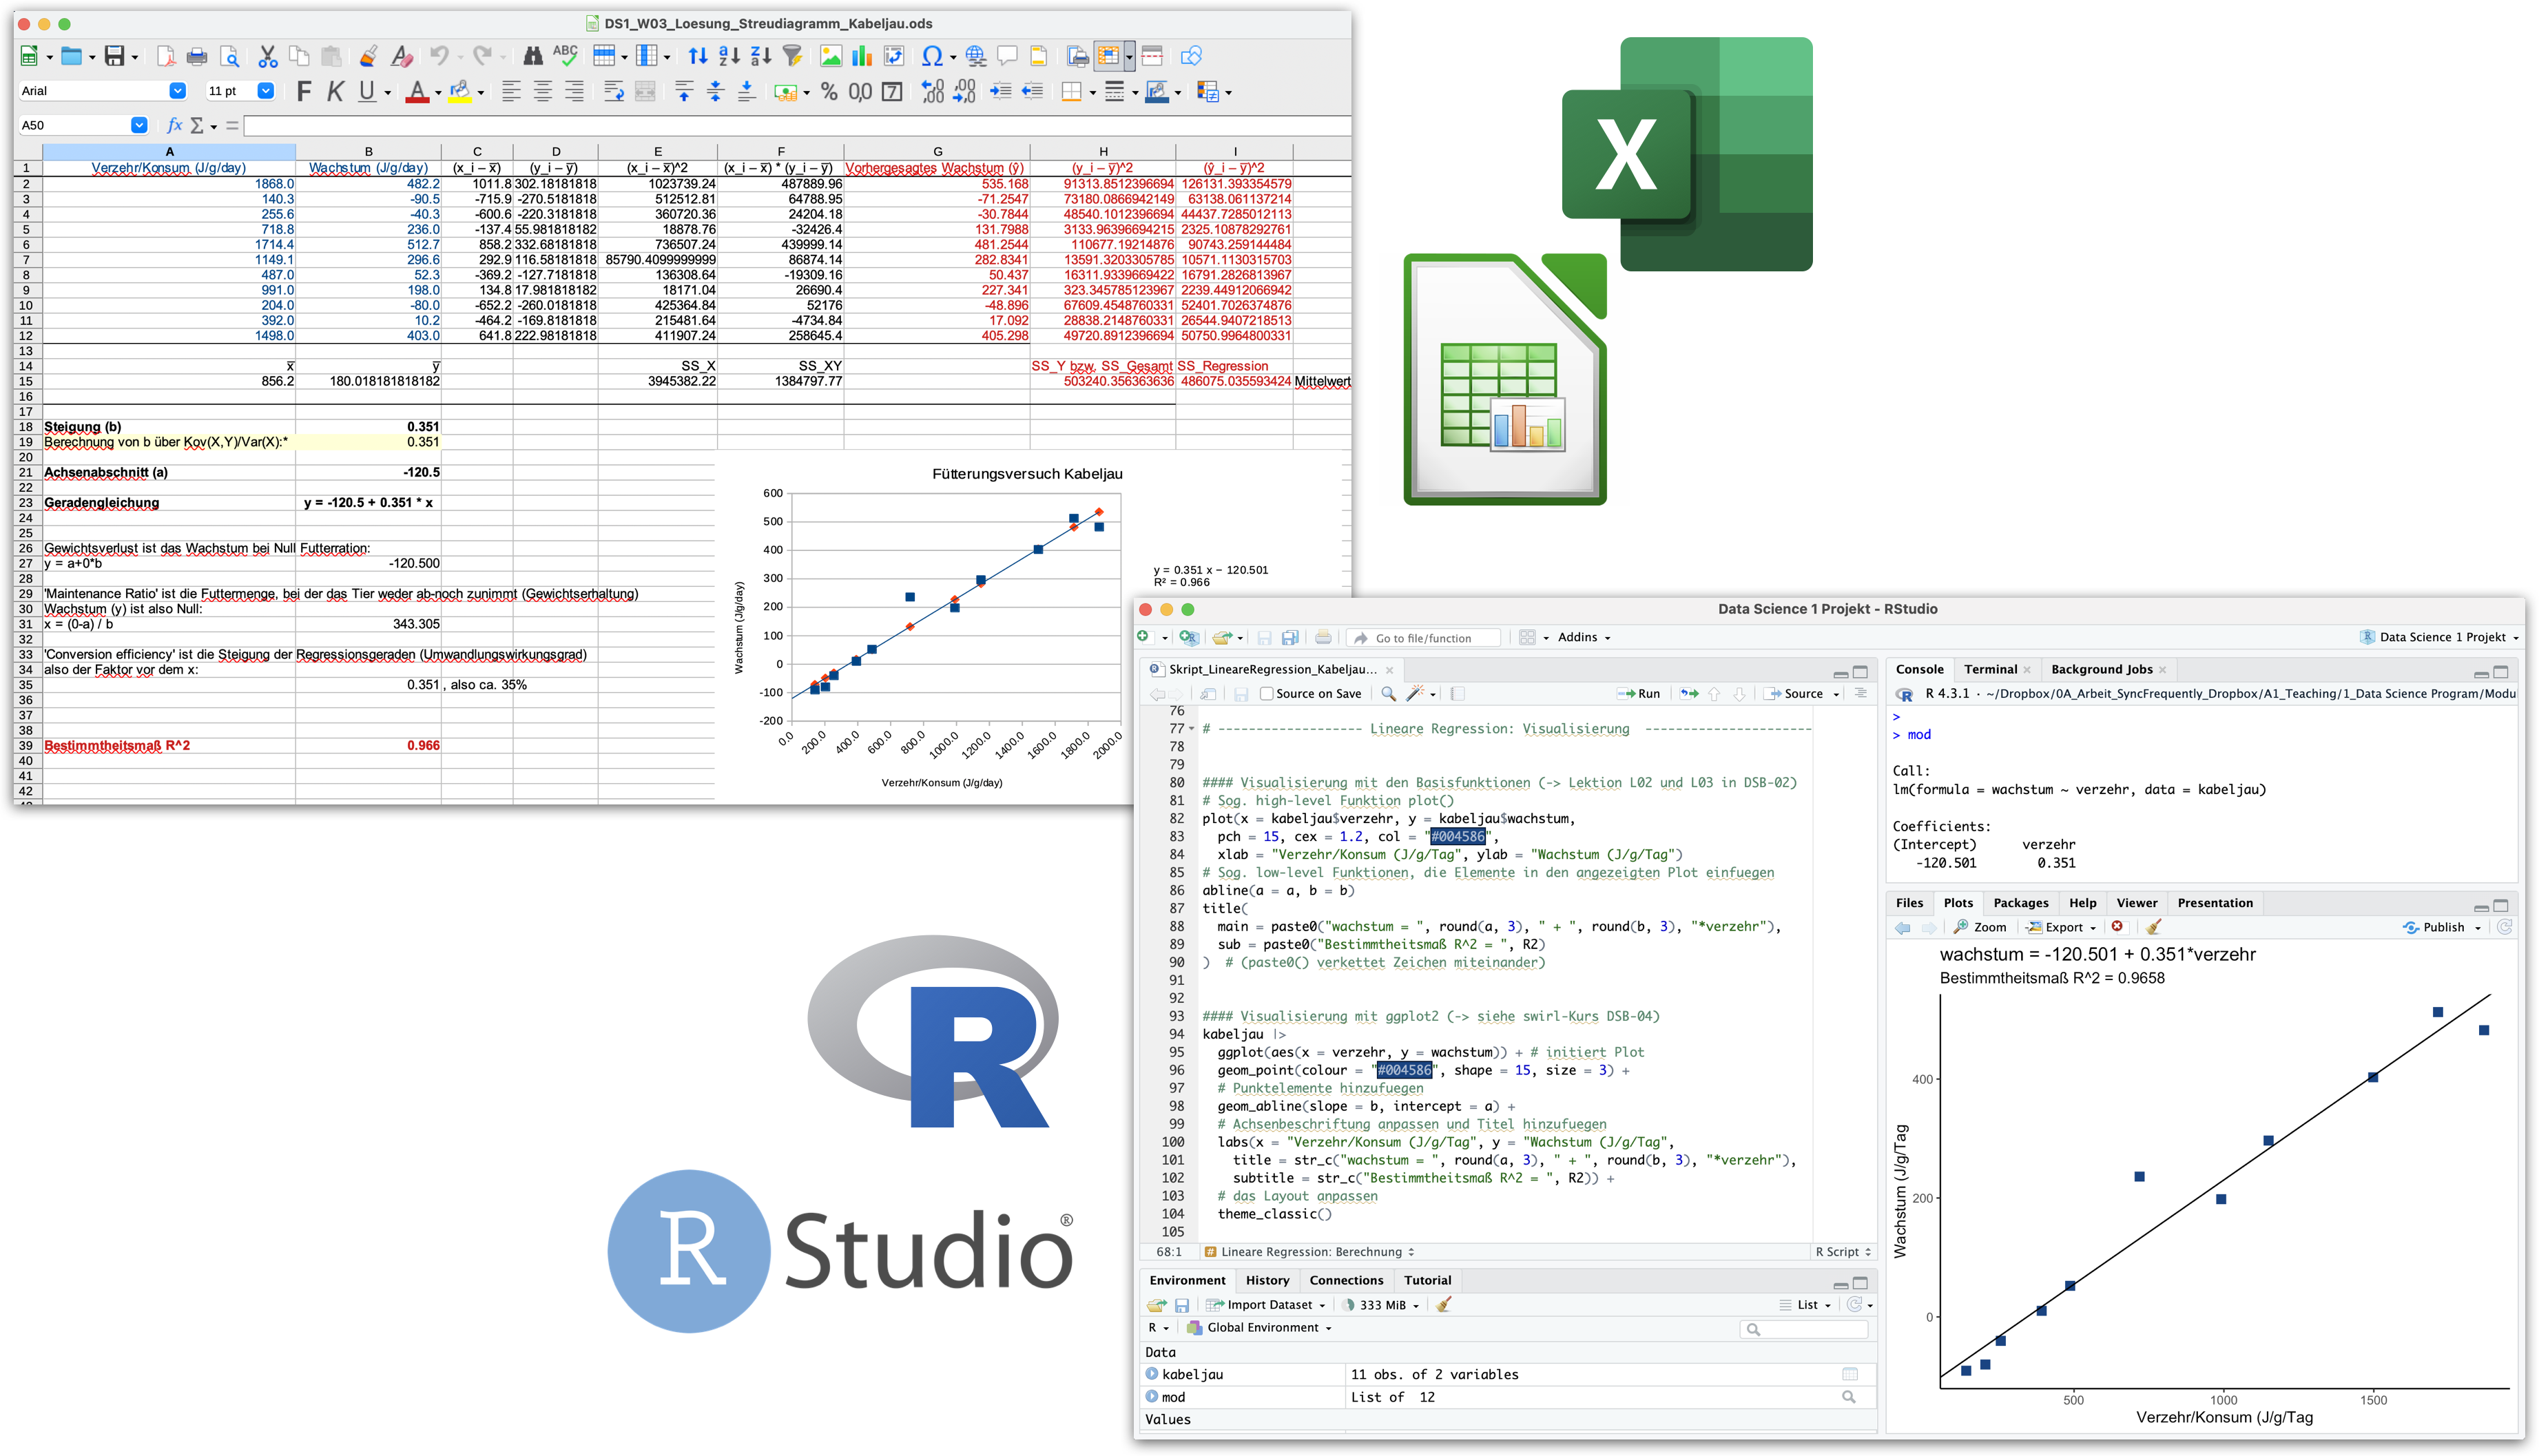
Von Calc zu R wechseln | Demo A
Lineare Regression zum
Fütterungsversuch beim Kabeljau
Was haben wir gerade gelernt?
# ------------------------------ Vorbereitung ----------------------------------

#### Laden von Paketen
library(tidyverse)
# library(readODS)
# library(readxl)
library(DSBtools)
options(DSBtools.language = "de") # Ausgabe auf Deutsch


#### Eigene Funktionen


# -------------------- Import und Datenaufbereitung ----------------------------

#### Import einer Textdatei im CSV-Format (das gängigste Format)
kabeljau_csv <- read.csv(file = "data/Wachstum-Futter.csv")
str(kabeljau_csv) # --> Output ist ein data frame


#### Import von Calc- und Excel-Dateien (ODS- und XLSX-Format)

# Import einer ODS-Datei mit dem 'readODS' Paket
kabeljau <- readODS::read_ods("data/DS1_W03_Streudiagramm_Kabeljau.ods",
  sheet = "Daten_Visualisierung")
str(kabeljau) # --> Output ist ein Tibble

# Import einer XLSX-Datei mit z.B. dem 'readxl' Paket
kabeljau_xlsx <- readxl::read_excel("data/DS1_W03_Streudiagramm_Kabeljau.xlsx",
  sheet = "Daten_Visualisierung")
str(kabeljau_xlsx) # --> Output ist ein Tibble


#### Datensichtung und -transformation

# Anpassen der Spaltennamen
names(kabeljau) <- c("verzehr", "wachstum")
str(kabeljau)

# Wertebereich prüfen
summary(kabeljau)

# Beziehung explorieren: Ist sie linear? Gibt es Ausreisser?
explore_var(x = kabeljau$verzehr, y = kabeljau$wachstum,
  xlab = "Verzehr/Konsum (J/g/Tag)", ylab = "Wachstum (J/g/Tag)")


# ---------------------- Lineare Regression: Berechnung ------------------------
# (-> Lektion L03 in DSB-02-Datenexploration mit R)

#### Manuelle Berechnung

# Um Tipparbeit zu sparen, speichern wir die Spalten als einzelne Vektoren
x <- kabeljau$verzehr
y <- kabeljau$wachstum

# Steigungsparameter b berechnen
b <- cov(x = x, y = y)/ var(x) # der shortcut mit der Kovarianz und Varianz
b

# Achsenabschnitt a berechnen
a <- mean(y) - b*mean(x)
a

# Das Bestimmtheitsmass R^2 berechnen
y_pred <- a + b*x   # die vorhergesagten Werte
ss_gesamt <- sum( (y - mean(y))^2 ) # Summenquadrate Gesamt
ss_regression <- sum( (y_pred - mean(y))^2 ) # Summenquadrate der Regression
R2 <- round(ss_regression/ss_gesamt, 4)
R2


##### Zum Vergleich die Regression automatisch berechnen mit lm()

# Erstellung des Modells
mod <- lm(formula = wachstum ~ verzehr, data = kabeljau)
mod

# Ausgabe nur der beiden Koeffizienten
coef(mod)

# Ausgabe aller wichtigen Statistiken des Modells, inklusive von R^2
# (mehr dazu in Data Science 2)
summary(mod)


# ------------------- Lineare Regression: Visualisierung  ----------------------


#### Visualisierung mit den Basisfunktionen (-> Lektion L02 und L03 in DSB-02)
# Sog. high-level Funktion plot()
plot(x = kabeljau$verzehr, y = kabeljau$wachstum,
  pch = 15, cex = 1.2, col = "#004586",
  xlab = "Verzehr/Konsum (J/g/Tag)", ylab = "Wachstum (J/g/Tag)")
# Sog. low-level Funktionen, die Elemente in den angezeigten Plot einfügen
abline(a = a, b = b)
title(
  main = paste0("wachstum = ", round(a, 3), " + ", round(b, 3), "*verzehr"),
  sub = paste0("Bestimmtheitsmaß R^2 = ", R2)
)  # (paste0() verkettet Zeichen miteinander)


#### Visualisierung mit ggplot2 (-> siehe swirl-Kurs DSB-04)
kabeljau |>
  ggplot(aes(x = verzehr, y = wachstum)) + # initiert Plot
  geom_point(colour = "#004586", shape = 15, size = 3) +
  # Punktelemente hinzufügen
  geom_abline(slope = b, intercept = a) +
  # Achsenbeschriftung anpassen und Titel hinzufügen
  labs(x = "Verzehr/Konsum (J/g/Tag)", y = "Wachstum (J/g/Tag)",
    title = str_c("wachstum = ", round(a, 3), " + ", round(b, 3), "*verzehr"),
    subtitle = str_c("Bestimmtheitsmaß R^2 = ", R2)) +
  # das Layout anpassen
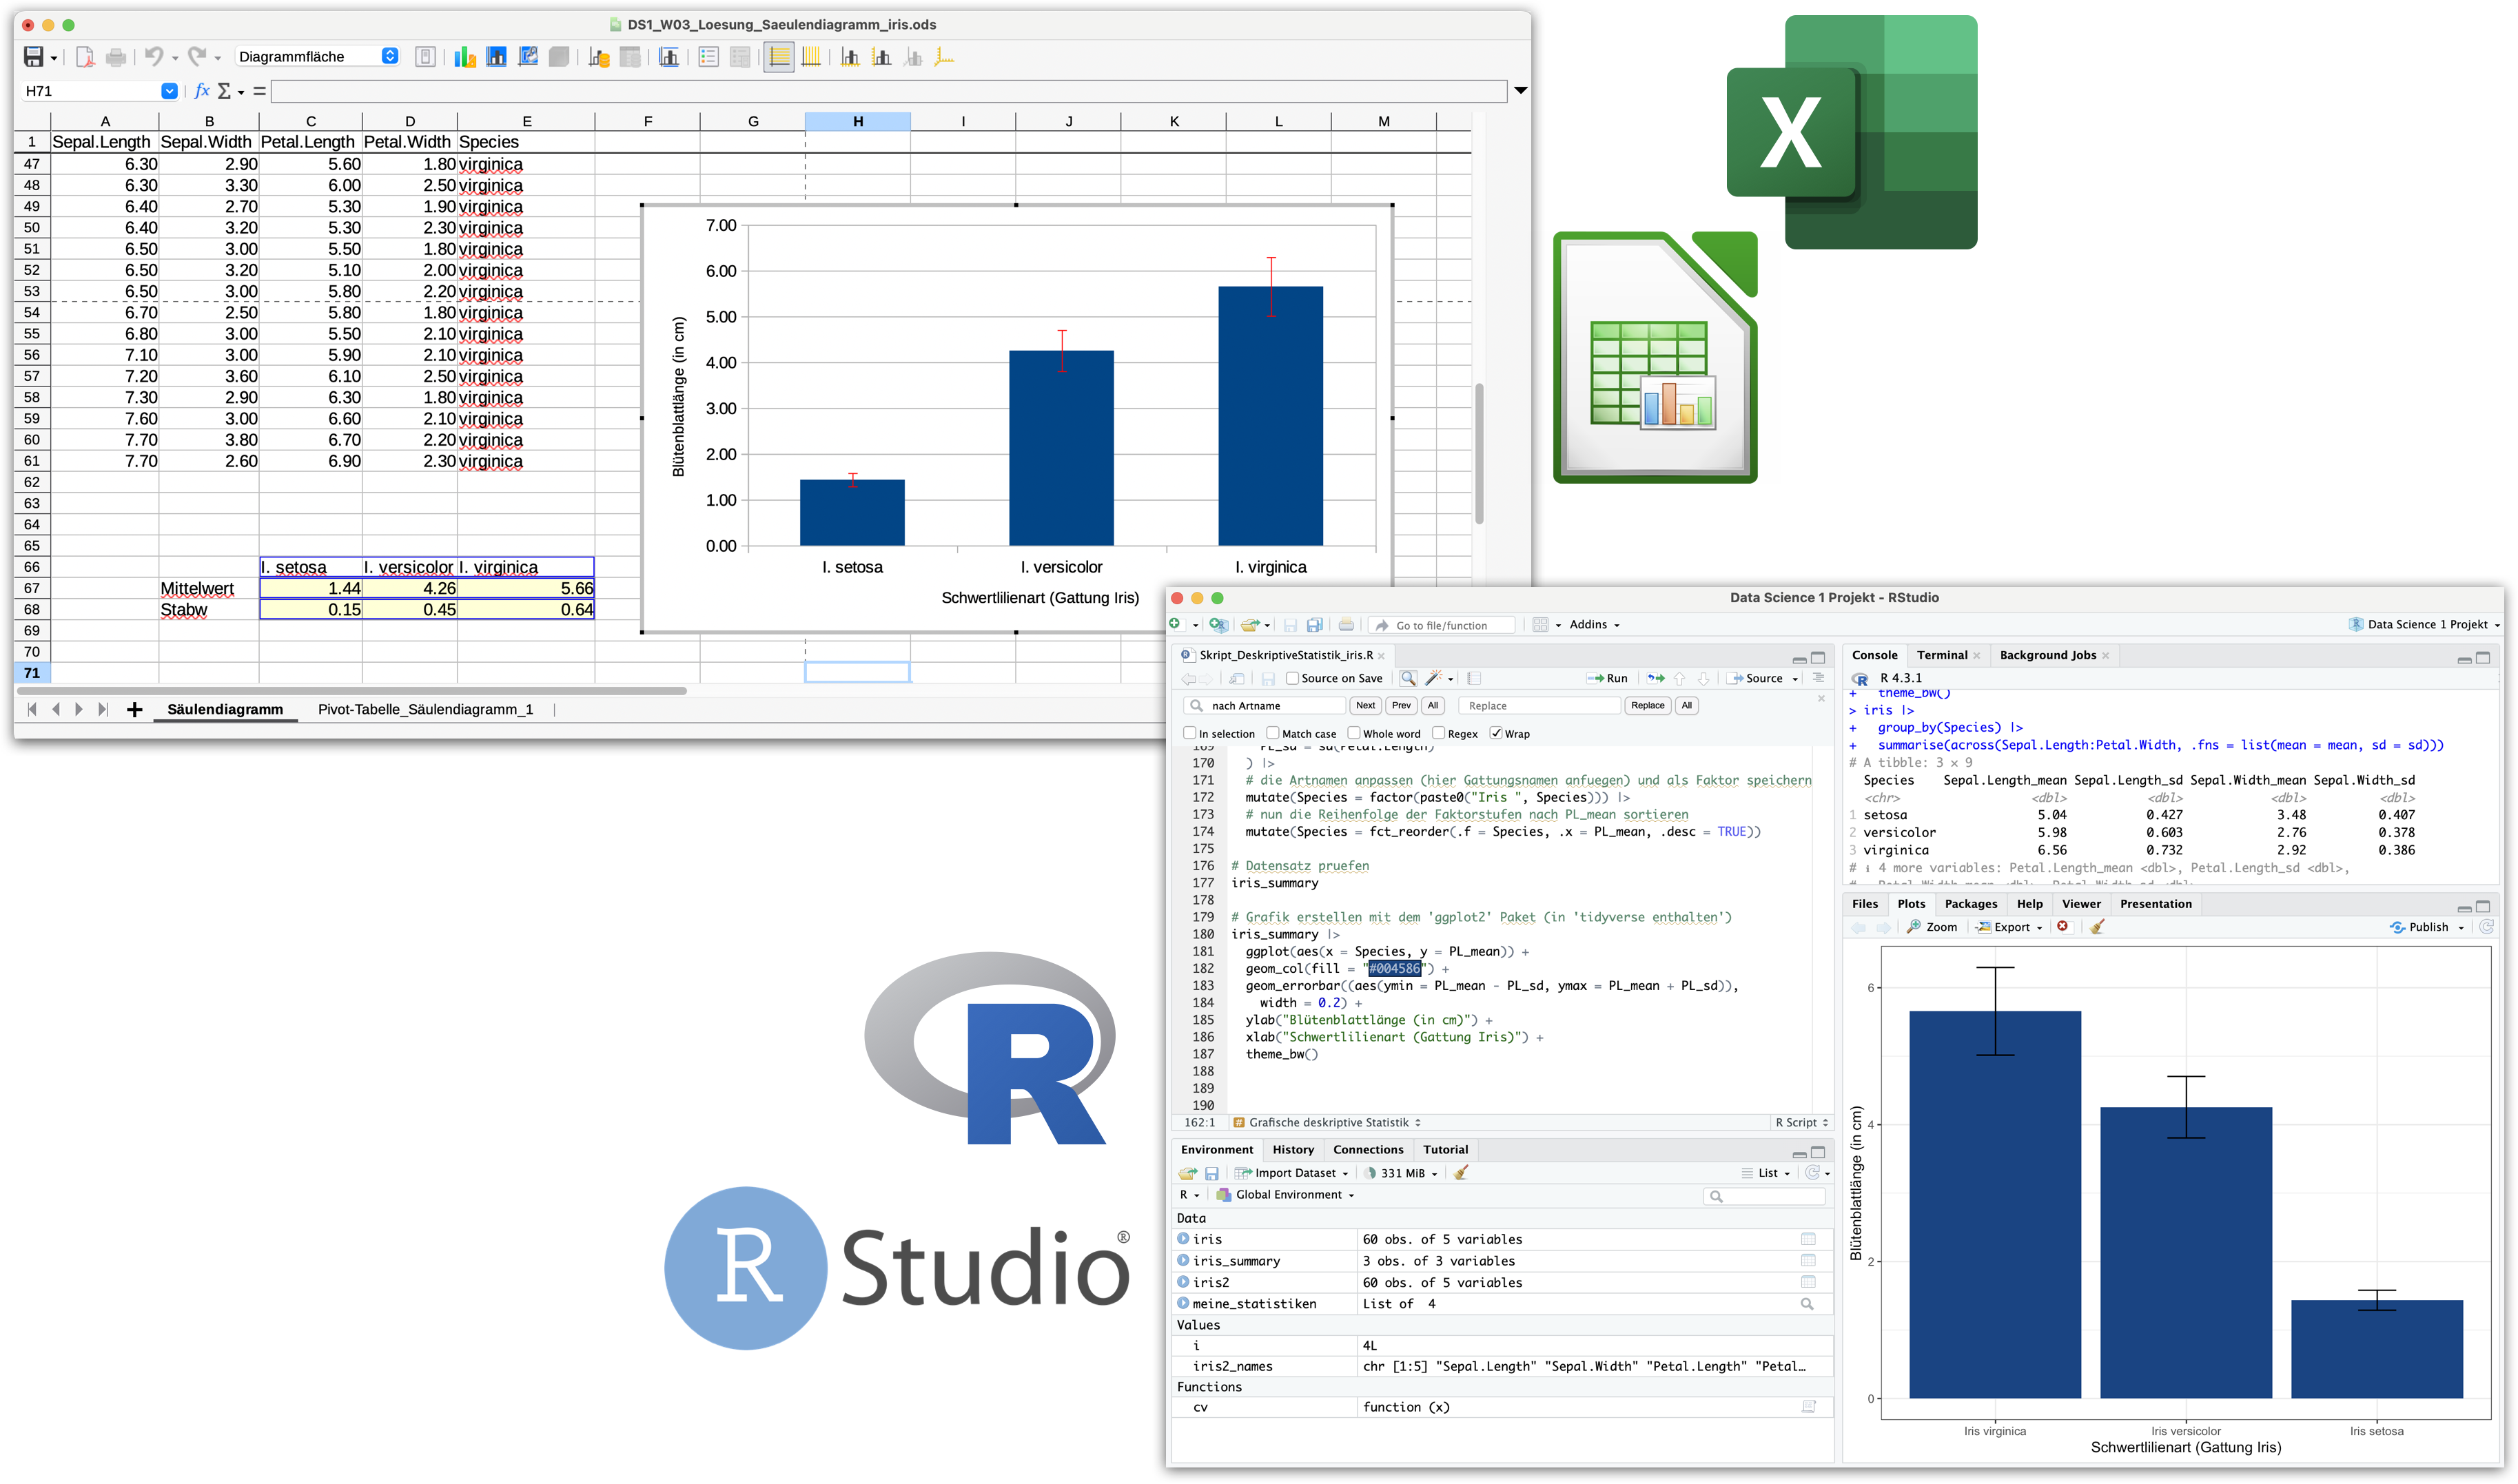
theme_bw()Von Calc zu R wechseln | Demo B
Deskriptive Statistik mit iris
Was haben wir gerade gelernt?
# ------------------------------ Vorbereitung ----------------------------------

#### Laden von Paketen
library(tidyverse) # laedt 9 Pakete

# # (das gleiche wie alle Pakete einzeln zu laden)
# library(dplyr)
# library(forcats)
# library(ggplot2)
# library(lubridate)
# library(purrr)
# library(readr)
# library(stringr)
# library(tibble)
# library(tidyr)

library(DSBtools)
options(DSBtools.language = "de") # Ausgabe auf Deutsch


#### Eigene Funktionen
# Variantionskoeffizient
cv <- function(x) {
  sd(x)/mean(x)
}


# -------------------- Import und Datenaufbereitung ----------------------------

#### Import von CSV-Dateien
# (-> Swirl-Lektion L01 in DSB-03-Datenaufbereitung oder per Anleitung durchs Tidyversum)

# Import der ODS-Datei, welche in den Zeilen 66-68 noch Text enthaelt
iris <- readODS::read_ods("data/DS1_W03_Saeulendiagramm_mit_iris.ods")


#### Prüfung des Imports und Datensichtung
# (-> Swirl-Lektion L02 in DSB-03)

# Prüfung des Datentyps --> IMMER DIREKT NACH DEM IMPORT VERWENDEN!
str(iris)  # str = structure

# Betrachtung des Inhalts
iris
# View(iris)

# Korrektur des Datentyps und der Zeilen
iris <- iris[1:60, ] |>
  mutate(across(Sepal.Length:Petal.Width, as.numeric)) |>
  mutate(Species = as.factor(Species))
str(iris)

# Welche Werte kommen in jeder Spalte vor?
lapply(iris, unique)

### Weitere Funktionen zur Sichtung einzelner Aspekte
head(iris) # zeigt erste 6 Zeilen (Kopfzeilen)
tail(iris) # zeigt letzte 6 Zeilen (Endzeilen)
class(iris) # Identifikation der Objektklasse (Vektor, Matrix, dataframe,..)
nrow(iris) # Anzahl Zeilen
ncol(iris) # Anzahl Spalten
dim(iris) # Anzahl aller Dimensionen
names(iris) # Spaltennamen
typeof(iris$Sepal.Length) # Datentyp von Spalte 'Sepal.Length'
typeof(iris$Species)      # Datentyp von Spalte 'Species'


# ----------------------- Deskriptive Statistik --------------------------------

#### Berechnung mehrerer Statistiken für jede Spalte im data frame

# Klassische Zusammenfassung mit base R (Ausgabe nur in der Konsole)
summary(iris)

# Shortcut mit DSBtools: Statistiken für jede Spalte, passend zum erkannten
# Variablentyp (z.B. Häufigkeiten bei 'Species', Mittelwert & Co. bei den
# metrischen Spalten). Das Ergebnis ist ein Objekt, mit dem Sie weiterarbeiten
# können - speichern Sie es dazu unter einem Namen:
describe_df(data = iris)


#### Berechnung versch. Statistiken der Kronblattlaenge, gruppiert nach Art
# (-> Lektion L01 in DSB-02-Datenexploration mit R)
# (-> Lektion L06-Gruppierte Aggregation in DSB-03)

iris_summary <- iris |>
  group_by(Species) |>
  summarise(
    PL_mean = mean(Petal.Length),                         # Mittelwert
    PL_median = median(Petal.Length),                     # Median
    PL_var = var(Petal.Length),                           # Varianz
    PL_sd = sd(Petal.Length),                             # Standardabweichung
    PL_se = sd(Petal.Length)/sqrt(length(Petal.Length)),  # Standardfehler
    PL_cv = cv(Petal.Length)                              # Variationskoeffizient
  ) |>
  # die Artnamen anpassen (hier Gattungsnamen anfügen) und als Faktor speichern
  mutate(Species = factor(paste0("Iris ", Species))) |>
  # nun die Reihenfolge der Faktorstufen nach PL_mean sortieren
  mutate(Species = fct_reorder(.f = Species, .x = PL_mean, .desc = TRUE))

# Zusammenfassung ansehen
iris_summary

# Kontrolle mit DSBtools: Stimmen Ihre Werte? describe_var() berechnet die
# Statistiken der Variable 'x' getrennt für jede Gruppe in 'by'
# (Angaben zum 95%-Konfidenzintervall -> kommt in Data Science 2)
iris_stats <- describe_var(x = iris$Petal.Length, by = iris$Species)
iris_stats


#### Saeulendiagramm erstellen mit dem 'ggplot2' Paket
#  (siehe auch swirl-Kurs DSB-04-Datenvisualisierung mit ggplot2)

iris_summary |>
  ggplot(aes(x = Species, y = PL_mean)) + # initiert Plot
  # die Saeulen hinzufügen
  geom_col(fill = "#004586") +
  # die Fehlerbalken hinzufügen
  geom_errorbar((aes(ymin = PL_mean - PL_sd, ymax = PL_mean + PL_sd)),
    width = 0.2) +
  # Achsenbeschriftung anpassen
  ylab("Kronblattlänge (in cm)") +
  xlab("Schwertlilienart (Gattung Iris)") +
  # das Layout anpassen
theme_bw()Übungen
Optionale swirl-Lektionen zur Vertiefung
Kurs DSB-02-Datenexploration mit R
- L02-Erste grafische Analyse
- L04-Basisgrafik Histogramm
- L05-Basisgrafik Boxplot
- L06-Basisgrafik Säulendiagramm
- L07-Basisgrafik Streudiagramm
- L08-Globale Einstellungen und Grafiken exportieren
Kurs DSB-04-Datenvisualisierung mit ggplot2
- L01-Geschichtete Grammatik-Eine Einfuehrung in ggplot2
- L02-geom_Funktionen für Verteilungen kategorialer Variablen
- L03-geom_Funktionen für Verteilungen kontinuierlicher Variablen
- L04-geom_Funktionen für Gruppenvergleiche von Verteilungen
- L05-geom_Funktionen für Gruppenvergleiche
- L06-geom_Funktionen für Beziehungen
- L07-geom_Funktionen für Trends
Übungsaufgaben Woche 9
Alle Aufgaben der Übungswoche finden Sie im Handbuch:
- die zu bearbeitenden Übungsskripte
- die (optionalen) swirl-Lektionen und
- den aktuellen Stand der Fallstudie.
- Die Übungsskripte und Daten liegen in Ihrem R-Projektordner DS1-R-Uebungen (Unterordner uebungsskripte bzw. data).
- Öffnen Sie immer zuerst die Projektdatei DS1-R-Uebungen.Rproj, dann stimmen alle Dateipfade.
Optionale Challenge 1: Grafik erstellen
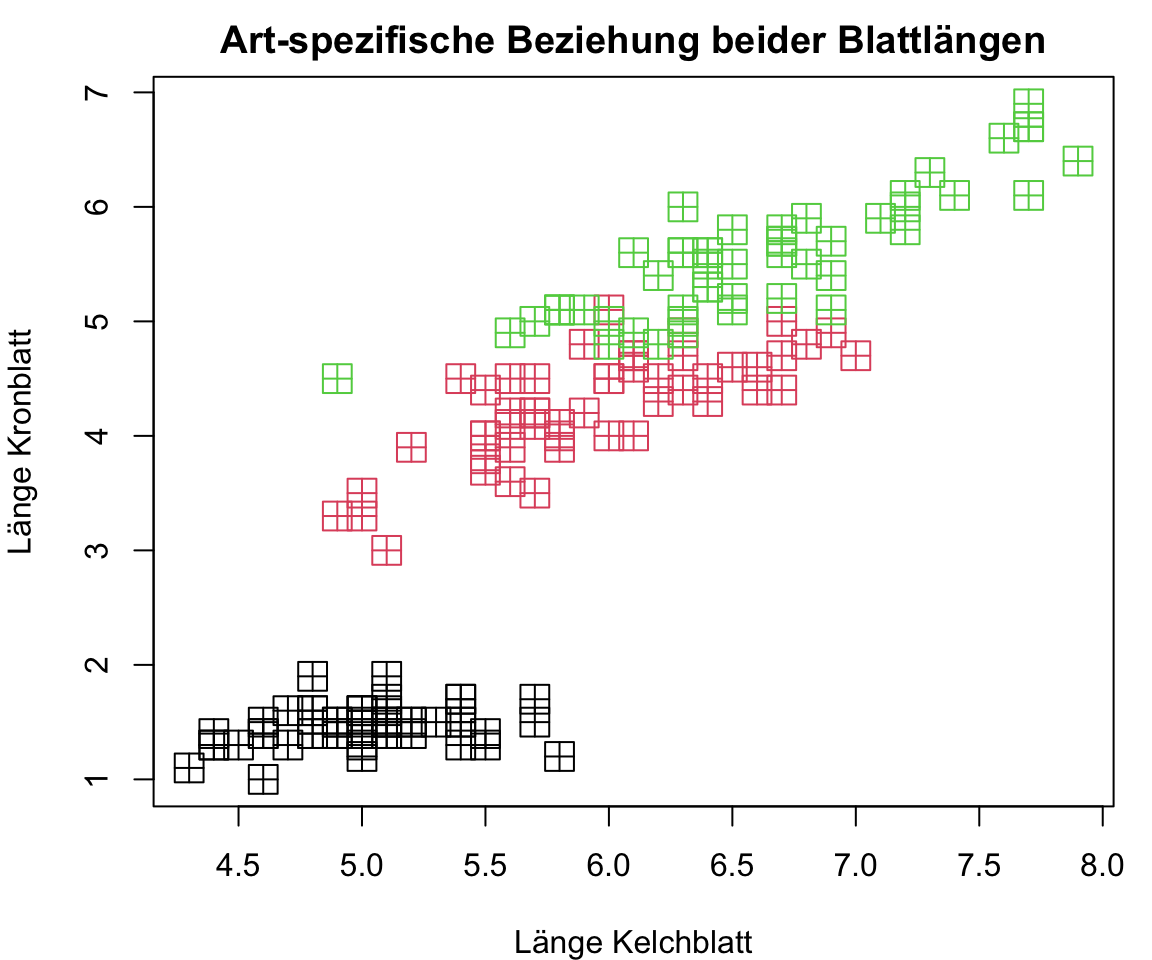
Versuchen Sie einen der beiden Plots mit dem iris Datensatz in base R bzw. ‘ggplot2’ zu reproduzieren:
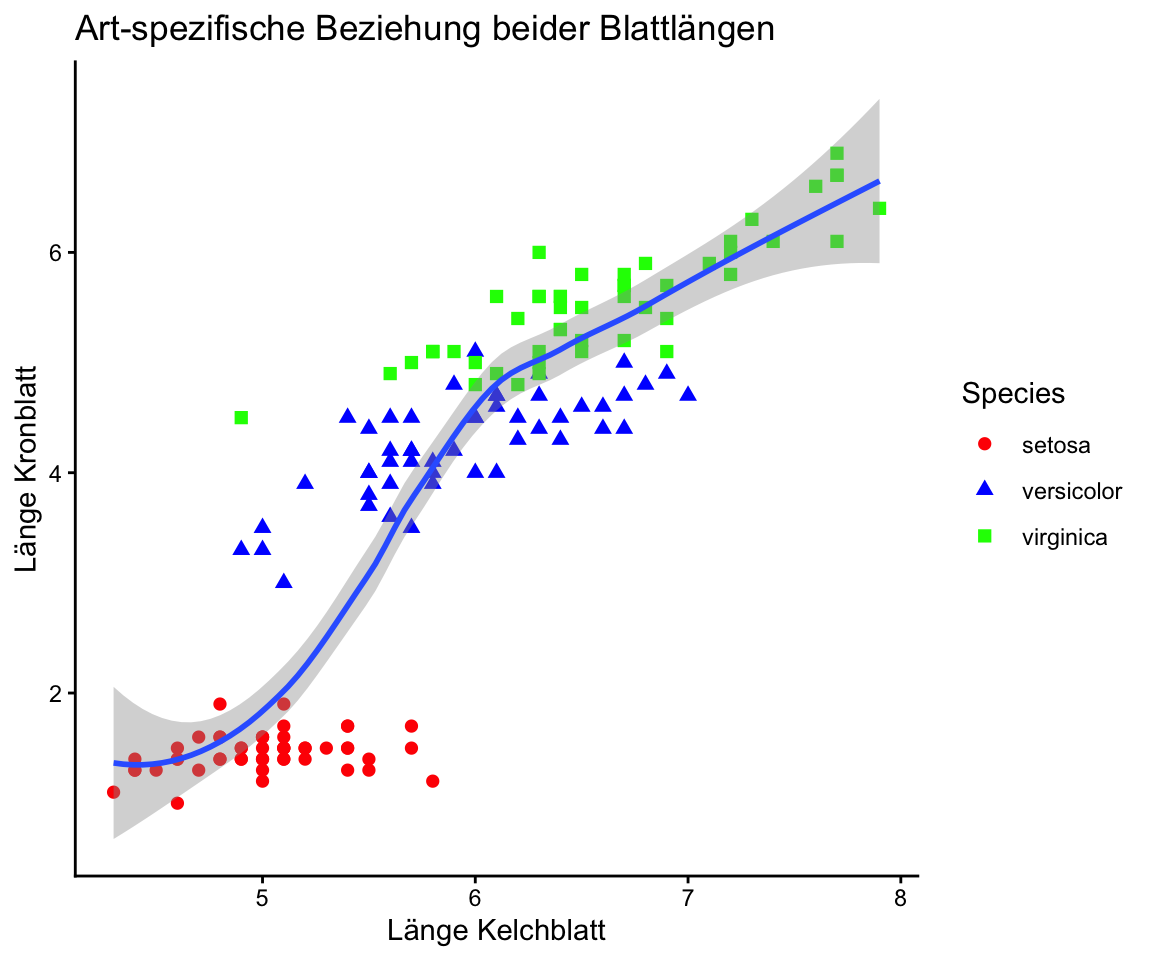
library(tidyverse) # oder library(ggplot2)

ggplot(iris,
    aes(
      x = Sepal.Length,
      y = Petal.Length
    )
  ) +
  # Farbe und Form nur fuer die Punkte (lokal),
  # damit geom_smooth() EINE Kurve fuer alle Daten zeichnet
  geom_point(aes(color = Species, shape = Species),
    size = 2) +
  geom_smooth() +
  scale_colour_manual(values =
    c("red", "blue", "green")) +
  labs(
    x = "Länge Kelchblatt",
    y = "Länge Kronblatt",
    title = "Art-spezifische Beziehung beider Blattlängen"
  ) +
  theme_classic()
Optionale Challenge 2: Grafik erstellen
und abspeichern
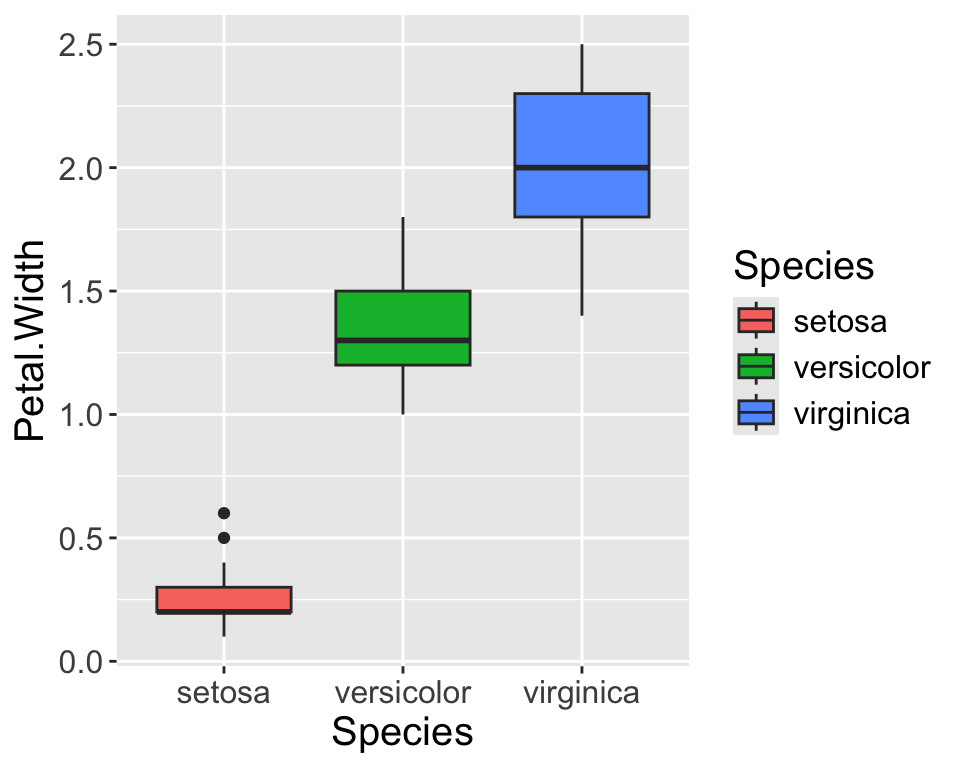
Versuchen Sie folgenden Plot mit dem iris Datensatz in base R zu reproduzieren und diesen als PDF abzuspeichern:
Wie fühlen Sie sich jetzt…?
Total konfus?
Dann schauen Sie sich doch mal…
- …folgende Weblinks zur Diagrammerstellung mit den built-in Funktionen für Basisplots an:
- das ggplot2 Cheatsheet genauer an.
- und lesen Sie das Kapitel Data visualization über Datenvisualisierung mit ggplot2 in ‘R for Data Science’ (2. Auflage).
Posit Cheatsheet
Überblick an Funktionen im ggplot2 Paket
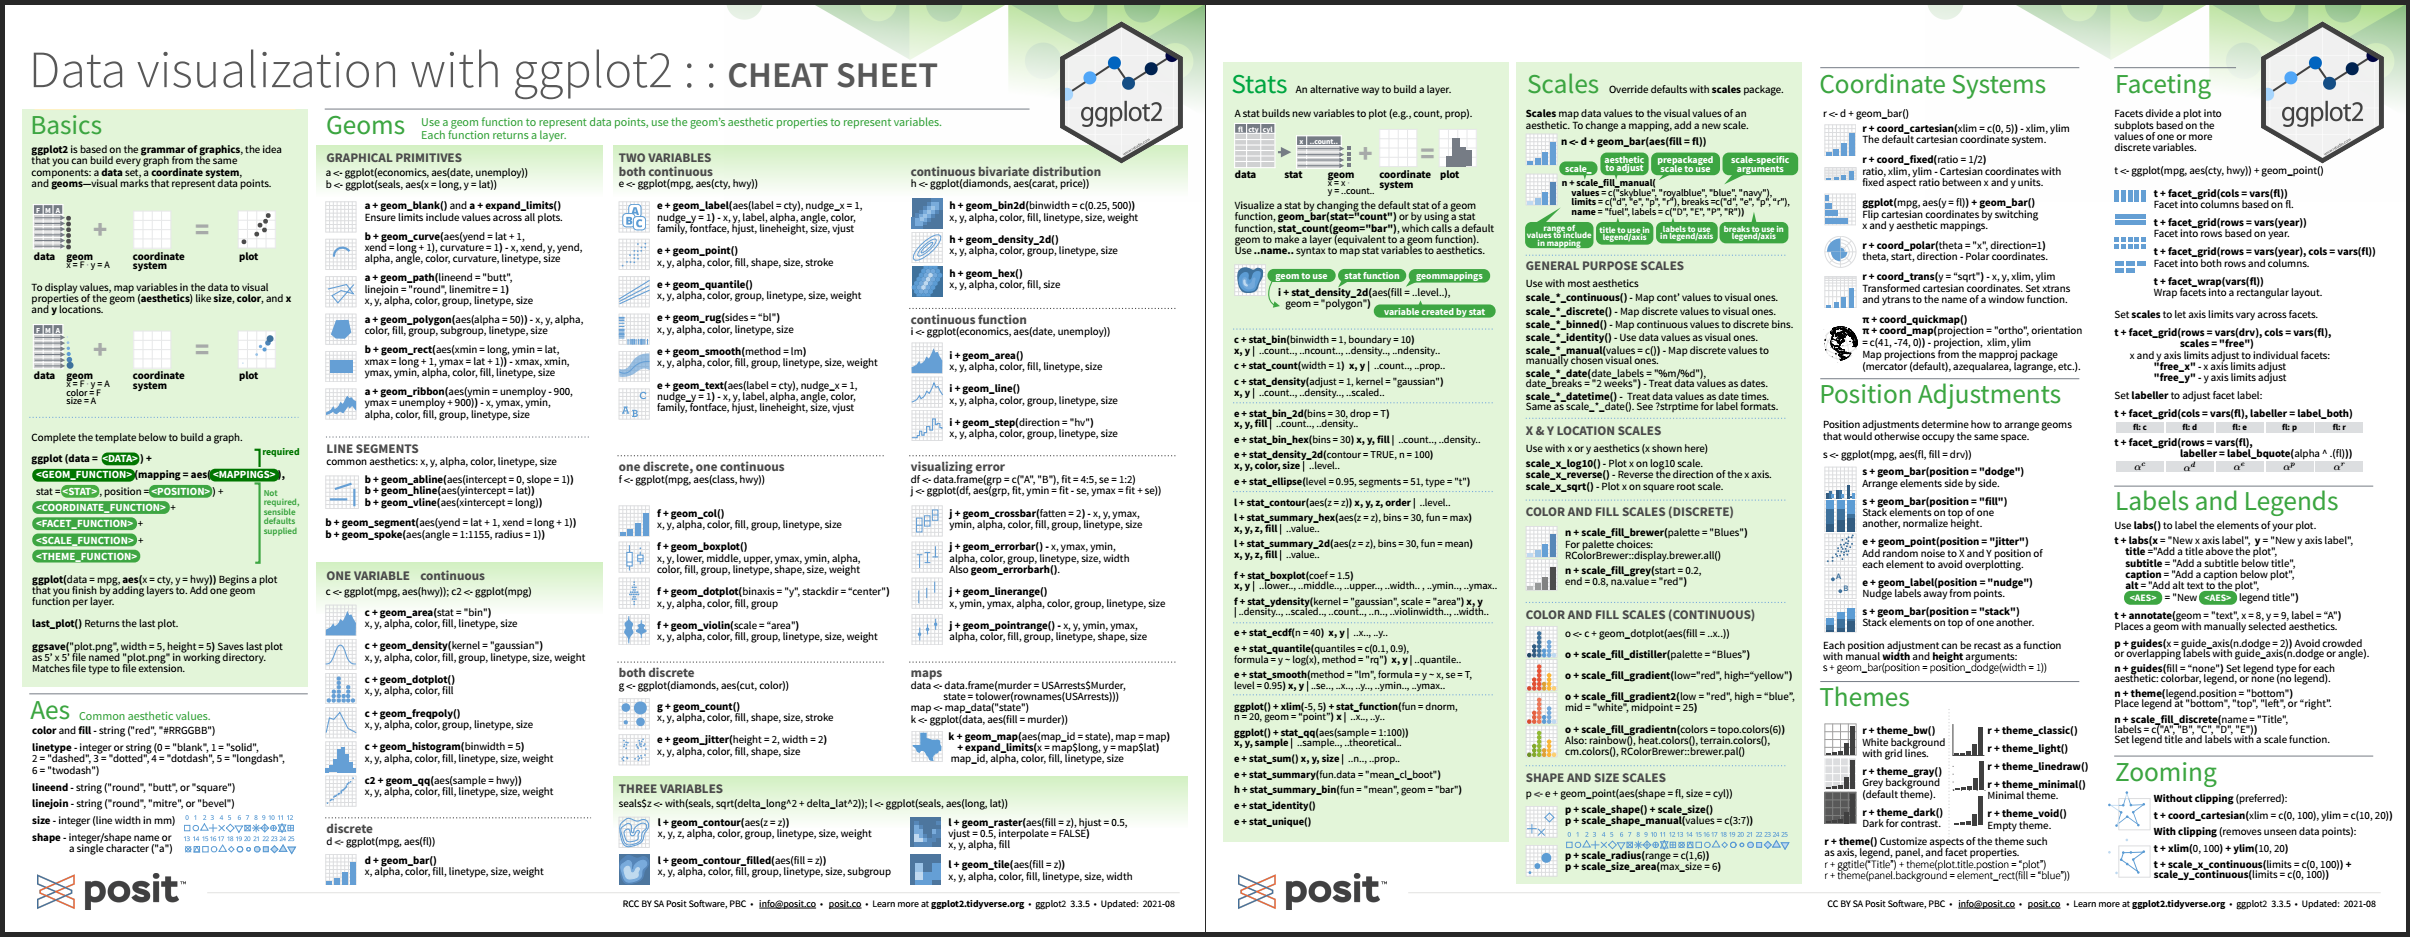
Cheatsheet zum ggplot2 Paket frei verfügbar unter diesem Link.
Total gelangweilt?
Dann testen Sie doch Ihr Wissen in folgendem Abschlussquiz und probieren Sie diese Challenges..
Abschlussquiz
Bei weiteren Fragen: saskia.otto(at)uni-hamburg.de

Diese Arbeit ist lizenziert unter einer Creative Commons Attribution-ShareAlike 4.0 International License mit Ausnahme der entliehenen und mit Quellenangabe versehenen Abbildungen.