Datenaufbereitung mit tidyverse:
Transformation und Anreicherung

Data Science 1 - Programmieren & Visualisieren

Saskia Otto & Monika Eberhard

Universität Hamburg, IMF

Wintersemester

Lernziele

Am Ende dieser VL- und Übungseinheit werden Sie

  • … die grundlegenden Kenntnisse der Datensatztransformation, -aggregation und -kombination entsprechend einer Fragestellung beherrschen.
  • Dazu gehört
    • das Sortieren und Filtern von Zeilen,
    • das Auswählen und die Neuerstellung von Spalten, sprich Variablen,
    • das Verknüpfen mehrerer Schritte mit dem ‘pipe’ Operator |>,
    • das Aggregieren und die (gruppenspezifische) Erstellung von deskriptiven Statistiken und
    • das Kombinieren von Tabellen über gemeinsame Spalten (Joins).

Zur Erinnerung

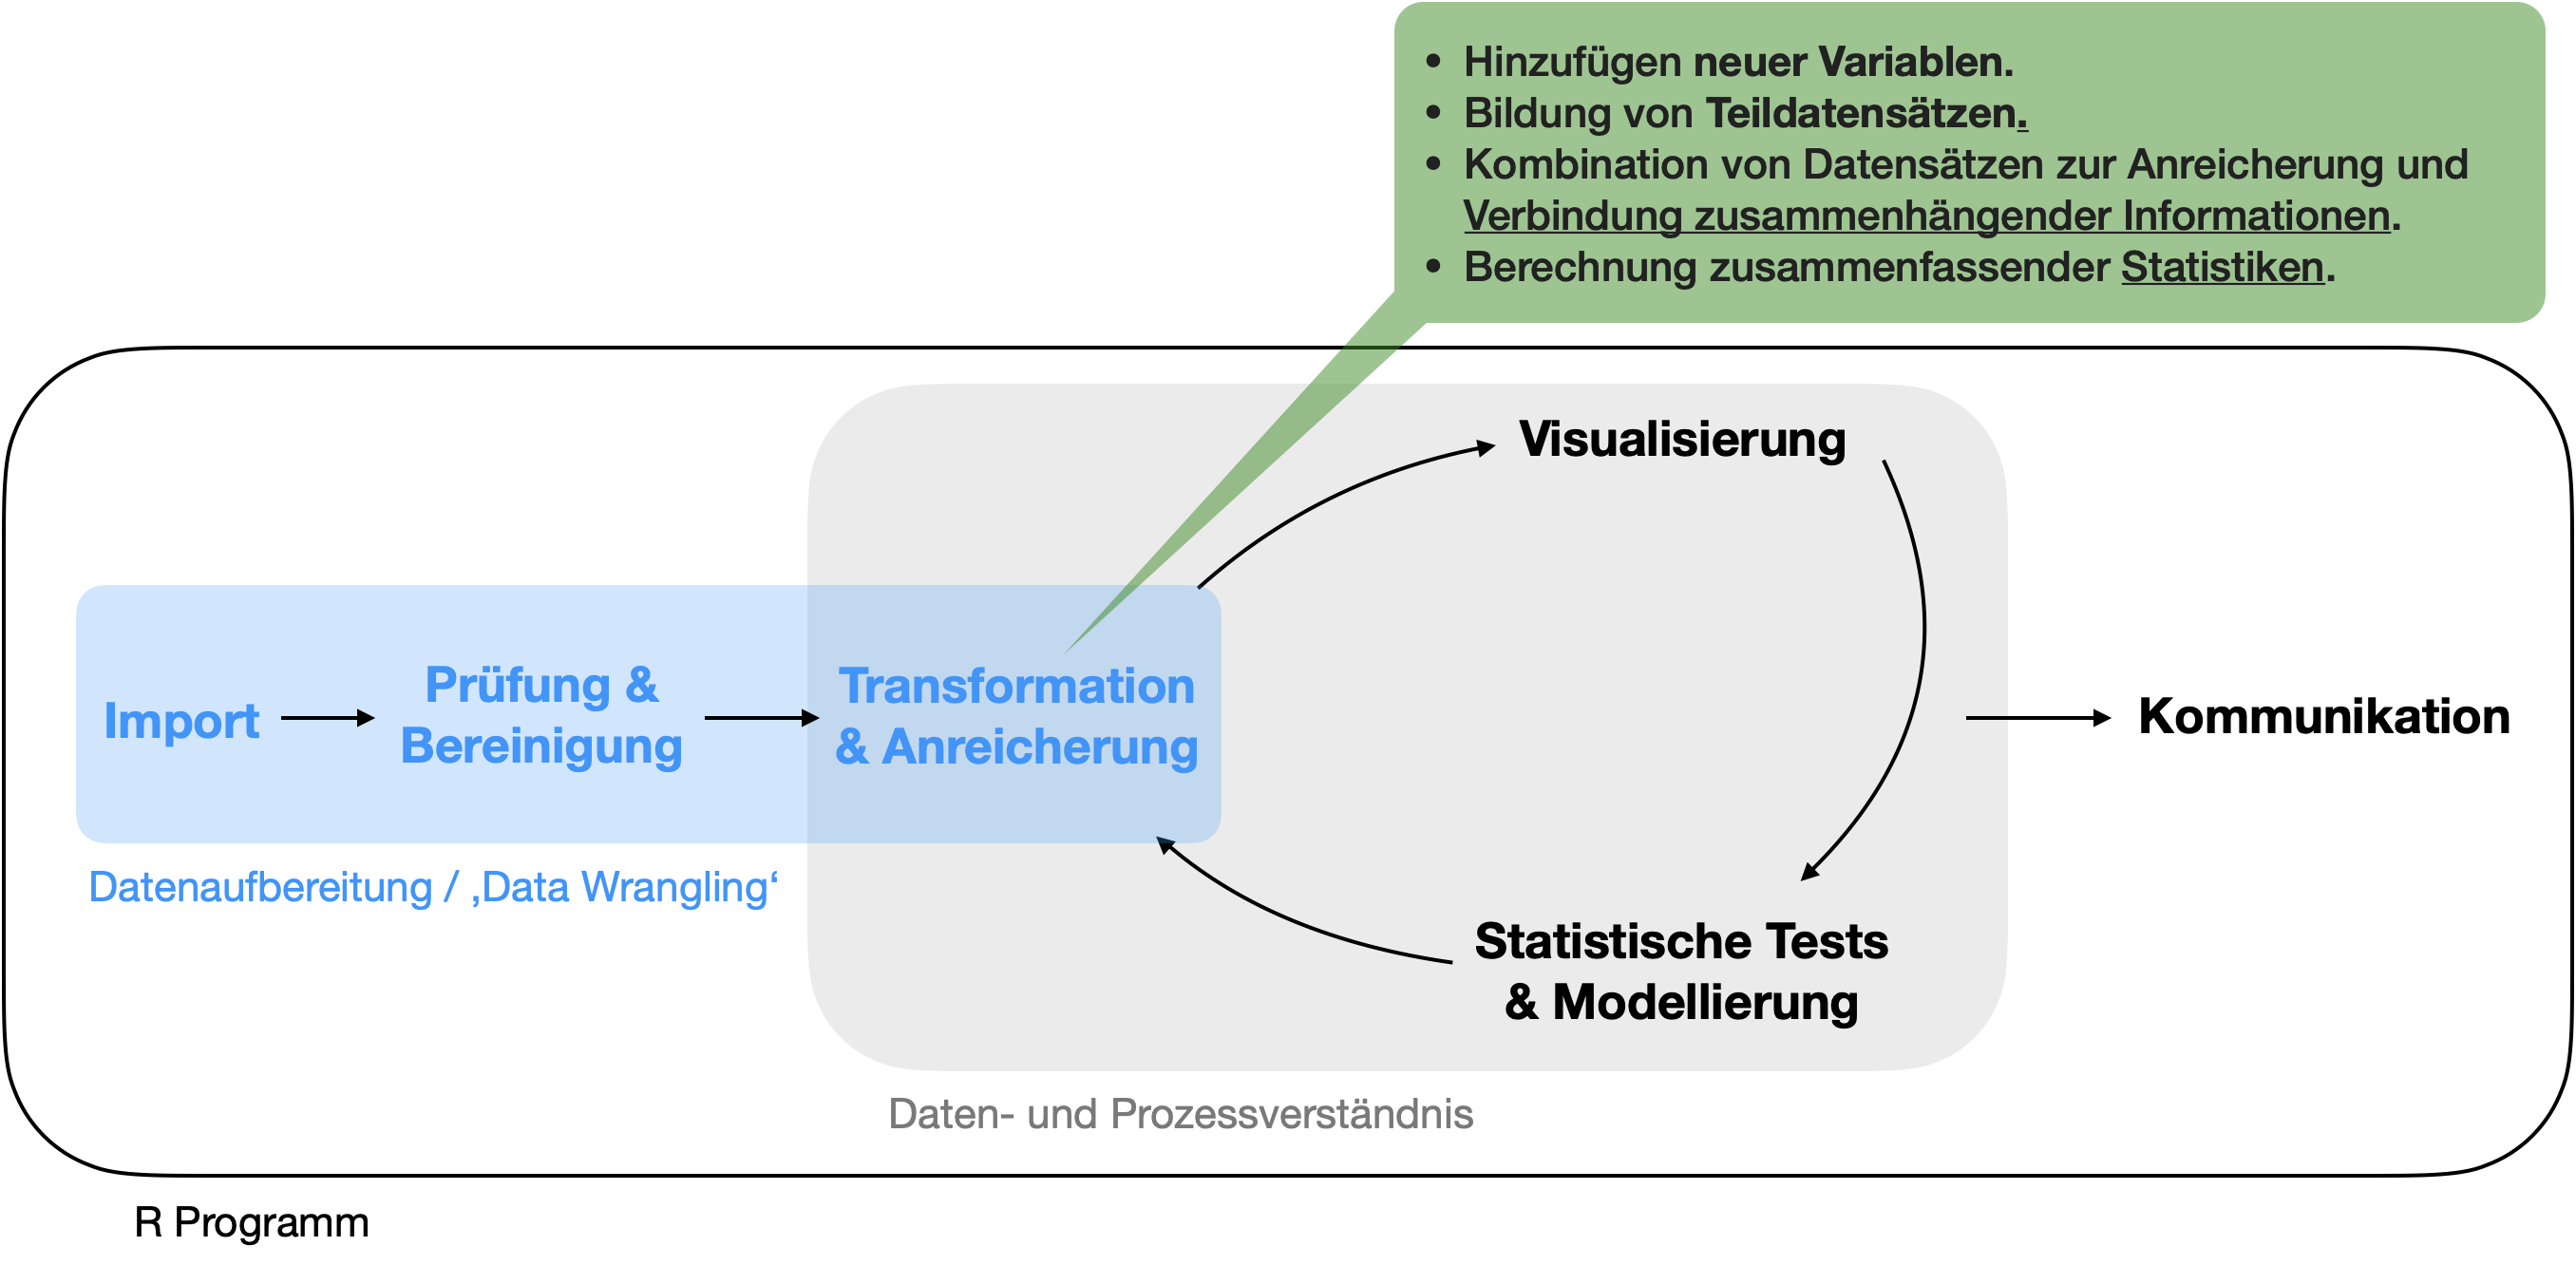
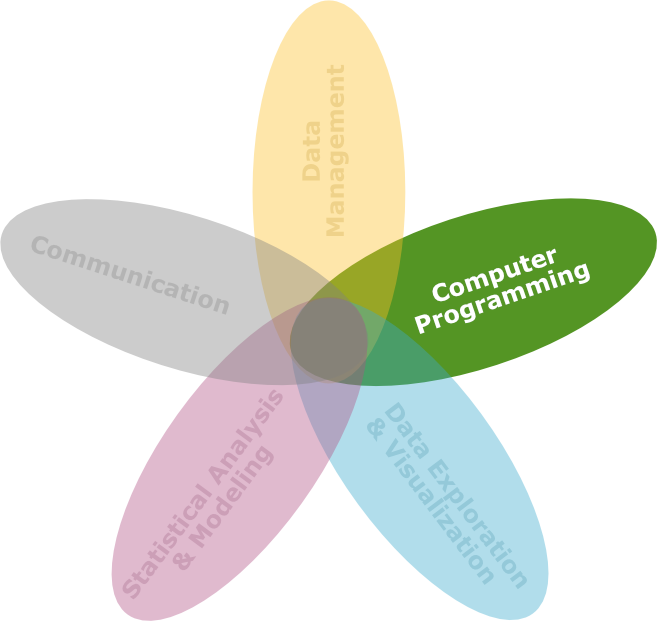
Die 3 Komponenten des ‘Data Wrangling’

Kernfunktionen von dplyr

Typische Manipulationen Kernfunktion in ‘dplyr’
Manipuliere Beobachtungen (Zeilen) filter(), arrange(), distinct()
Manipuliere Variablen (Spalten) select(), rename(), mutate()
Fasse Beobachtungen zusammen summarise(), count()
Gruppiere Beobachtungen group_by(), ungroup()
Kombiniere Tabellen bind_rows(), bind_cols() und XXX_join() Funktionen

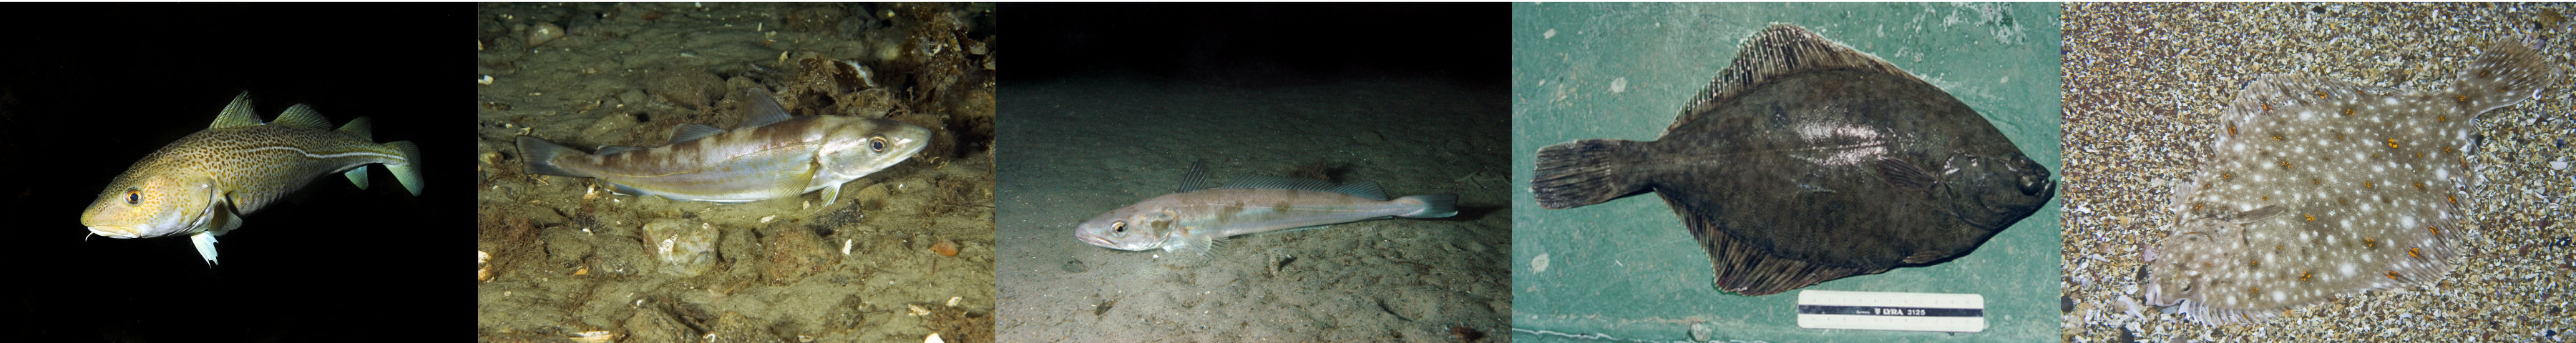
Eine Demonstration mit Wachstumsinformation von 5 Fischarten

Wachstumsparameter als Tibble
fish_growth <- tibble(
  Species = c("Gadus morhua", "Platichthys flesus", "Pleuronectes platessa",
    "Merlangius merlangus", "Merluccius merluccius"),
  Linf = c(110, 40.8, 54.4, 41.3, 81.7),
  K = c(0.4, 0.4, 0.1, 0.2, 0.1)
)
(‘Linf’ = mittlere maximale Länge, ‘K’ = Rate, mit der sich der Fisch an ‘Linf’ annähert)

Mit freundlicher Genehmigung der Fotografen von fishbase.org (Konstantinos I. Stergiou, Jim Greenfield) und uwphoto.no (Rudolf Svensen).

Transformation: Zeilen- und Spaltenmanipulation

Zeilenmanipulation | Sortieren

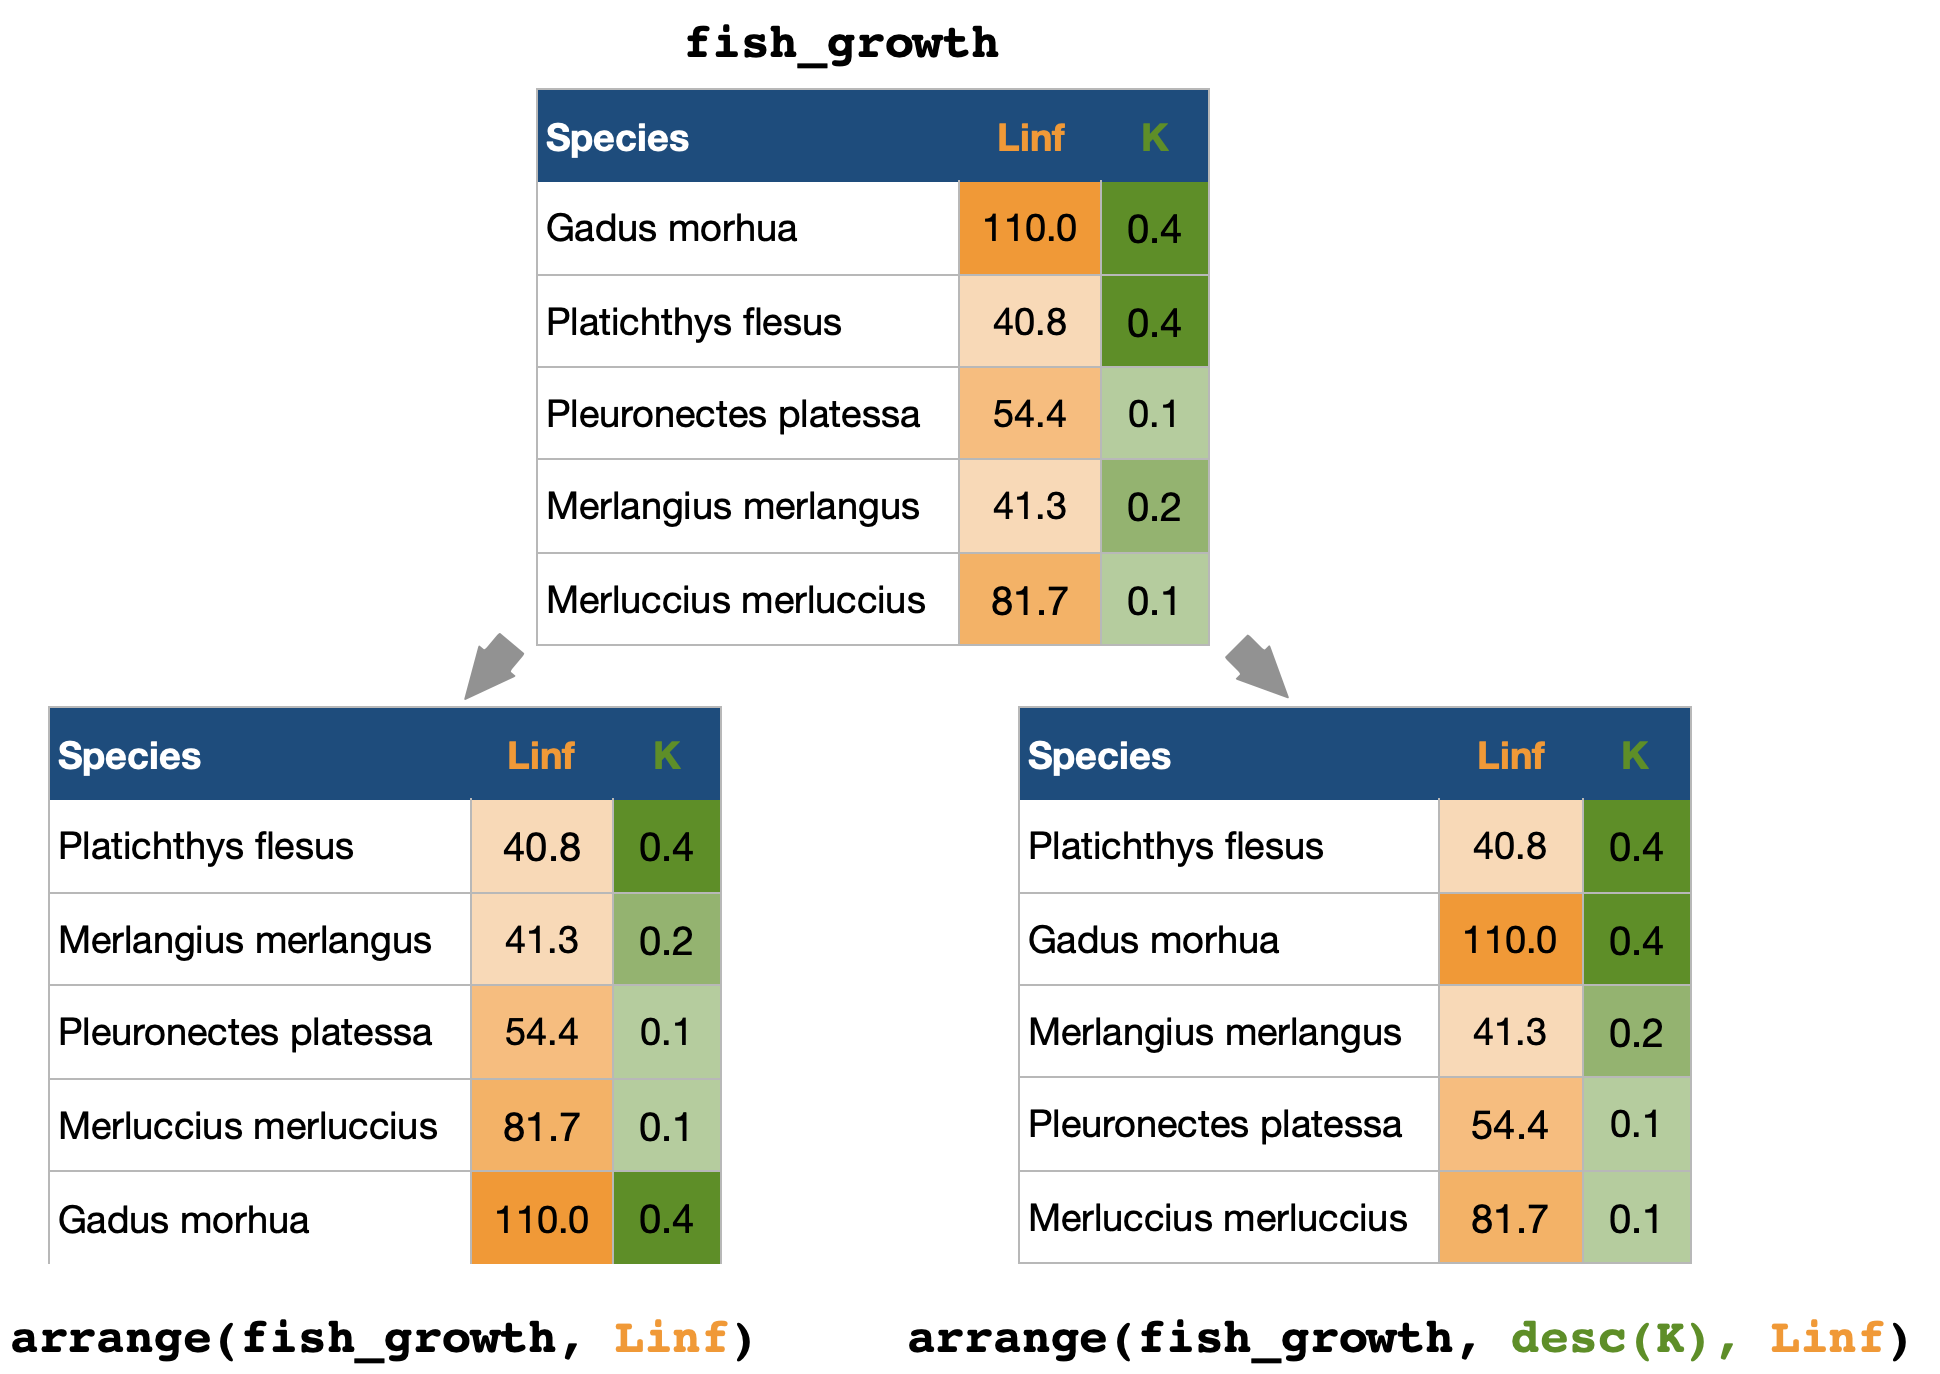
arrange() → sortiert Zeilen (also Beobachtungen) nach spezifischen Variablen:

Zeilenmanipulation | Filtern

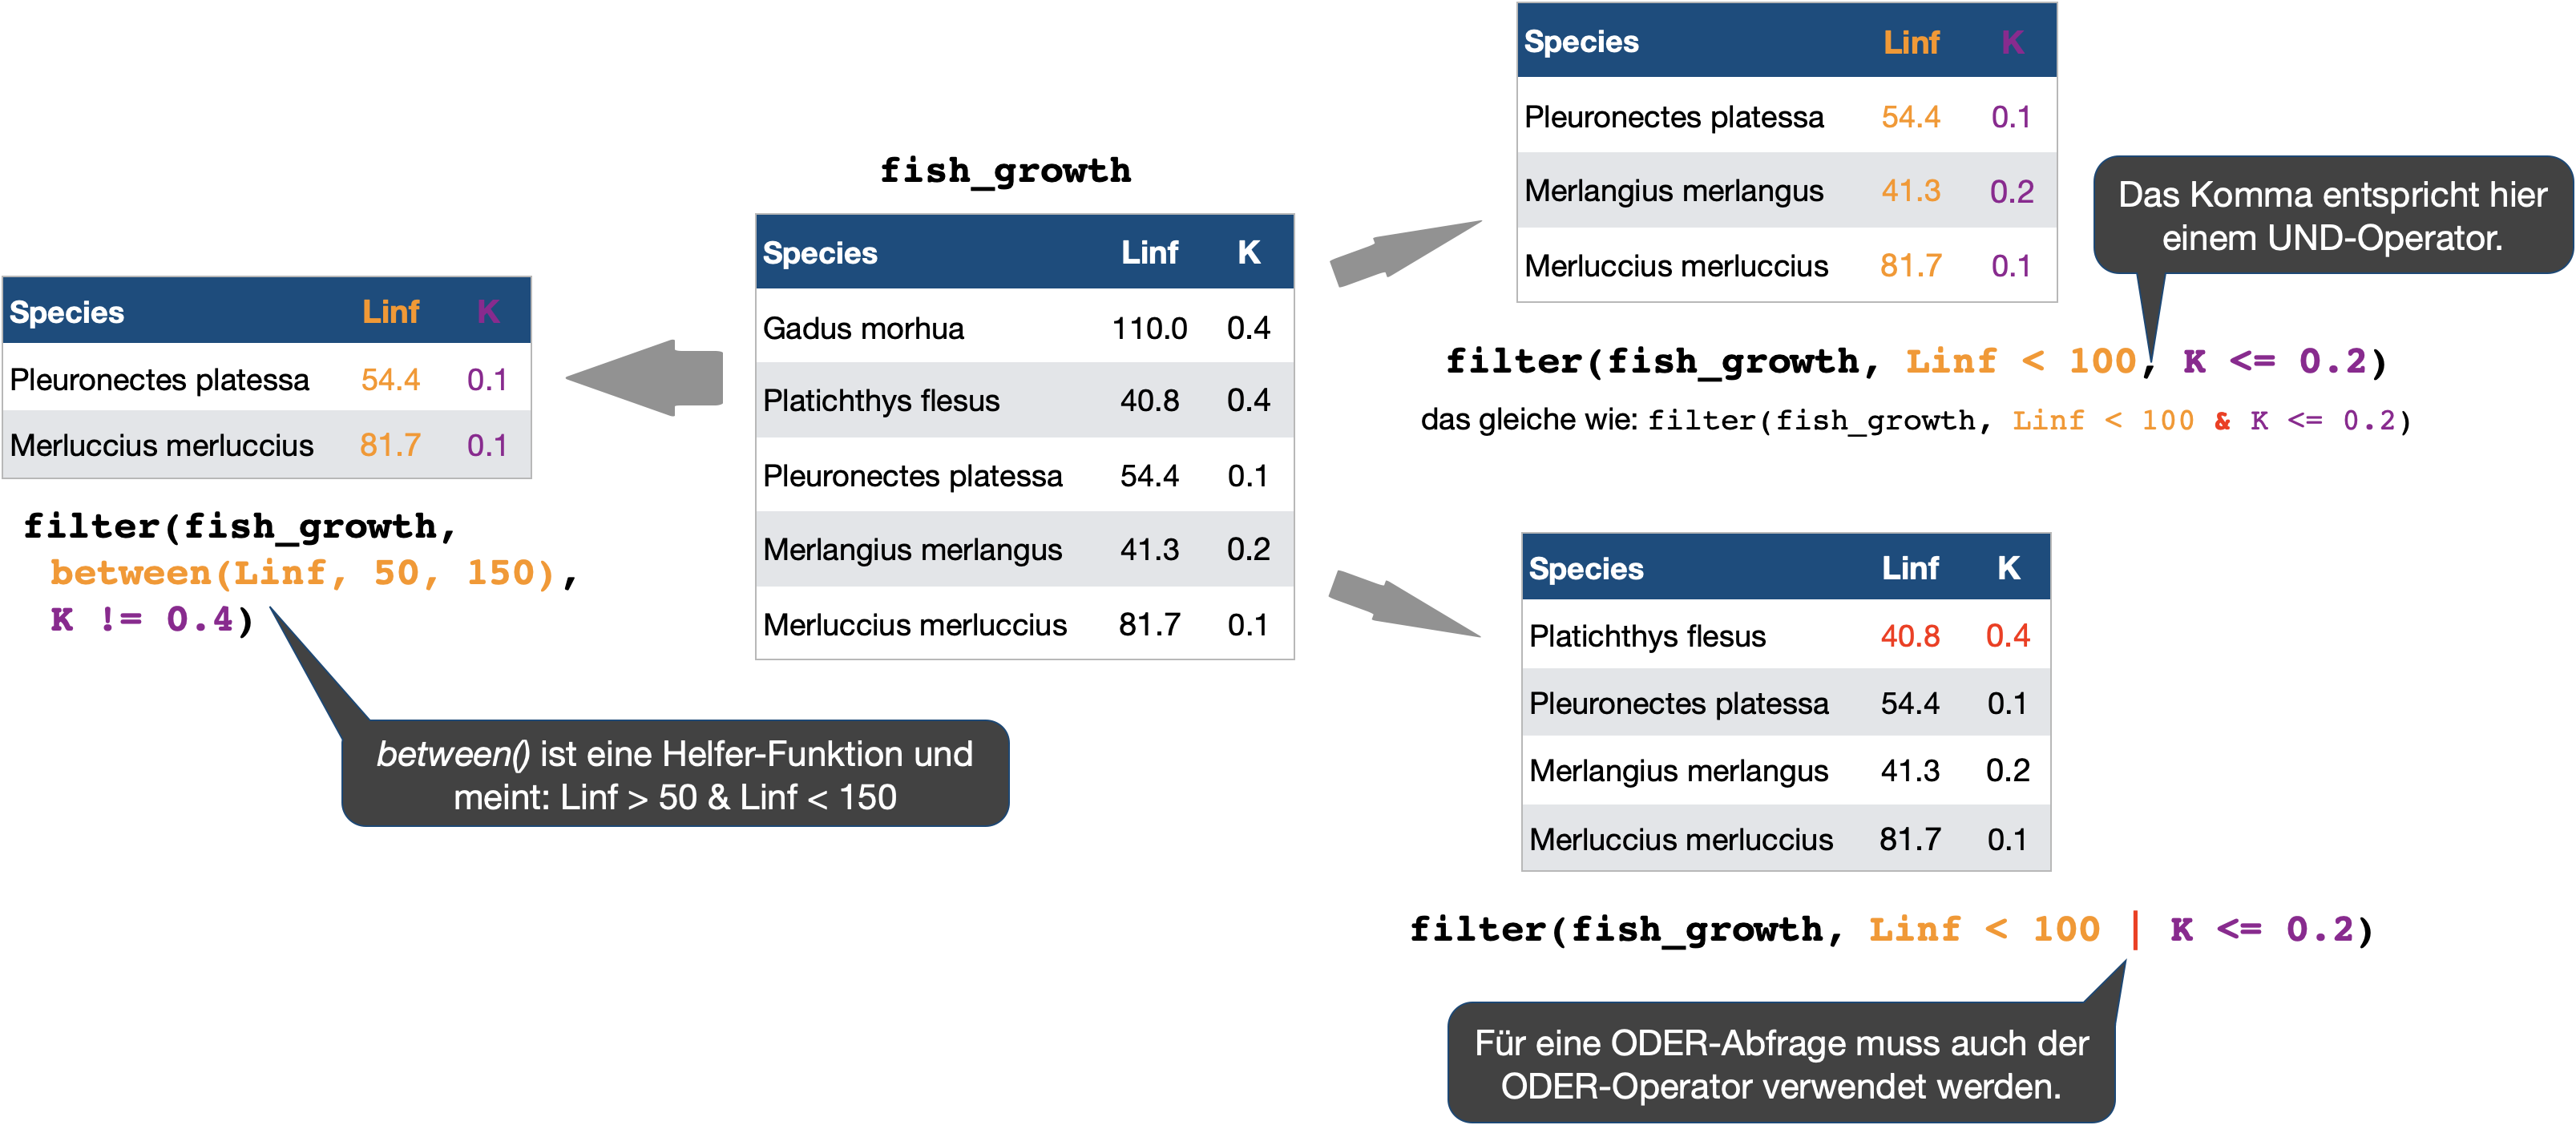
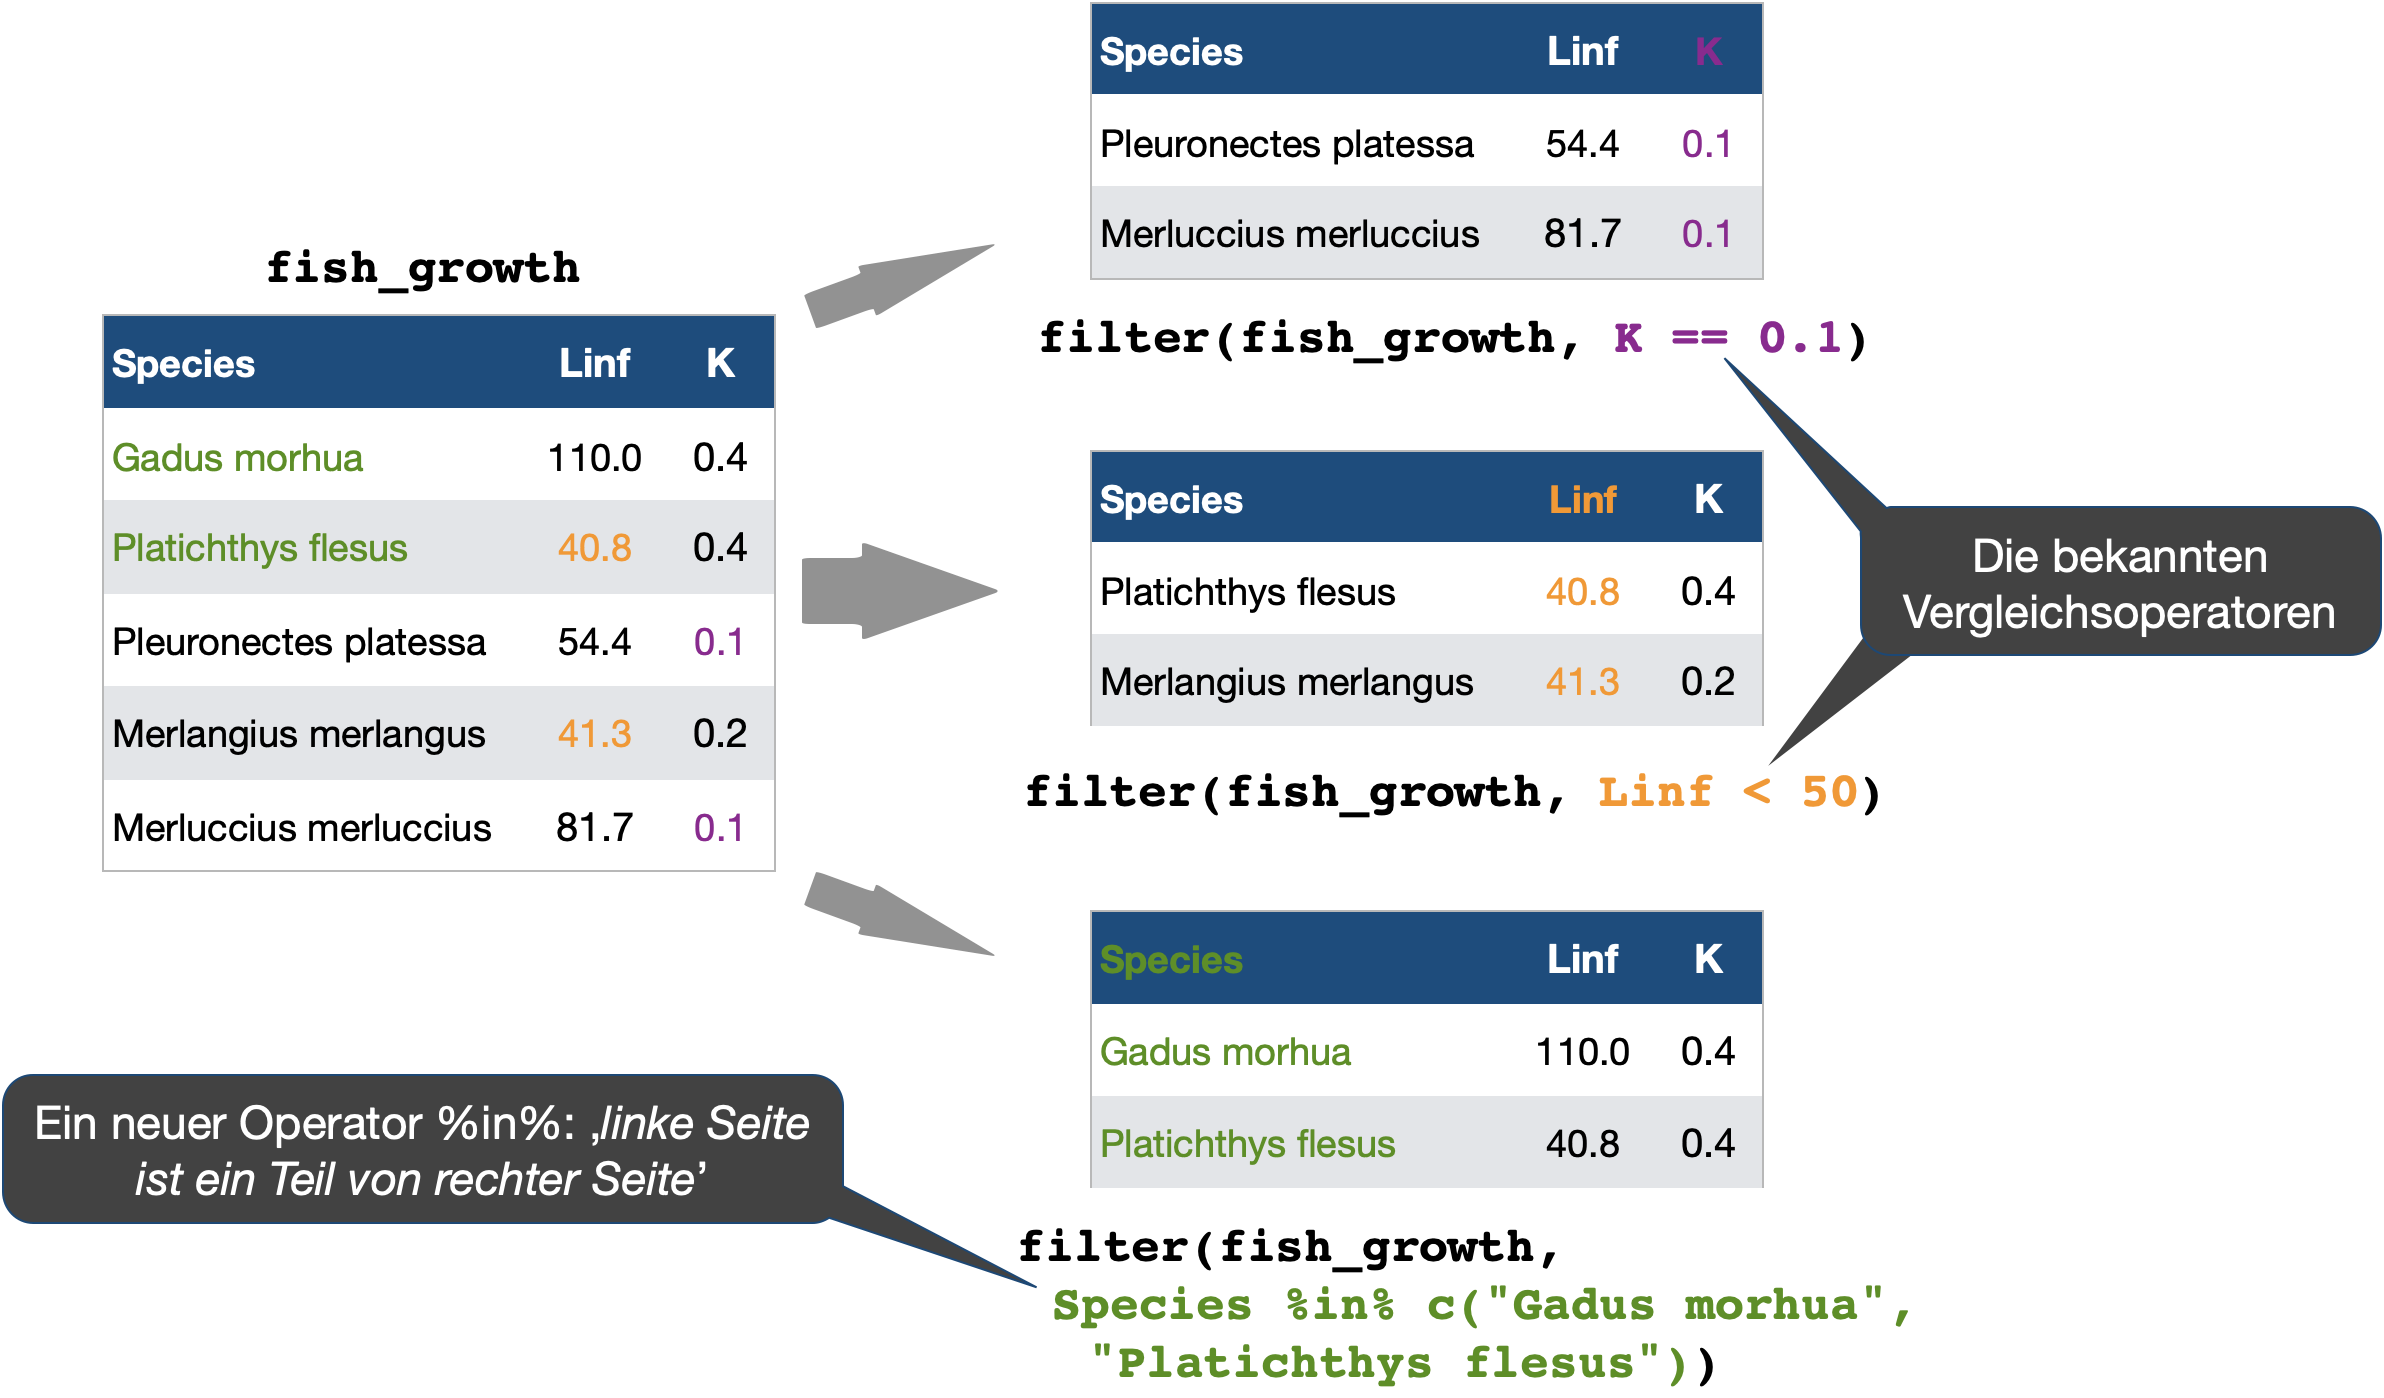
filter() → extrahiert Zeilen, die ein logisches Kriterium erfüllen:

Zeilenmanipulation | Verknüpftes Filtern

Verknüpfte Abfragen in filter() werden mit Kommata aufgeführt (UND-Operator):

Spaltenmanipulation | Variablenauswahl

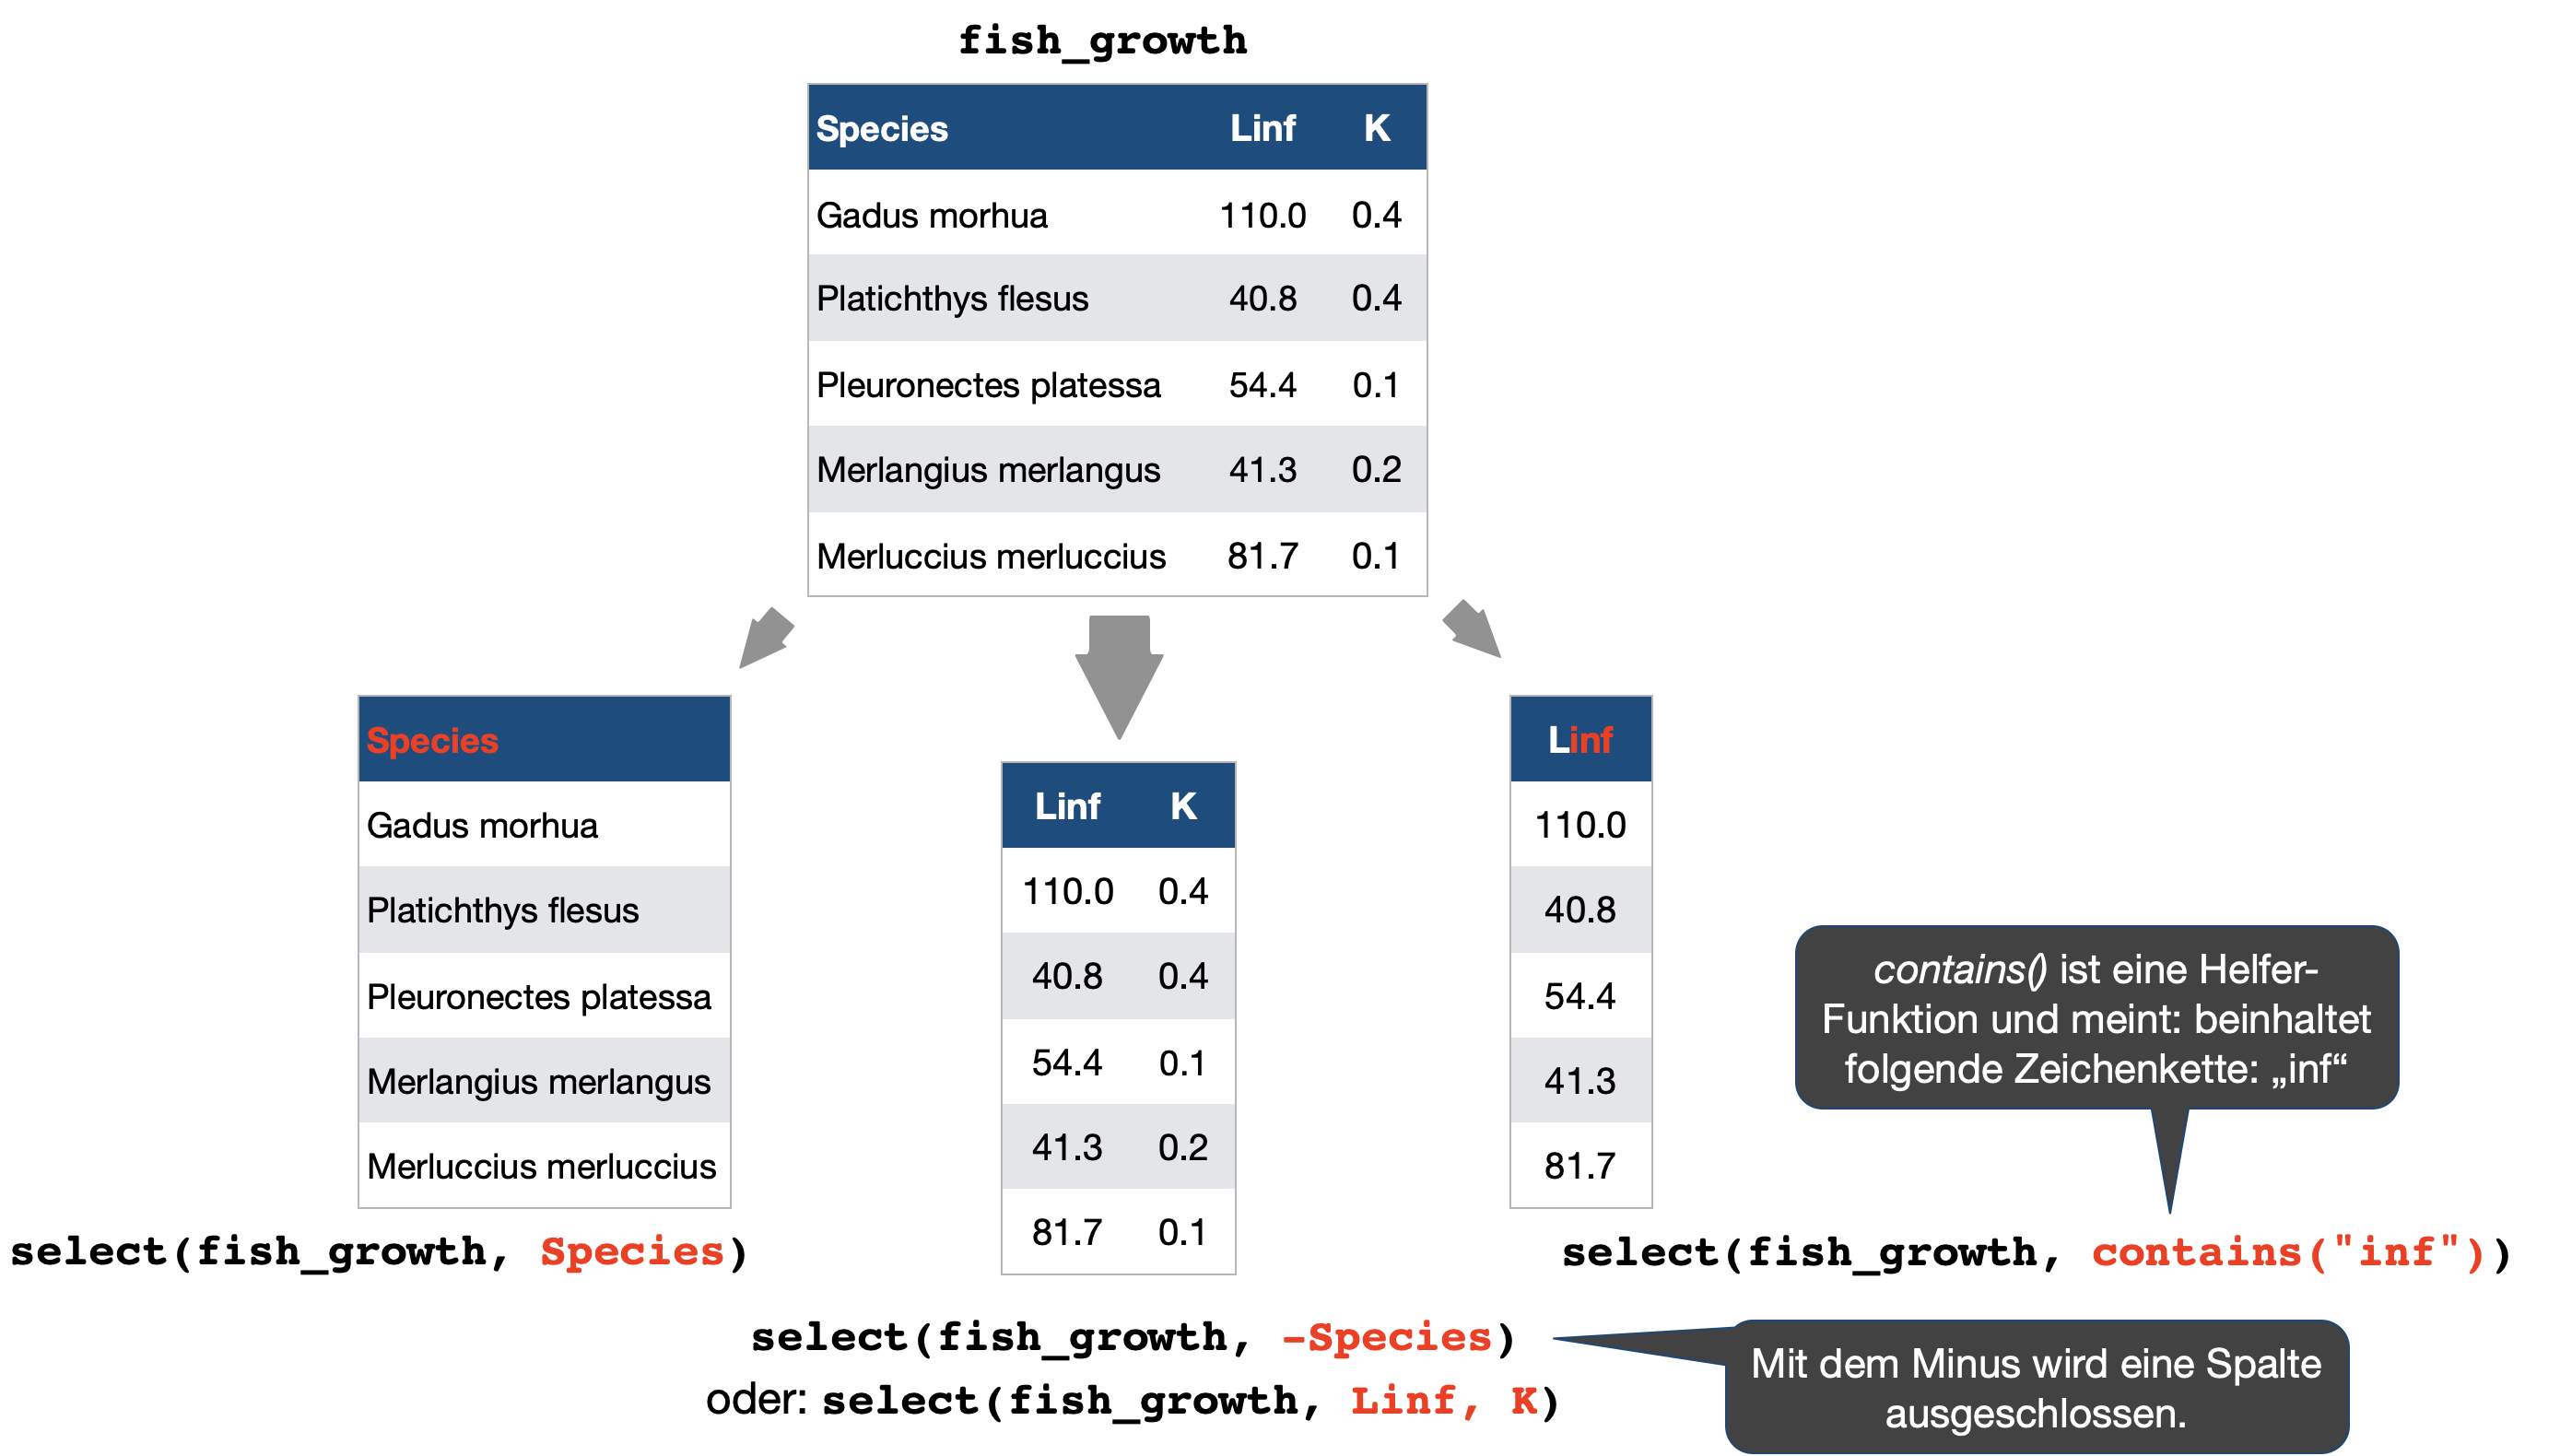
select() → extrahiert Spalten nach Namen oder mittels Helferfunktion:

Spaltenmanipulation | Helferfunktion 1

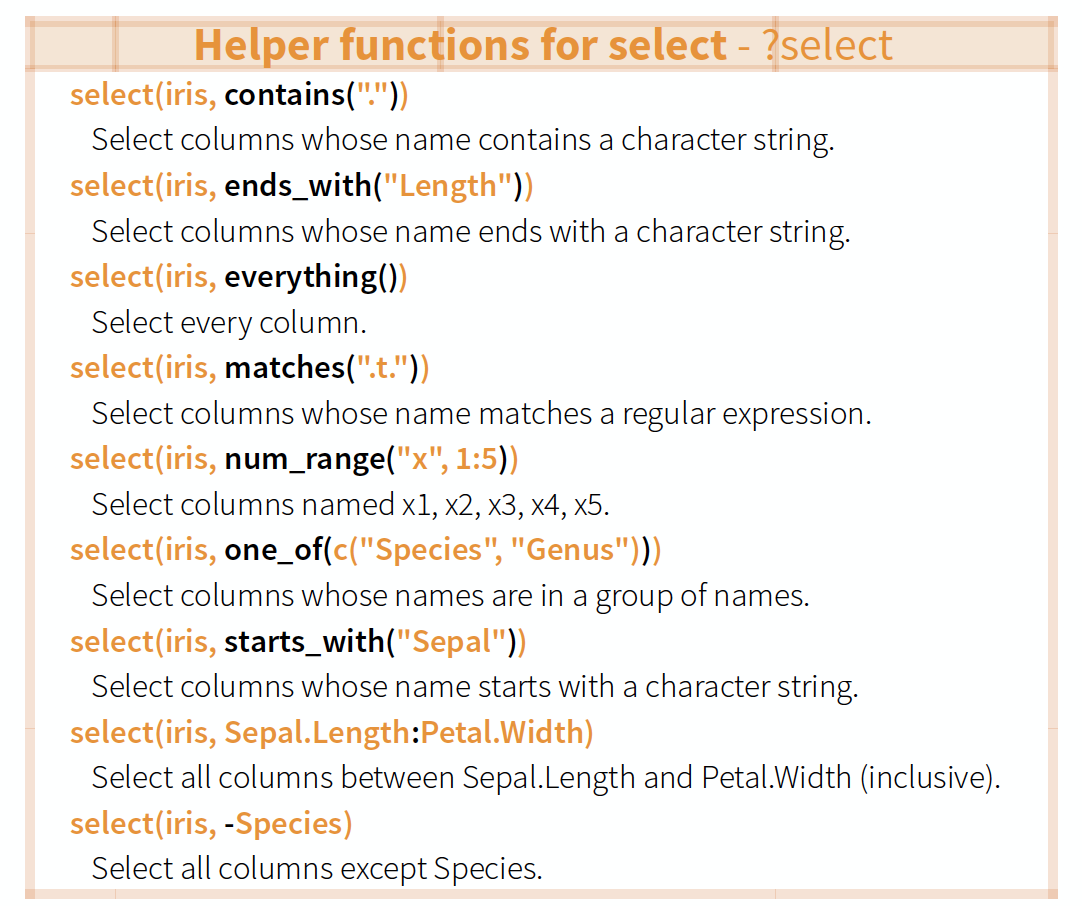
Übersicht der Helferfunktionen für select()

Quelle: ältere Version des sog. cheatsheets
Data Transformation with dplyr (lizenziert unter CC-BY-SA).

Spaltenmanipulation | Namensänderung

rename() → ändert die Namen einzelner Variablen (neuerName = alterName):

Spalte 'Species' umbenennen
fish_growth2 <- rename(fish_growth, FishSpecies = Species)
fish_growth2
# A tibble: 5 × 3
  FishSpecies            Linf     K
  <chr>                 <dbl> <dbl>
1 Gadus morhua          110     0.4
2 Platichthys flesus     40.8   0.4
3 Pleuronectes platessa  54.4   0.1
4 Merlangius merlangus   41.3   0.2
5 Merluccius merluccius  81.7   0.1

Spaltenmanip. | Variablenerstellung

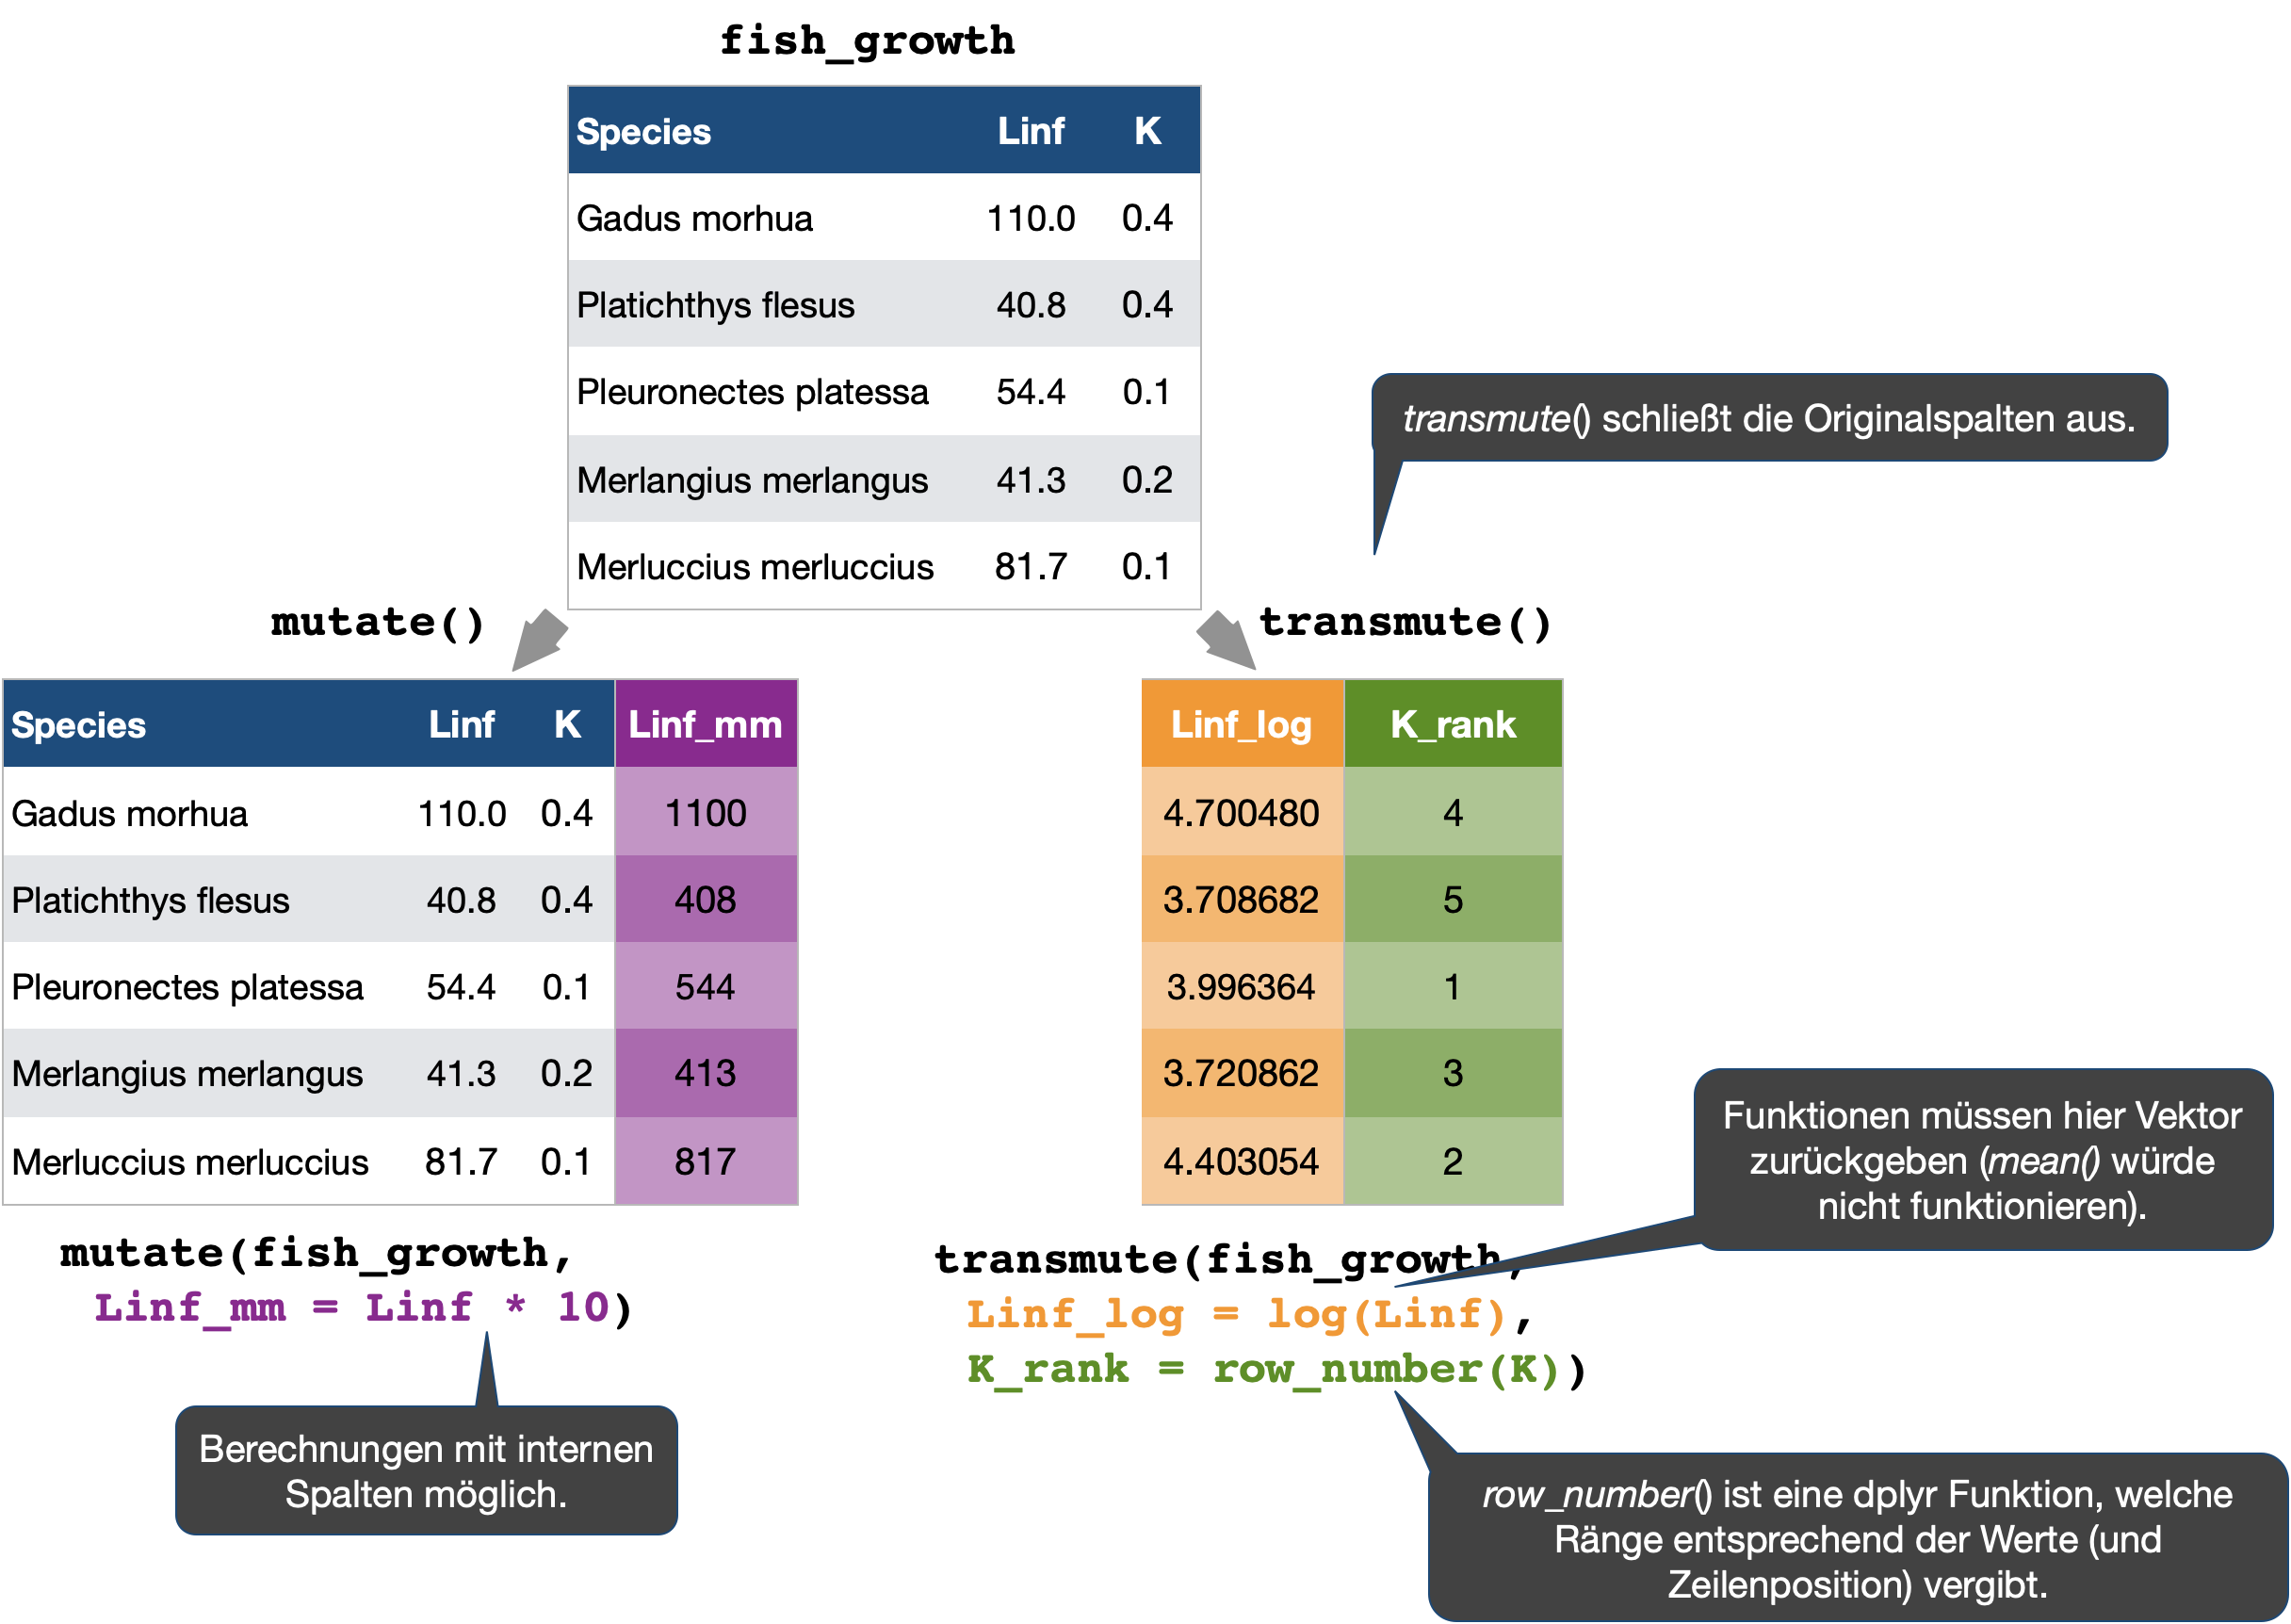
mutate() und transmute() → erstellen neue Variablen:

→ Neu seit dplyr 1.1: transmute() gilt als veraltet (‘superseded’). Stattdessen wird mutate(..., .keep = "none") empfohlen – das Ergebnis ist dasselbe.

Spaltenmanipulation | Helferfunktion 2

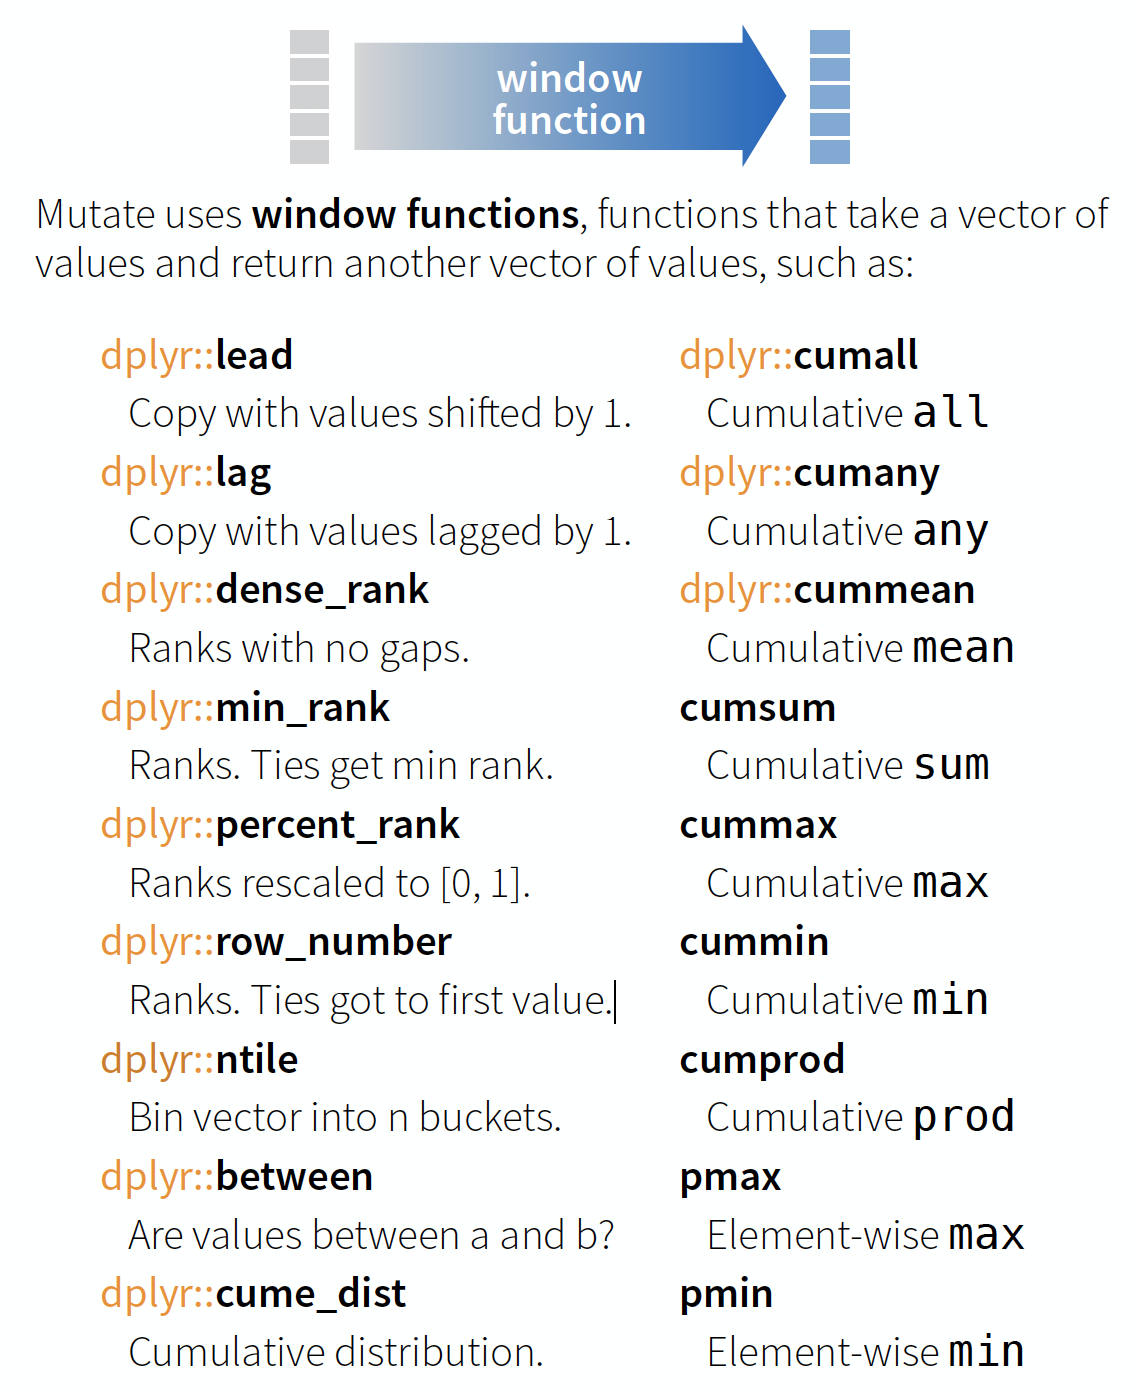
Übersicht der Helferfunktionen für mutate()

Sie können jede Berechnung mit einer Variablen machen, solange diese vektorisiert ist:

Quelle: ältere Version des sog. cheatsheets Data Transformation with dplyr (lizenziert unter CC-BY-SA).

Kombinieren von Befehlen

Hilfreiches Tool

Bevor wir jetzt in die Datenmanipulation starten, werden wir ein sehr hilfreiches Werkzeug für verknüpfte Operationen kennenlernen!!!

Der ‘pipe’ Operator

2 Varianten des ‘pipe’ Operators

Das Original: %>%

  • Wurde zunächst durch das Paket ‘magrittr’ zur Verfügung gestellt.
  • Ist nun aber auch über die ‘tidyverse’ Pakete (z.B. dplyr) zugänglich.
  • → D.h., es muss erst eines dieser Pakete geladen werden, um den Operator nutzen zu können.

Neuer nativer Pipe Operator: |>

  • Ab der R Version 4.1 gibt es diesen nützlichen Operator auch direkt in base R.
  • → D.h., es muss KEIN Paket extra geladen werden.
  • In diesem Modul (auch in den swirl-Kursen) werden wir NUR mit dem nativen Operator |> arbeiten!

Wozu ein solcher Operator?

Vereinfacht Operationen:

  • Mit |> können diverse Funktionsaufrufe sequenziell miteinander verknüpft werden, ohne Zwischenobjekte zu erstellen.
  • |> leitet den Inhalt des Objekts auf der linken Seite in den Ausdruck auf der rechten Seite weiter.
  • Weitere Schritte können einfach und überall der Sequenz an Operationen hinzugefügt, entfernt oder auskommentiert werden.

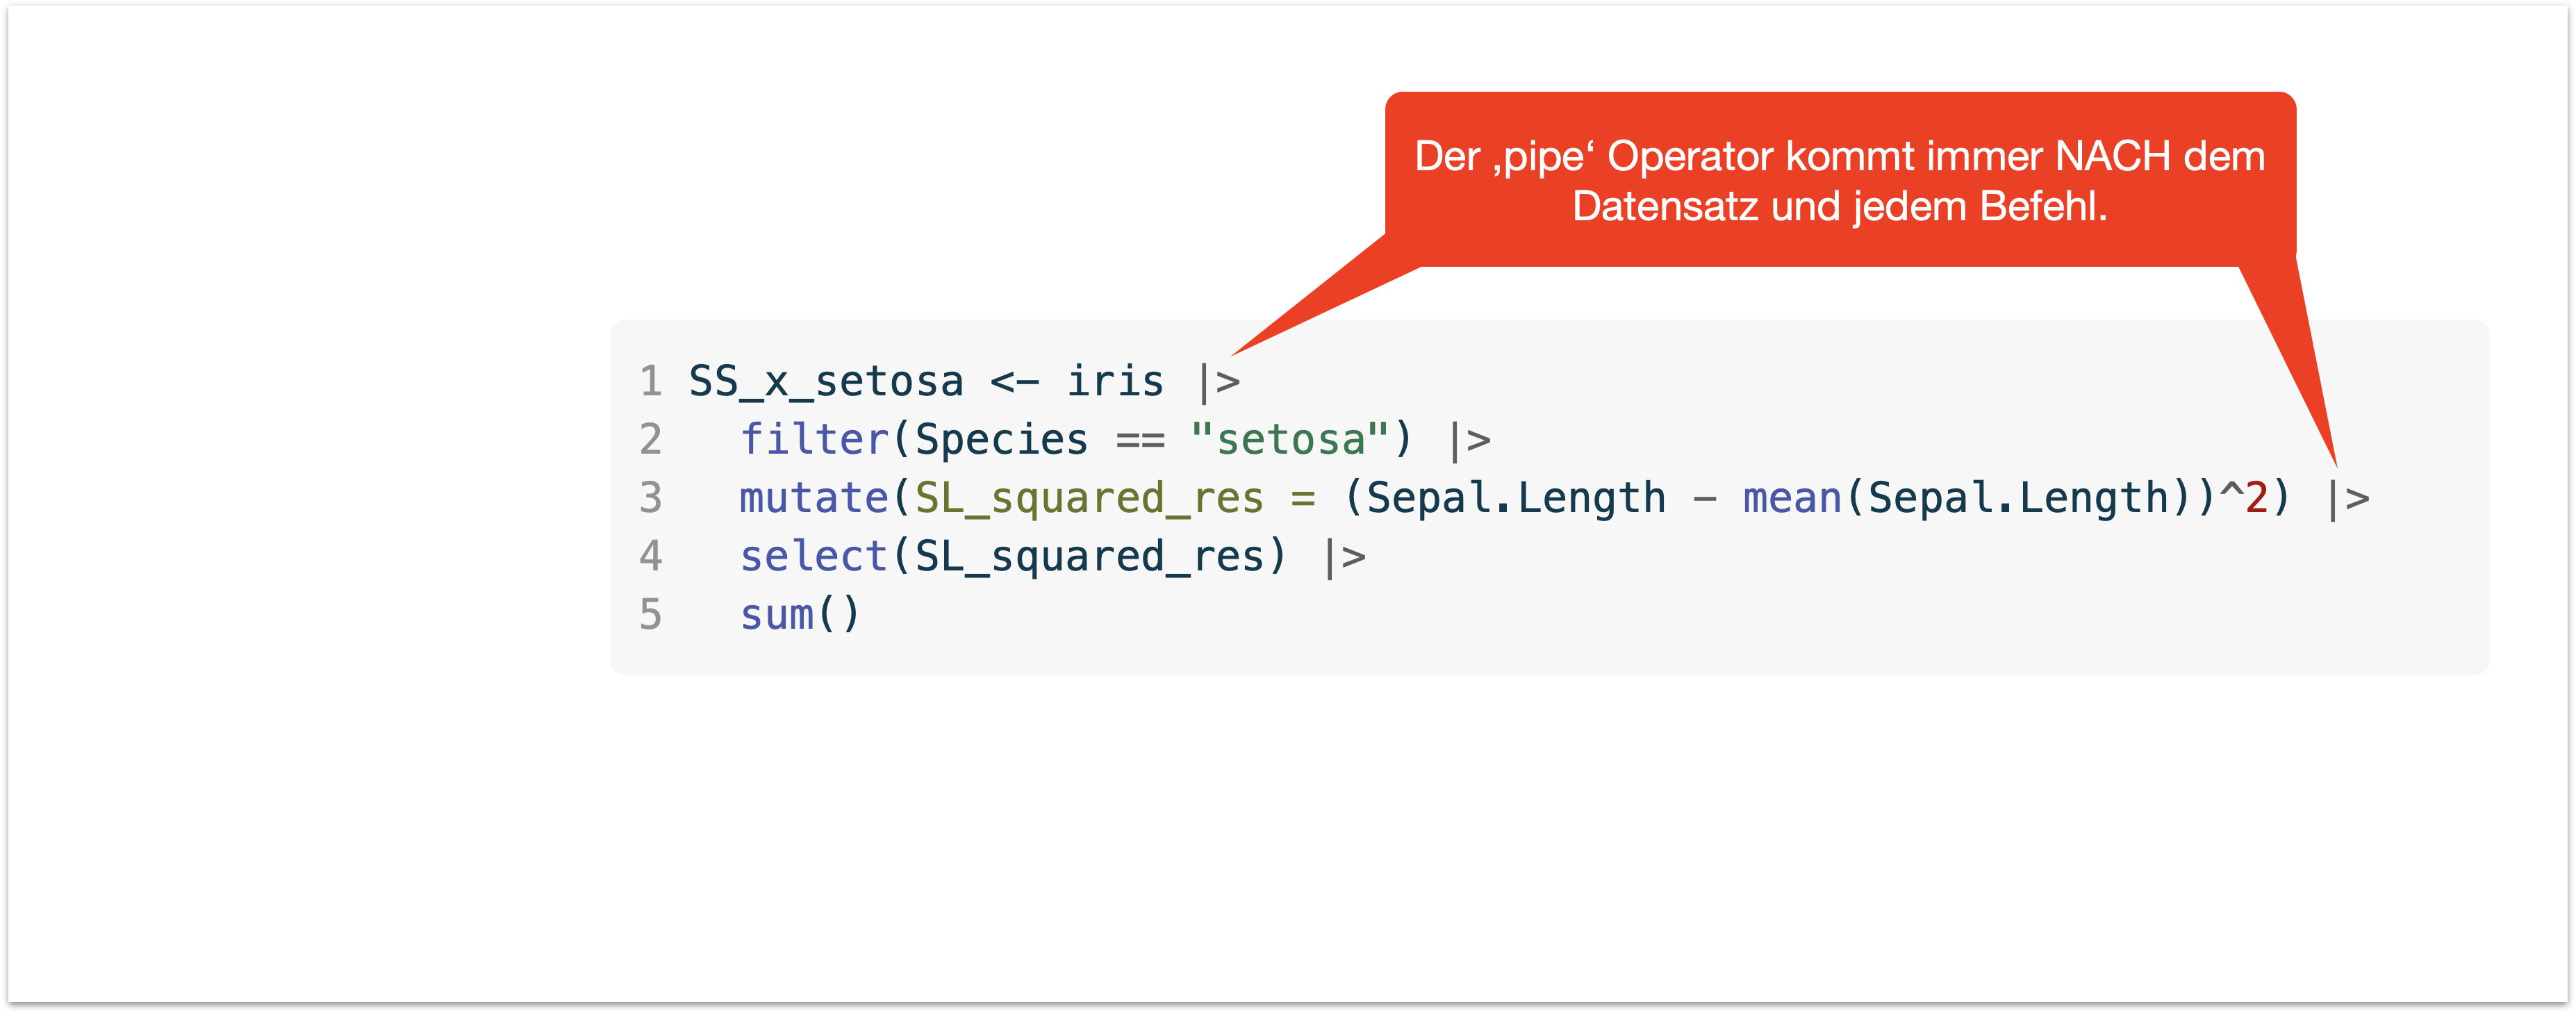
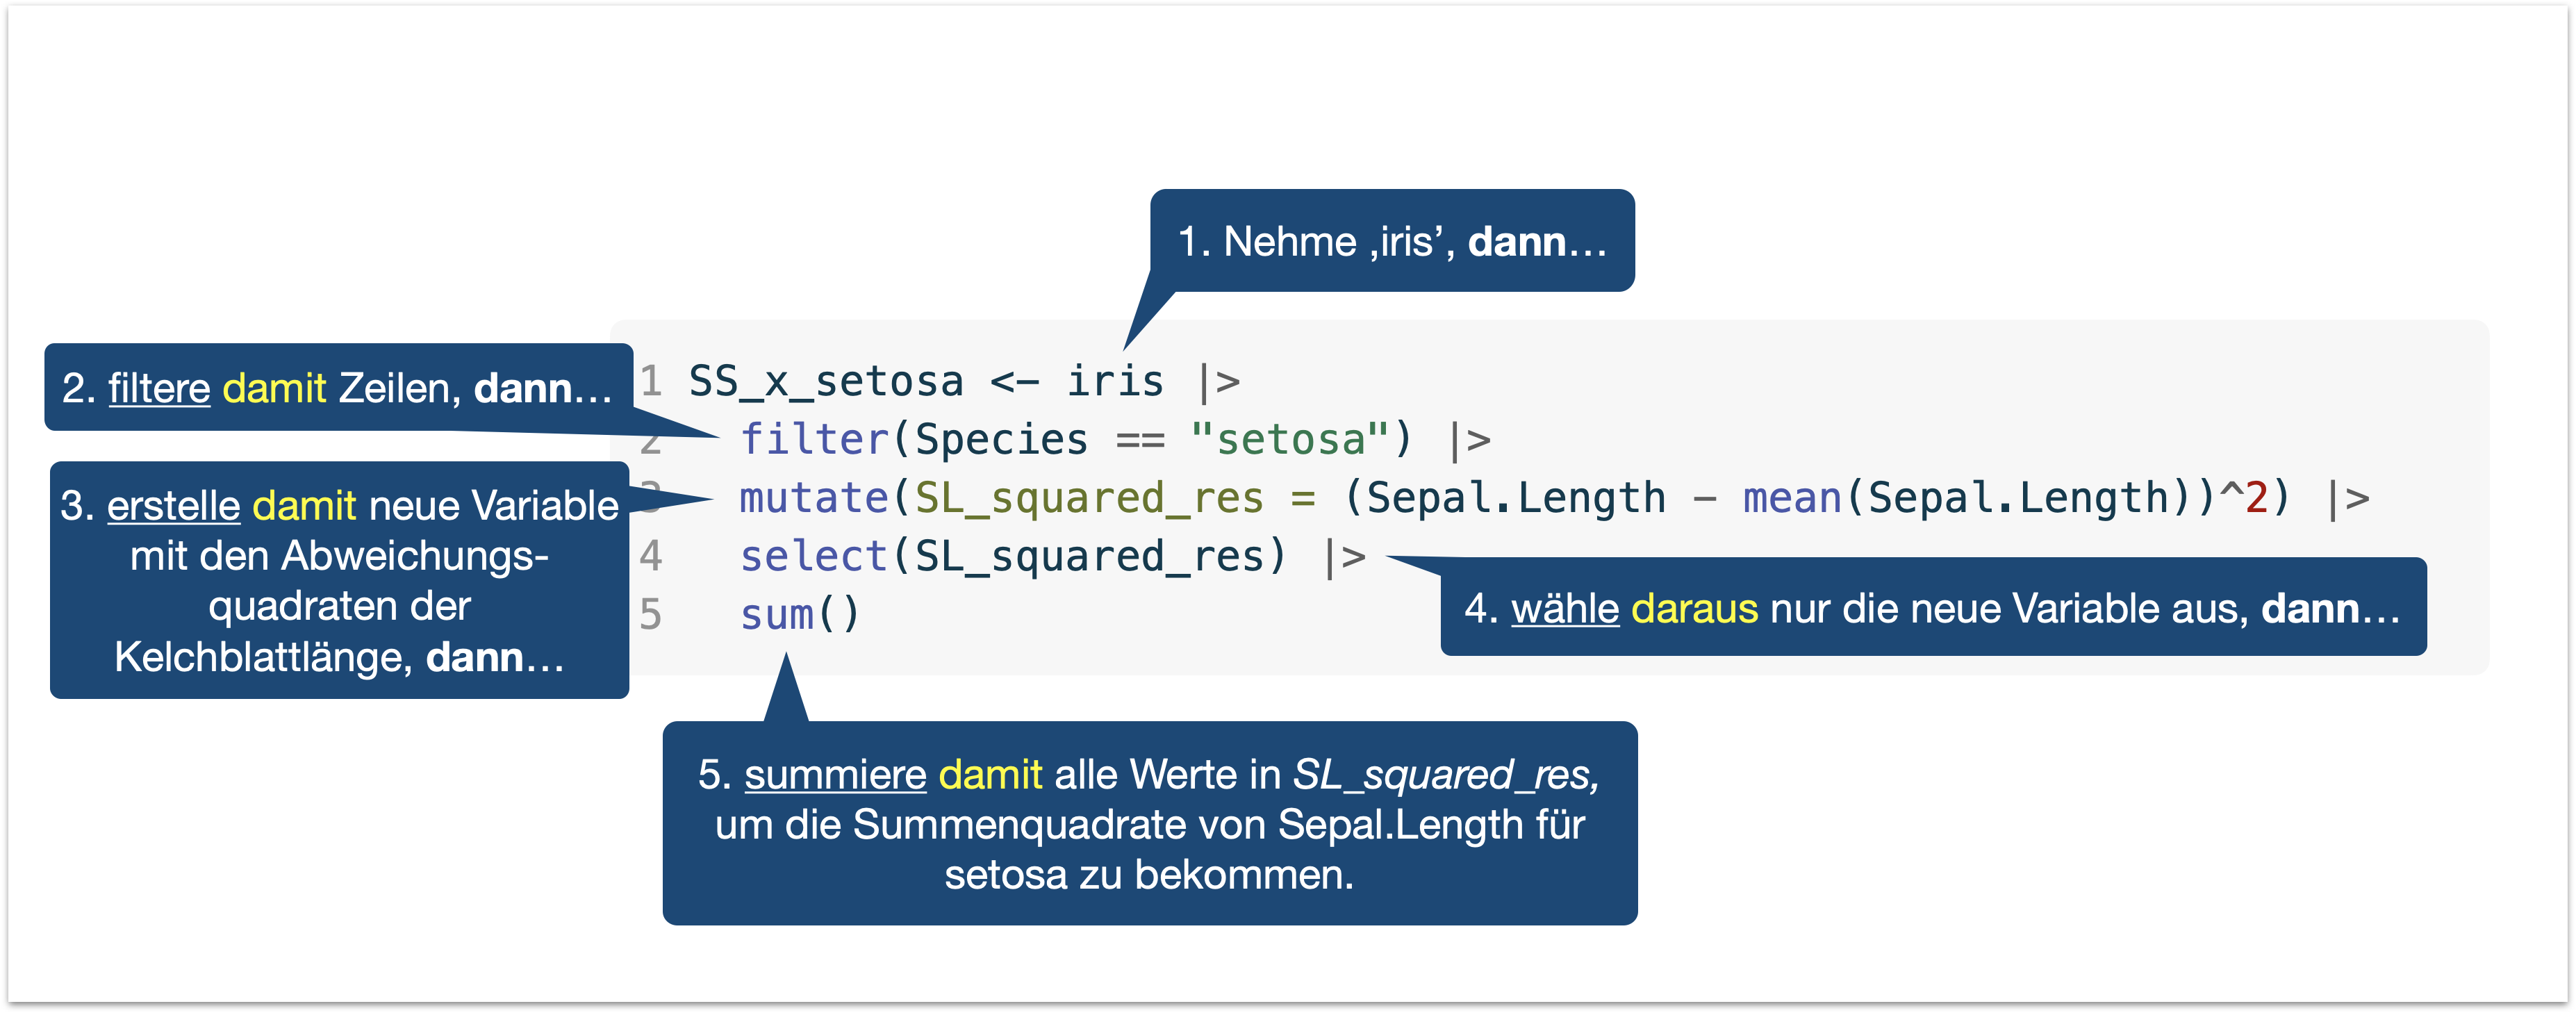
‘Piping’ mit |> | Wie?

‘Piping’ mit |> | Interpretation

Erinnert doch fast an ein Kochrezept, oder?

Shortcut für |>

Kleiner Tipp:

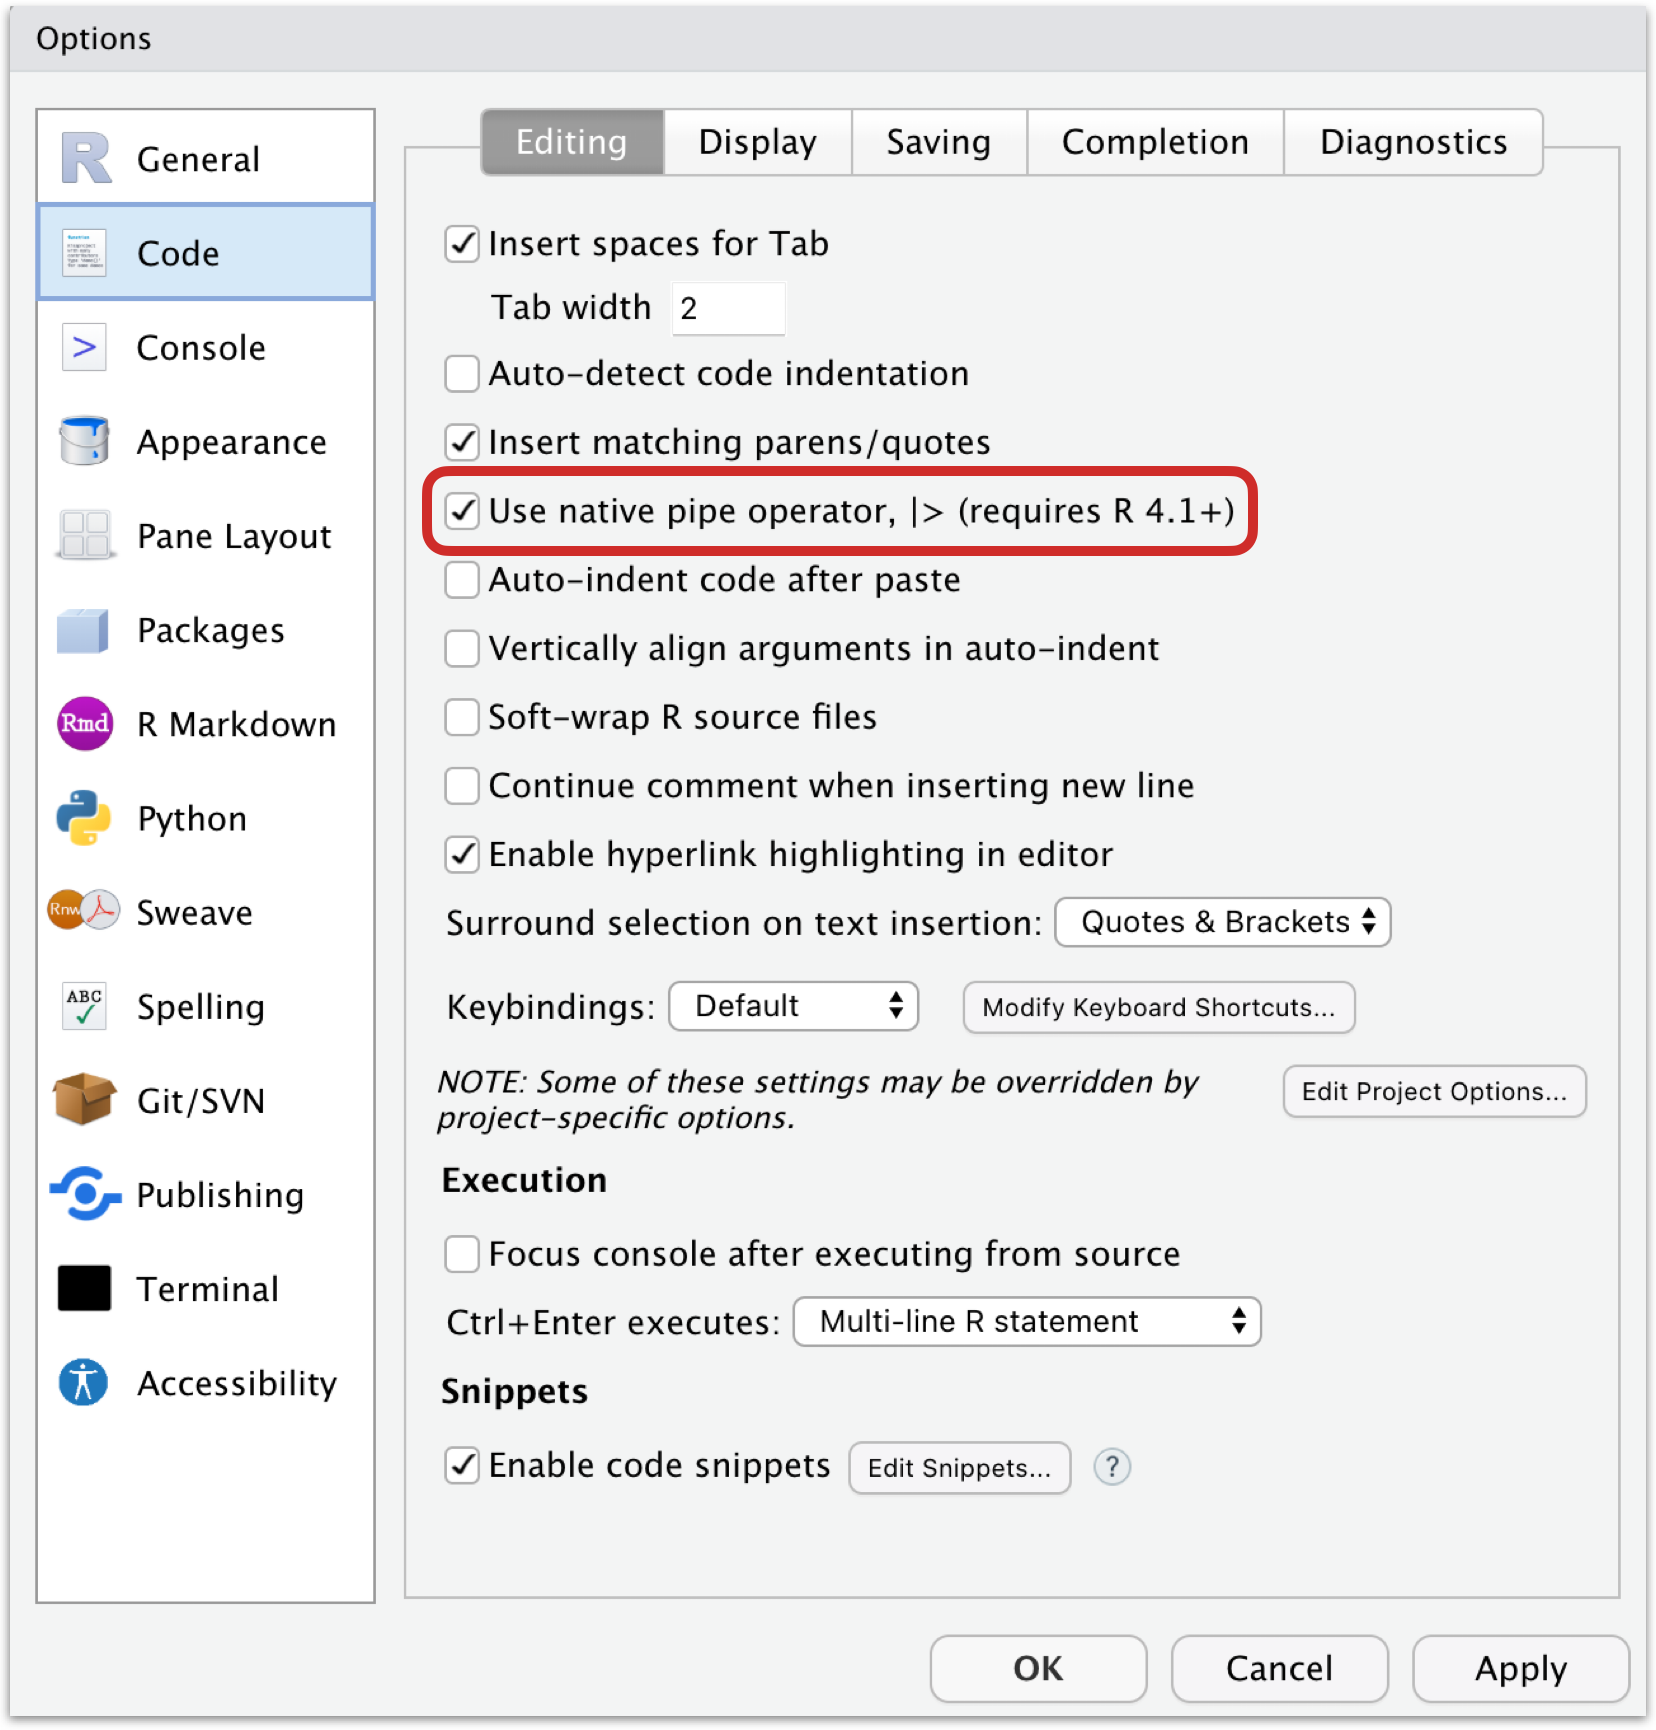
Der Pipe-Operator lässt sich mit dem Shortcut strg (bzw. cmd) + shift + m automatisch schreiben.

Um den nativen Operator standardmäßig zu nutzen, muss vorweg unter

  • ‘Preferences > Code’ bzw.
  • ‘Tools > Global Options..’ > Code
  • bei ‘Use native pipe operator, |> (requires R 4.1+)’

ein Häkchen gesetzt werden!

Your turn …

Quiz 1-3 | Zeilen- und Spaltenmanipulation

Q1

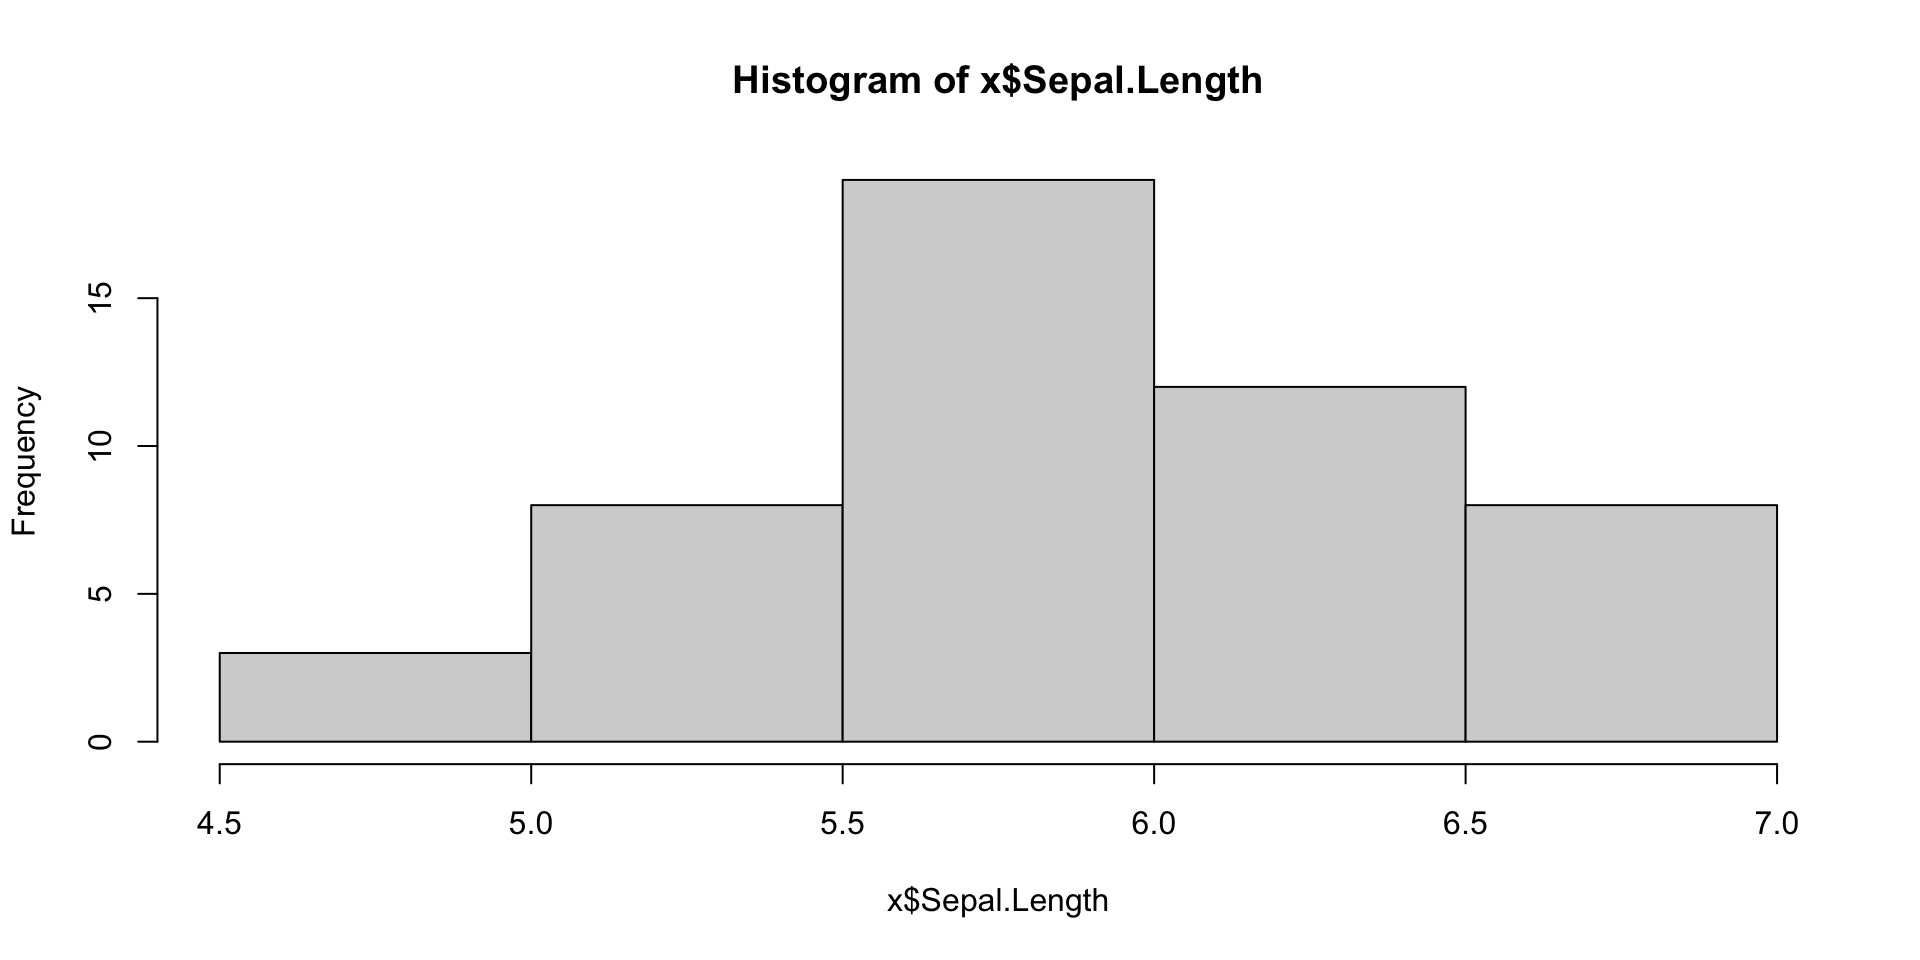
Wir wollen uns die Verteilung der Kelchblattlänge bei der Art Iris versicolor anschauen:

x <- iris |>
  filter(Species == 'versicolor')
hist(x$Sepal.Length)

Q2

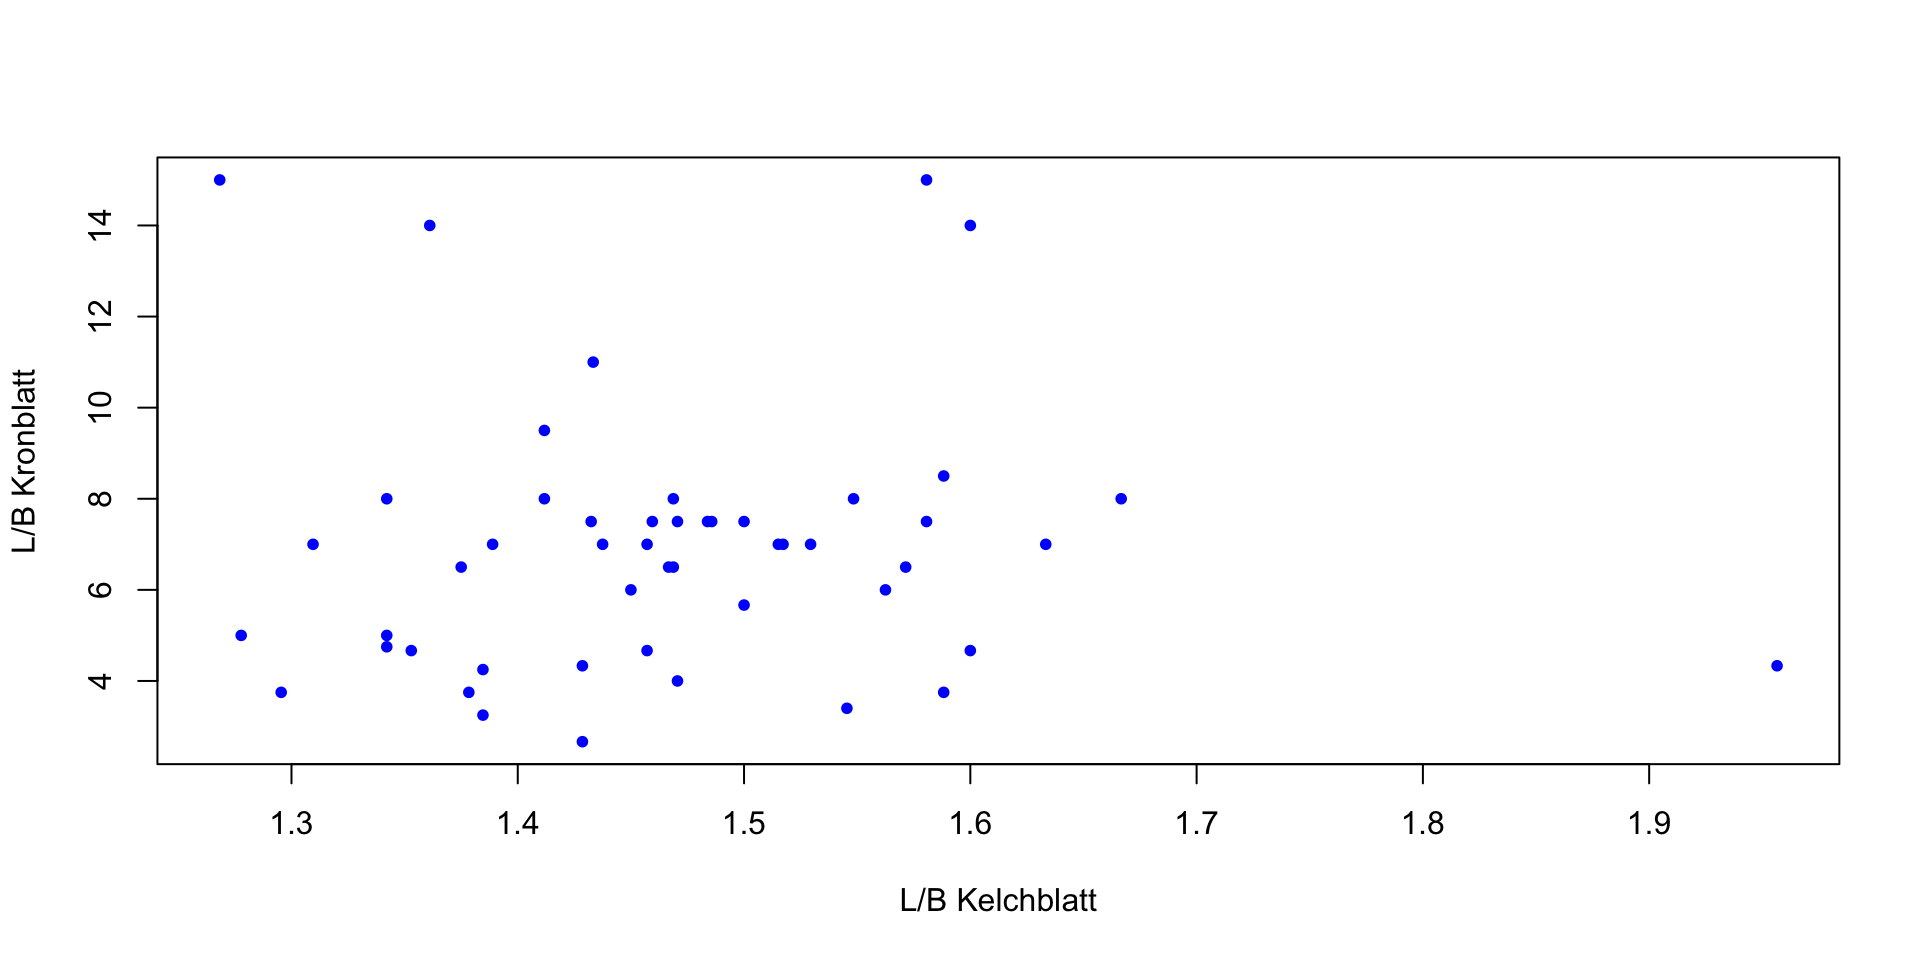
Gibt es eine Beziehung zwischen dem Längen/Breiten-Verhältnis bei Kron- und Kelchblättern der Art Iris setosa? Um dies grafisch untersuchen zu können, transformieren Sie den iris Datensatz:

x <- iris |>
  filter(Species == 'setosa') |>
  mutate(
    sepal_lw = Sepal.Length/Sepal.Width,
    petal_lw = Petal.Length/Petal.Width
  )

plot(x$sepal_lw, x$petal_lw,
  pch = 20, col = "blue",
  xlab="L/B Kelchblatt",
  ylab="L/B Kronblatt"
)

Q3

Erstellen Sie basierend auf dem iris Datensatz eine Tabelle, welche nur die Spalte ‘Species’ enthält und eine neue (absteigend sortierte) Spalte mit dem Quotienten aus der Kelchblattlänge zu -breite. Die Tabelle soll aber nur die Arten I. versicolor und I. virginica und Quotientenwerte größer 2 enthalten:

iris |>
  mutate(sepal_lw = Sepal.Length/Sepal.Width) |>
  filter(Species %in% c('versicolor', 'virginica'), sepal_lw > 2) |>
  select(Species, sepal_lw) |>
  arrange(desc(sepal_lw)) |>
  head(10) # nur zur Anzeige hier gekürzt
      Species sepal_lw
1   virginica 2.961538
2  versicolor 2.818182
3   virginica 2.750000
4  versicolor 2.739130
5  versicolor 2.727273
6   virginica 2.727273
7   virginica 2.680000
8   virginica 2.642857
9   virginica 2.566667
10  virginica 2.533333

Transformation: Daten aggregieren

Datenaggregation | Zusammenfassung

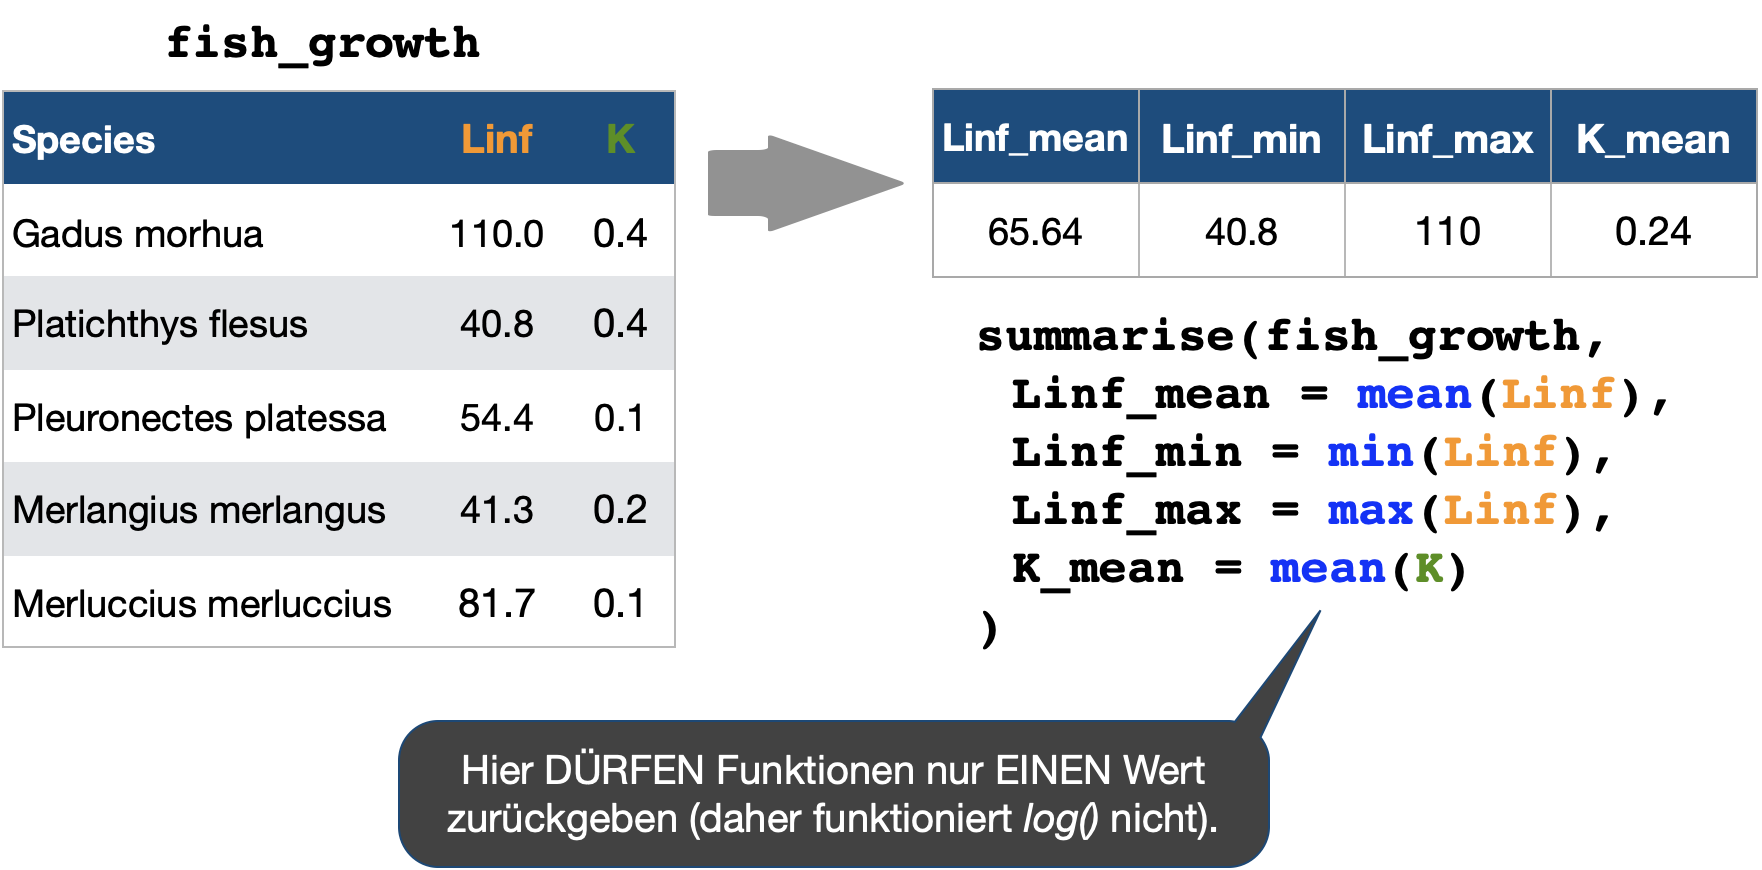
summarise() → reduziert Variablen zu Einzelwerten:

Datenaggregation | Helferfunktion

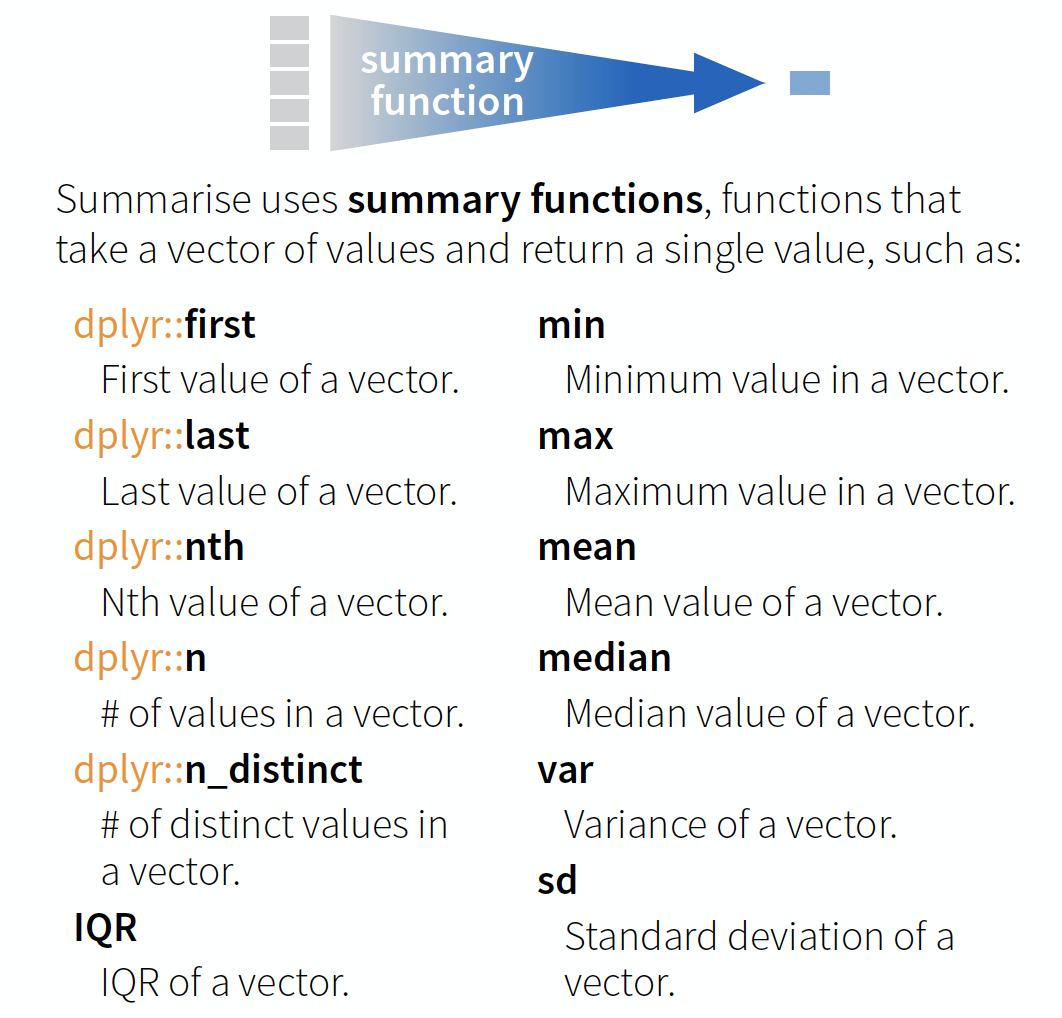
Hilfreiche Funktionen, die zusammenfassen

Quelle: ältere Version des sog. cheatsheets
Data Transformation with dplyr (lizenziert unter CC-BY-SA).

Datenaggregation | ‘Shortcuts’

Es gibt 2 sehr nützliche Funktionen, die man anstelle von summarise() nutzen kann:

  • count() → zur Berechnung der Anzahl an Zeilen (auch direkt pro Gruppe!)
  • distinct() → zum Entfernen von Duplikaten (Zeilen mit komplett gleichem Inhalt in den jeweiligen Spalten)
count()
iris |>
  summarise(n = n())
    n
1 150
# vs.
iris |>
  count()
    n
1 150
# Anzahl pro Art:
iris |>
  count(Species)
     Species  n
1     setosa 50
2 versicolor 50
3  virginica 50
distinct()
iris |>
  filter(Species == "setosa") |>
  select(Species, Sepal.Length) |>
  distinct() |>
  as_tibble() # nur zur Anzeige hier
# A tibble: 15 × 2
   Species Sepal.Length
   <fct>          <dbl>
 1 setosa           5.1
 2 setosa           4.9
 3 setosa           4.7
 4 setosa           4.6
 5 setosa           5  
 6 setosa           5.4
 7 setosa           4.4
 8 setosa           4.8
 9 setosa           4.3
10 setosa           5.8
11 setosa           5.7
12 setosa           5.2
13 setosa           5.5
14 setosa           4.5
15 setosa           5.3

→ Wie Sie sehen, wurden die 50 Zeilen auf 15 reduziert.

Datenaggregation | Beispiel iris 1

Berechnung einer Statistik für mehrere Variablen gleichzeitig:

Mittelwert für 4 Spalten
iris |>
  summarise(
    SL_mean = mean(Sepal.Length),
    SW_mean = mean(Sepal.Width),
    PL_mean = mean(Petal.Length),
    PW_mean = mean(Petal.Width)
  )
   SL_mean  SW_mean PL_mean  PW_mean
1 5.843333 3.057333   3.758 1.199333

→ Viel Schreibarbeit, wenn mehr als nur der Mittelwert berechnet werden soll…

Lösung: Die Helferfunktion across()

Berechnung einer Statistik für mehrere Variablen gleichzeitig:

across() wendet eine Funktion auf mehrere Spalten an
iris |>
  summarise(
    across(
      .cols = Sepal.Length:Petal.Width,
      .fns = mean
    )
  )
  Sepal.Length Sepal.Width Petal.Length Petal.Width
1     5.843333    3.057333        3.758    1.199333

Lösung: Die Helferfunktion across() | 2

Berechnung mehrerer deskriptiver Statistiken für alle kontinuierlichen Variablen → hier muss eine Liste dem .fns Argument übergeben werden:

Mehrere Funktionen als benannte Liste
iris |>
  summarise(
    across(
      .cols = Sepal.Length:Petal.Width,
      .fns = list(mean = mean, median = median, sd = sd)
    )
  )
  Sepal.Length_mean Sepal.Length_median Sepal.Length_sd Sepal.Width_mean
1          5.843333                 5.8       0.8280661         3.057333
  Sepal.Width_median Sepal.Width_sd Petal.Length_mean Petal.Length_median
1                  3      0.4358663             3.758                4.35
  Petal.Length_sd Petal.Width_mean Petal.Width_median Petal.Width_sd
1        1.765298         1.199333                1.3      0.7622377

Aber moment mal…

…was ist, wenn wir die Statistiken für bestimmte Gruppen (wie hier die Arten) getrennt bestimmen wollen????
Lösung: Operationen gruppenweise durchführen

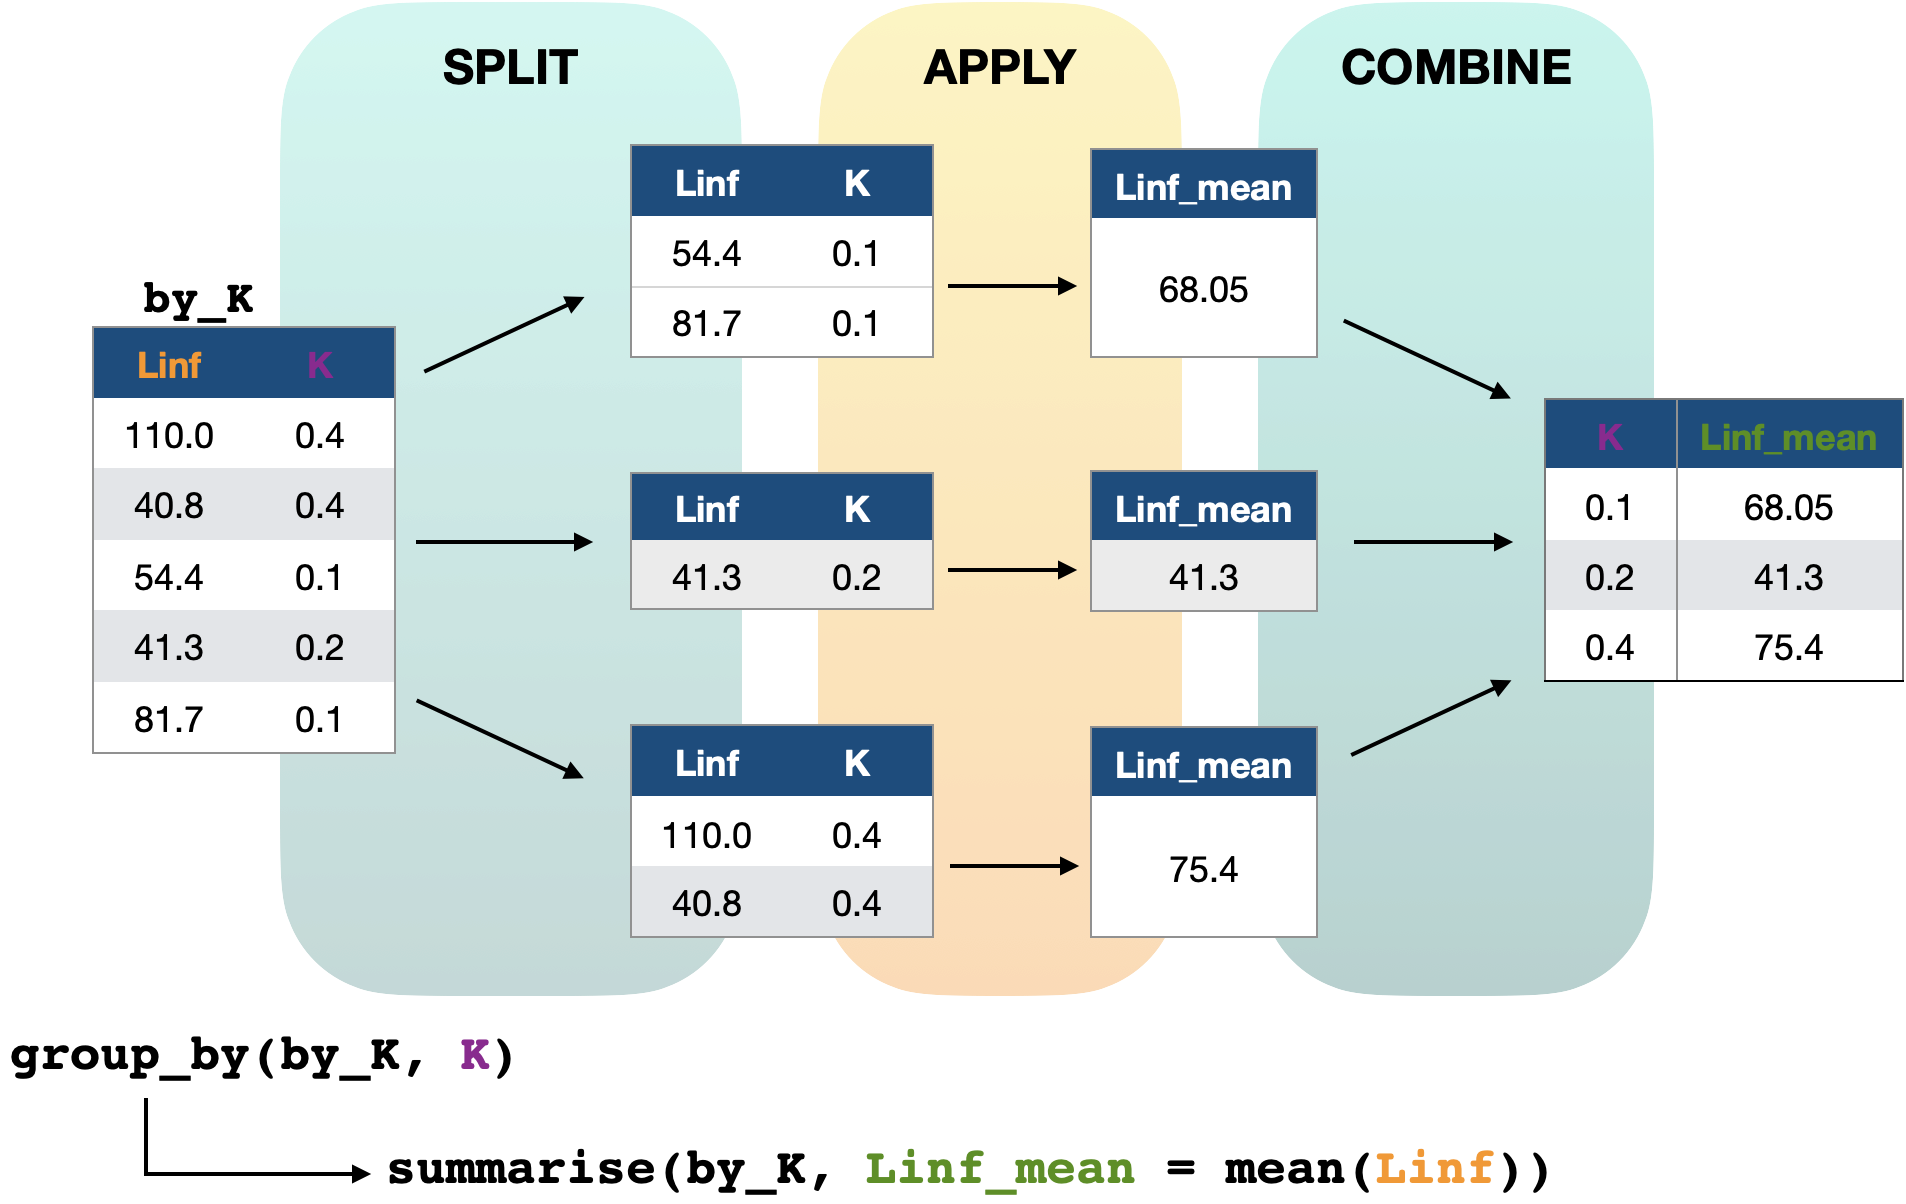
  • group_by() nimmt eine existierende Tabelle und konvertiert sie in eine gruppierte Tabelle, in der Operationen gruppenweise durchgeführt werden können.
  • ungroup() entfernt die Gruppierung wieder.

Prinzipien der gruppenweisen Operationen

Gruppierte Datenaggregation | iris

Mittelwerte pro Art
iris |>
  group_by(Species) |> # einfach diesen Befehl einschieben
  summarise(
    across(
      .cols = Sepal.Length:Petal.Width,
      .fns = mean
    )
  )
# A tibble: 3 × 5
  Species    Sepal.Length Sepal.Width Petal.Length Petal.Width
  <fct>             <dbl>       <dbl>        <dbl>       <dbl>
1 setosa             5.01        3.43         1.46       0.246
2 versicolor         5.94        2.77         4.26       1.33 
3 virginica          6.59        2.97         5.55       2.03 

Gruppierung zeitweise entfernen | iris

Mittelwerte über alle Arten
iris |>
  # group_by(Species) |> # Befehl auskommentieren
  summarise(
    across(
      .cols = Sepal.Length:Petal.Width,
      .fns = mean
    )
  )
  Sepal.Length Sepal.Width Petal.Length Petal.Width
1     5.843333    3.057333        3.758    1.199333

Wann braucht man ungroup()?

  • Eine Gruppierung bleibt am Objekt ‘hängen’ – auch für alle nachfolgenden Schritte!
  • summarise() entfernt eine Gruppierungsebene. Bei einer Gruppierungsvariable ist das Ergebnis danach ungruppiert, bei mehreren bleiben die übrigen Gruppierungen bestehen.
  • Funktionen wie mutate(), filter() oder count() behalten die Gruppierung bei.
Gruppierung bleibt erhalten
iris |>
  group_by(Species) |>
  count()
# A tibble: 3 × 2
# Groups:   Species [3]
  Species        n
  <fct>      <int>
1 setosa        50
2 versicolor    50
3 virginica     50
Gruppierung entfernen
iris |>
  group_by(Species) |>
  count() |>
  ungroup()
# A tibble: 3 × 2
  Species        n
  <fct>      <int>
1 setosa        50
2 versicolor    50
3 virginica     50

→ Faustregel: Nach dem gruppierten Arbeitsschritt ungroup() ergänzen – dann gibt es später keine Überraschungen.

Neu seit dplyr 1.1: Gruppieren mit .by

Statt group_by() + ungroup() können Sie die Gruppierung auch direkt in der Funktion angeben – sie gilt dann nur für diesen einen Schritt, das Ergebnis ist automatisch ungruppiert:

Klassisch mit group_by()
iris |>
  group_by(Species) |>
  summarise(PL_mean = mean(Petal.Length))
# A tibble: 3 × 2
  Species    PL_mean
  <fct>        <dbl>
1 setosa        1.46
2 versicolor    4.26
3 virginica     5.55
Neu mit .by
iris |>
  summarise(
    PL_mean = mean(Petal.Length),
    .by = Species
  )
     Species PL_mean
1     setosa   1.462
2 versicolor   4.260
3  virginica   5.552

→ Das .by Argument gibt es auch in mutate(), filter() & Co. In diesem Kurs verwenden wir weiterhin meist group_by(), weil sich die Zeile zum Testen so bequem auskommentieren lässt.

Kontrollparameter einbauen | iris

  • Kontrollieren Sie jeden Zwischenschritt zwei- oder dreimal!
  • Überprüfen Sie bei Aggregationen und numerischen Zusammenfassungen immer, ob die richtige Anzahl an Datenpunkten auch eingeflossen ist. Denn dies kann ein Hinweis auf fehlerhaftes Aggregieren sein:
Mit n() die Zeilenzahl anzeigen
iris |>
  group_by(Species) |>
  summarise(
    PL_median = median(Petal.Length),
    N = n()  # Klammer leer lassen
  )
# A tibble: 3 × 3
  Species    PL_median     N
  <fct>          <dbl> <int>
1 setosa          1.5     50
2 versicolor      4.35    50
3 virginica       5.55    50

Achtung bei NAs

→ Denken Sie bei fehlenden Werten auch an na.rm = TRUE (z.B. median(x, na.rm = TRUE))!

Your turn …

Quiz 4-5 | Datenaggregation

Q4

Berechnen Sie pro Art: Median, Mittelwert, Standardabweichung und Minimalwert für die Kronblattlänge:

iris |>
  group_by(Species) |>
  summarise(
    pl_median = median(Petal.Length),
    pl_mean = mean(Petal.Length),
    pl_sd = sd(Petal.Length),
    pl_min = min(Petal.Length)
  )
# A tibble: 3 × 5
  Species    pl_median pl_mean pl_sd pl_min
  <fct>          <dbl>   <dbl> <dbl>  <dbl>
1 setosa          1.5     1.46 0.174    1  
2 versicolor      4.35    4.26 0.470    3  
3 virginica       5.55    5.55 0.552    4.5

Q5

Berechnen Sie die Stichprobengröße (= Zeilenanzahl) pro Ernährungsgruppe im ChickWeight Datensatz:

dplyr::glimpse(ChickWeight) # aehnlich wie die str() Funktion
Rows: 578
Columns: 4
$ weight <dbl> 42, 51, 59, 64, 76, 93, 106, 125, 149, 171, 199, 205, 40, 49, 5…
$ Time   <dbl> 0, 2, 4, 6, 8, 10, 12, 14, 16, 18, 20, 21, 0, 2, 4, 6, 8, 10, 1…
$ Chick  <ord> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 2, 2, 2, 2, 2, 2, 2, …
$ Diet   <fct> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, …
ChickWeight |>
  group_by(Diet) |>
  count()
# A tibble: 4 × 2
# Groups:   Diet [4]
  Diet      n
  <fct> <int>
1 1       220
2 2       120
3 3       120
4 4       118
# oder kürzer (Ergebnis ist dann ungruppiert):
ChickWeight |>
  count(Diet)
  Diet   n
1    1 220
2    2 120
3    3 120
4    4 118

Transformation: Datensätze kombinieren

Kombination von Tabellen | 1

Zeilenweise nach Position

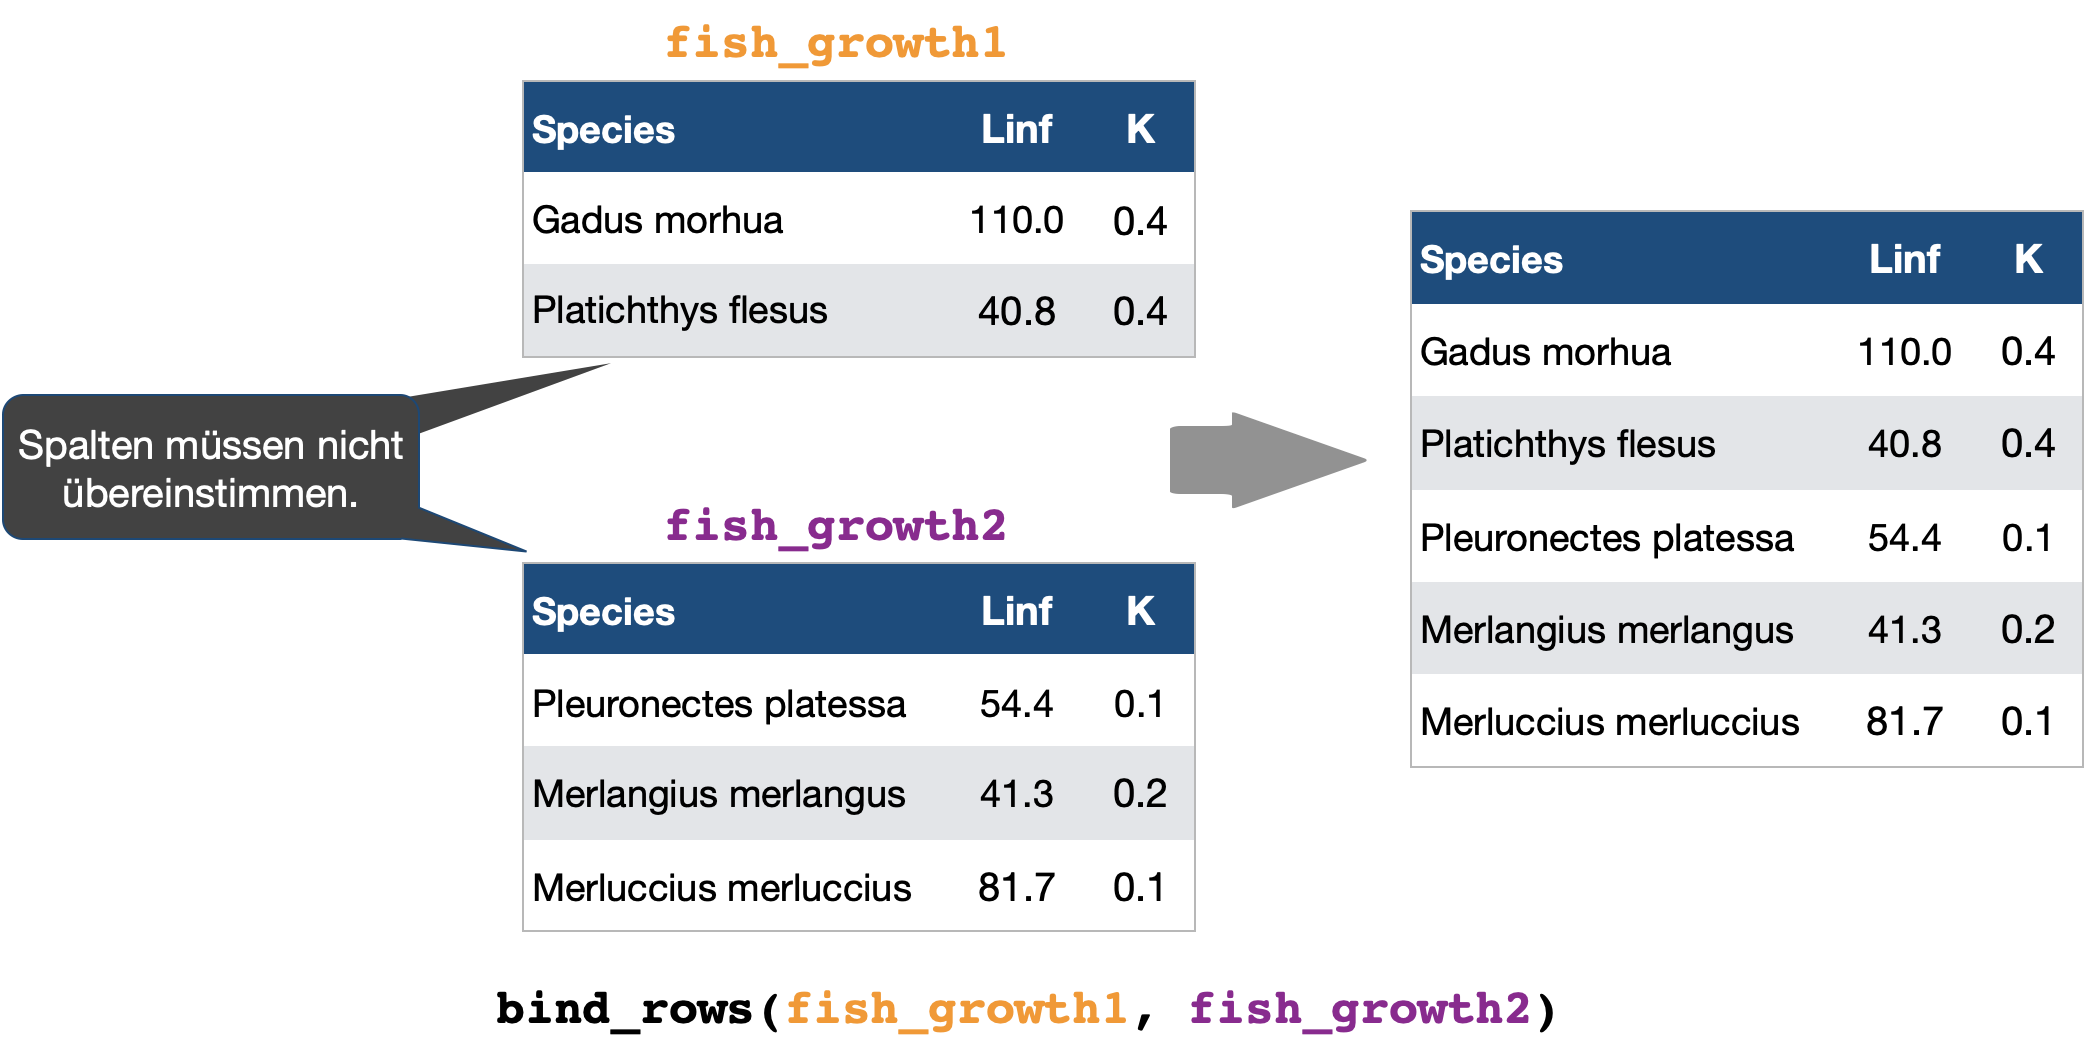
bind_rows() → hängt 2 oder mehr Tabellen zeilenweise aneinander:

Spalten werden nach Namen abgeglichen und fehlende Spalten werden mit NA aufgefüllt.

Kombination von Tabellen | 2

Spaltenweise nach Position

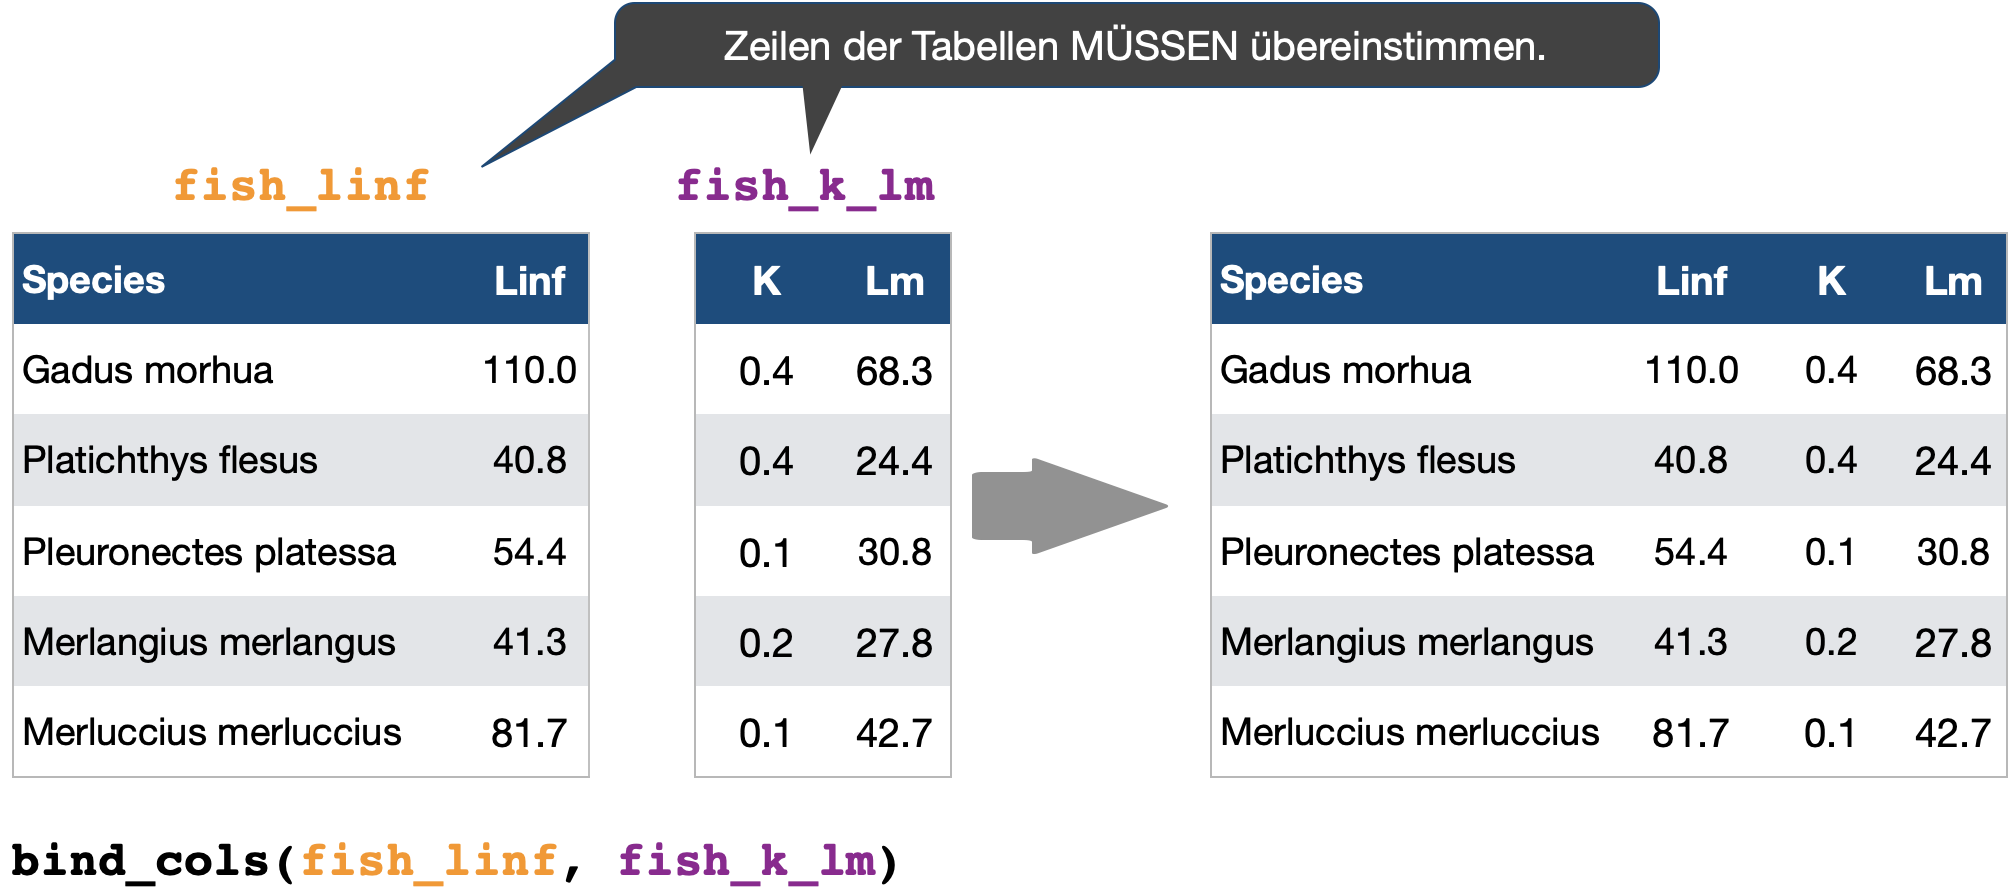
bind_cols() → hängt 2 oder mehr Tabellen spaltenweise aneinander:

Zeilen werden hier entsprechend ihrer Position verknüpft.
→ Für eine Verknüpfung über die Werte nutzen Sie eine der folgenden XXX_join() Funktionen!

Kombination von Tabellen | 3

Zusammenfügung über Werte

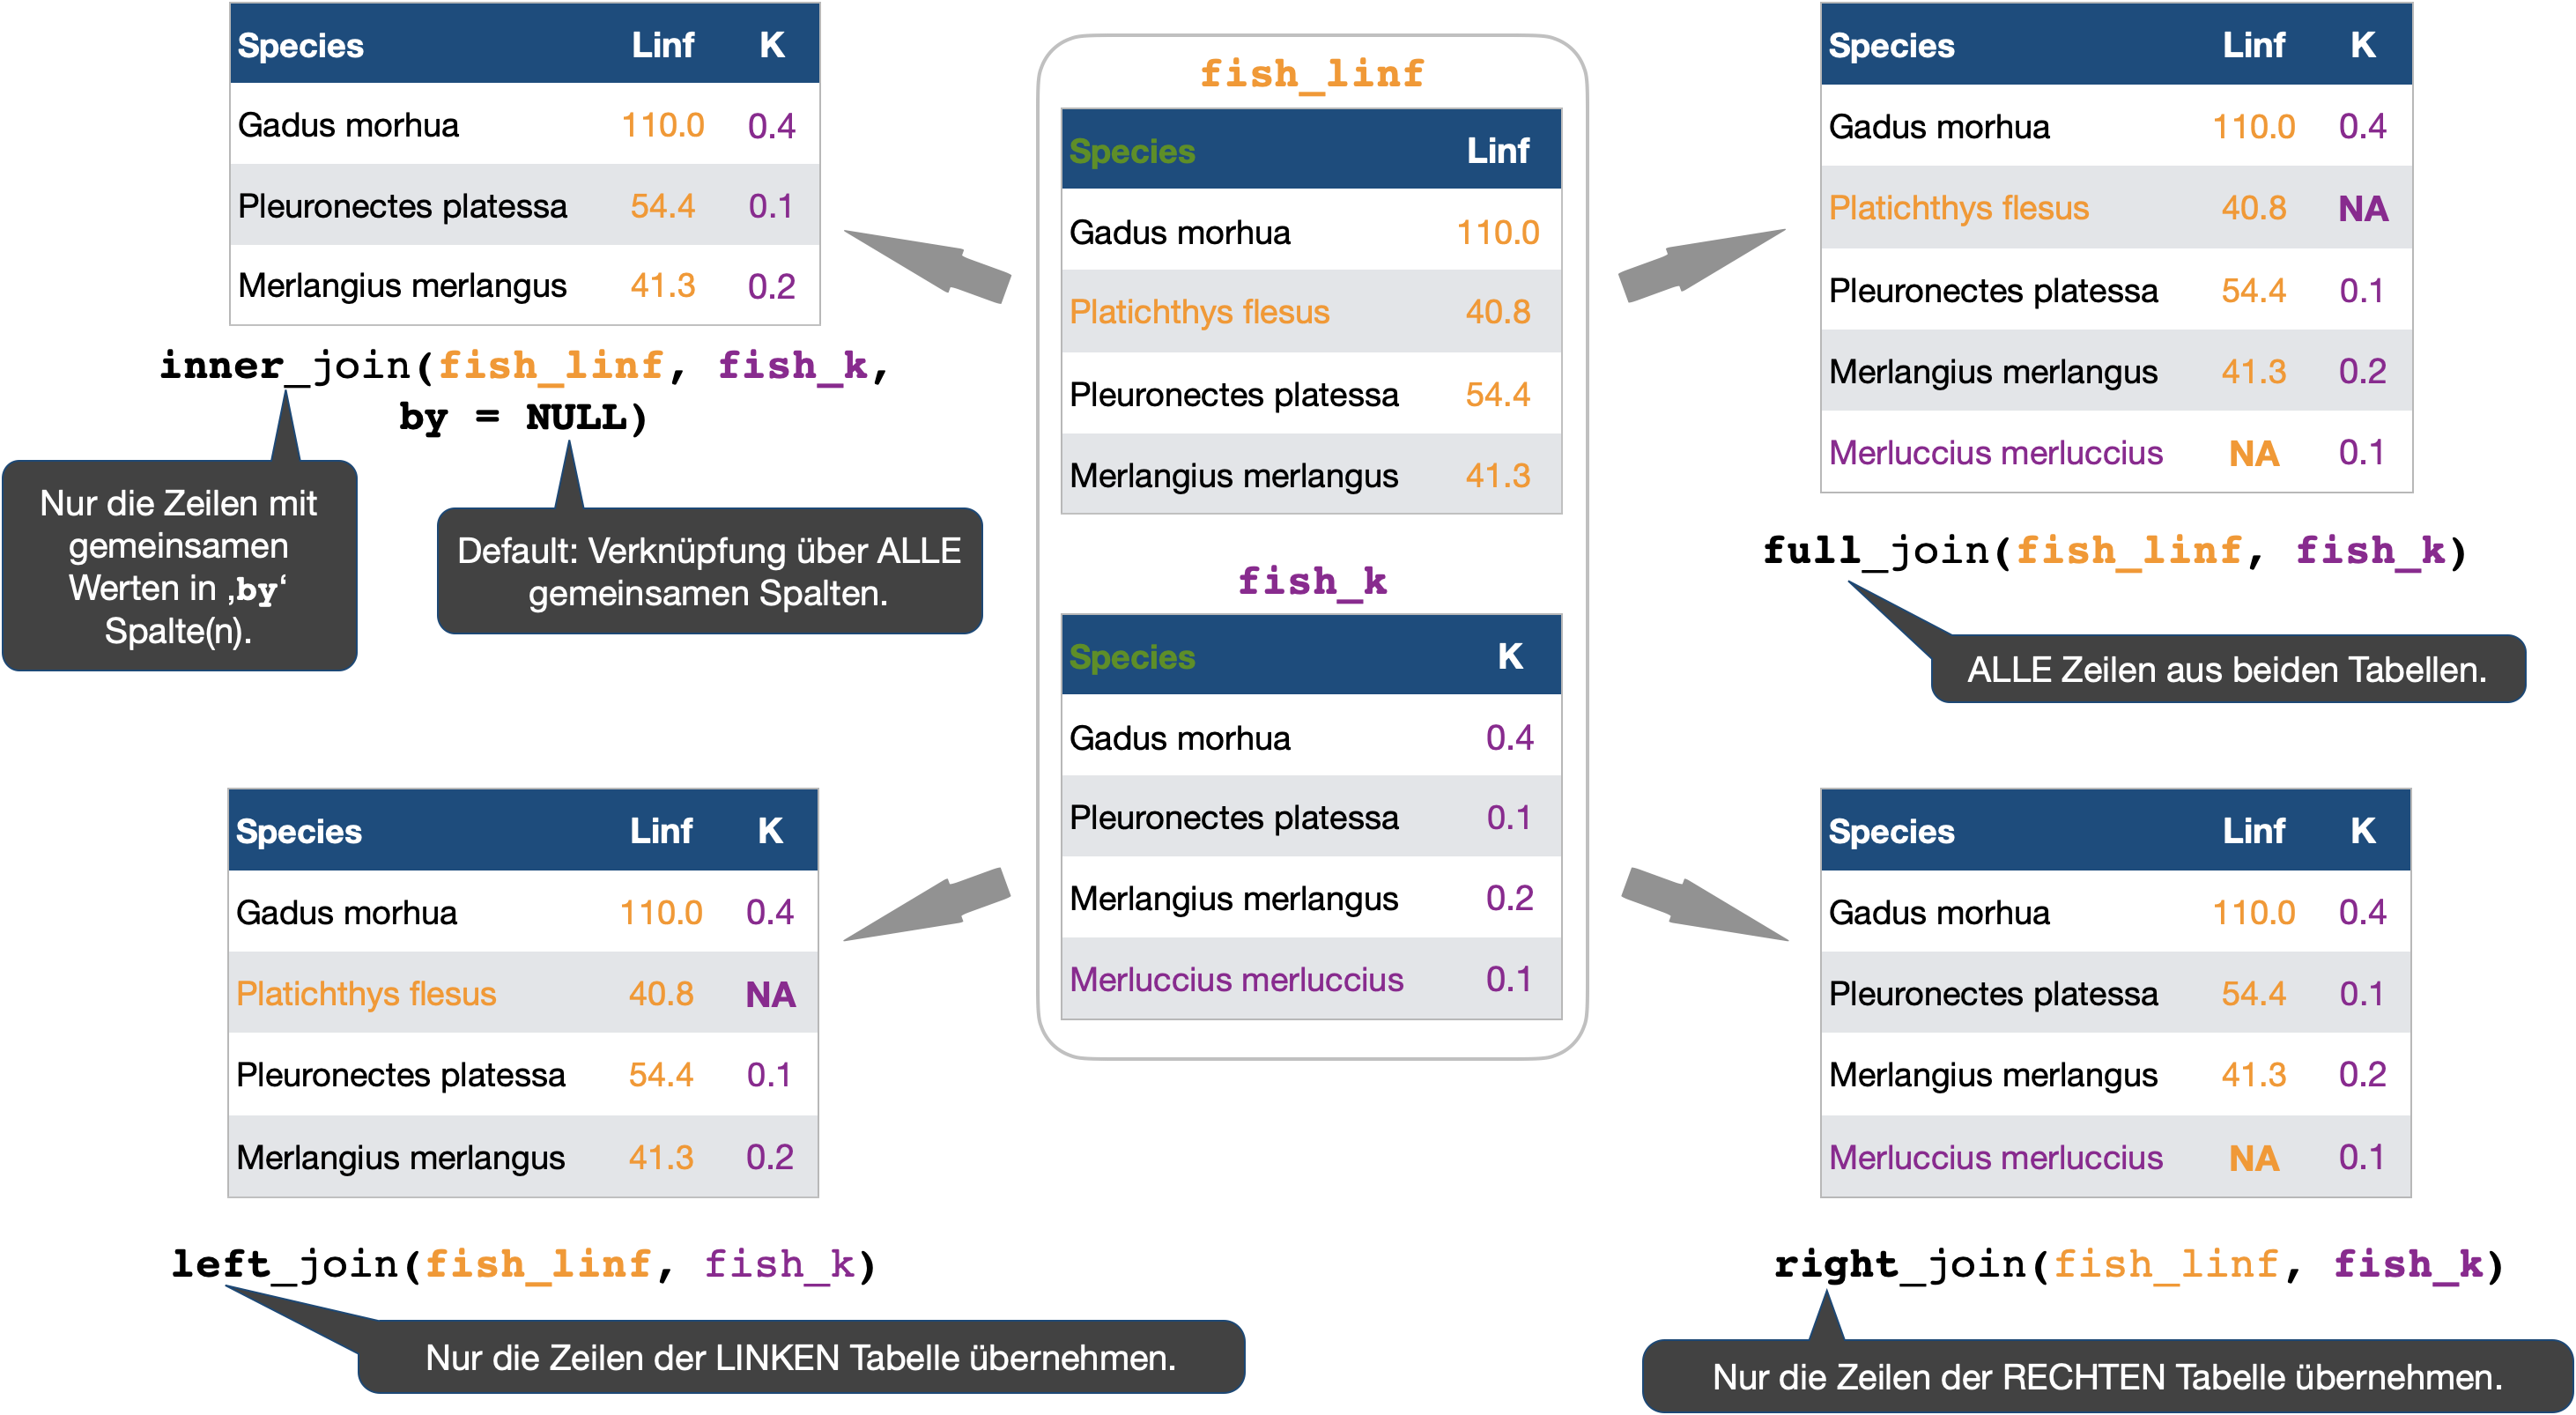
XXX_join() → Die Funktionsgruppe verbindet Tabellen basierend auf gleichen Werten in übereinstimmenden Spalten (‘Schlüsselspalten’):

Je nach übereinstimmenden Tabelleninhalten können dabei nur Spalten, nur Zeilen oder beides aneinandergehängt werden.

Joins am Beispiel | Die Daten

Zu unseren Wachstumsdaten (fish_growth) haben wir eine zweite Tabelle mit deutschen Namen und Familien – allerdings nicht für dieselben Arten:

Tabelle 1: Wachstum
fish_growth
# A tibble: 5 × 3
  Species                Linf     K
  <chr>                 <dbl> <dbl>
1 Gadus morhua          110     0.4
2 Platichthys flesus     40.8   0.4
3 Pleuronectes platessa  54.4   0.1
4 Merlangius merlangus   41.3   0.2
5 Merluccius merluccius  81.7   0.1


→ Die gemeinsame Schlüsselspalte ist Species. Der Seehecht (Merluccius merluccius) fehlt in Tabelle 2, der Hering (Clupea harengus) in Tabelle 1.

Tabelle 2: Zusatzinfos
fish_info <- tibble(
  Species = c("Gadus morhua", "Platichthys flesus",
    "Pleuronectes platessa", "Merlangius merlangus",
    "Clupea harengus"),
  Name_de = c("Kabeljau", "Flunder", "Scholle",
    "Wittling", "Hering"),
  Familie = c("Gadidae", "Pleuronectidae", 
    "Pleuronectidae", "Gadidae", "Clupeidae")
)
fish_info
# A tibble: 5 × 3
  Species               Name_de  Familie       
  <chr>                 <chr>    <chr>         
1 Gadus morhua          Kabeljau Gadidae       
2 Platichthys flesus    Flunder  Pleuronectidae
3 Pleuronectes platessa Scholle  Pleuronectidae
4 Merlangius merlangus  Wittling Gadidae       
5 Clupea harengus       Hering   Clupeidae     

Joins am Beispiel | left_join() vs. inner_join()

left_join(): alle Zeilen der linken Tabelle
left_join(fish_growth, fish_info,
  by = join_by(Species))
# A tibble: 5 × 5
  Species                Linf     K Name_de  Familie       
  <chr>                 <dbl> <dbl> <chr>    <chr>         
1 Gadus morhua          110     0.4 Kabeljau Gadidae       
2 Platichthys flesus     40.8   0.4 Flunder  Pleuronectidae
3 Pleuronectes platessa  54.4   0.1 Scholle  Pleuronectidae
4 Merlangius merlangus   41.3   0.2 Wittling Gadidae       
5 Merluccius merluccius  81.7   0.1 <NA>     <NA>          

→ Für den Seehecht gibt es keine Zusatzinfos → NA

inner_join(): nur Zeilen, die in beiden vorkommen
inner_join(fish_growth, fish_info,
  by = join_by(Species))
# A tibble: 4 × 5
  Species                Linf     K Name_de  Familie       
  <chr>                 <dbl> <dbl> <chr>    <chr>         
1 Gadus morhua          110     0.4 Kabeljau Gadidae       
2 Platichthys flesus     40.8   0.4 Flunder  Pleuronectidae
3 Pleuronectes platessa  54.4   0.1 Scholle  Pleuronectidae
4 Merlangius merlangus   41.3   0.2 Wittling Gadidae       

→ Seehecht und Hering fallen weg

  • full_join() behält alle Zeilen aus beiden Tabellen (hier 6), right_join() alle der rechten Tabelle.
  • Tipp: Prüfen Sie nach jedem Join die Zeilenanzahl (nrow()) – so fallen fehlende oder doppelte Übereinstimmungen sofort auf.
  • join_by() ist die neue Schreibweise seit dplyr 1.1. Die ältere Variante by = "Species" funktioniert weiterhin.

Joins am Beispiel | left_join() vs. inner_join()

left_join(): alle Zeilen der linken Tabelle
left_join(fish_growth, fish_info,
  by = join_by(Species))
# A tibble: 5 × 5
  Species                Linf     K Name_de  Familie       
  <chr>                 <dbl> <dbl> <chr>    <chr>         
1 Gadus morhua          110     0.4 Kabeljau Gadidae       
2 Platichthys flesus     40.8   0.4 Flunder  Pleuronectidae
3 Pleuronectes platessa  54.4   0.1 Scholle  Pleuronectidae
4 Merlangius merlangus   41.3   0.2 Wittling Gadidae       
5 Merluccius merluccius  81.7   0.1 <NA>     <NA>          

→ Für den Seehecht gibt es keine Zusatzinfos → NA

Tip

  • full_join() behält alle Zeilen aus beiden Tabellen (hier 6), right_join() alle der rechten Tabelle.
  • Tipp: Prüfen Sie nach jedem Join die Zeilenanzahl (nrow()) – so fallen fehlende oder doppelte Übereinstimmungen sofort auf.
  • join_by() ist die neue Schreibweise seit dplyr 1.1. Die ältere Variante by = "Species" funktioniert weiterhin.
inner_join(): nur Zeilen, die in beiden vorkommen
inner_join(fish_growth, fish_info,
  by = join_by(Species))
# A tibble: 4 × 5
  Species                Linf     K Name_de  Familie       
  <chr>                 <dbl> <dbl> <chr>    <chr>         
1 Gadus morhua          110     0.4 Kabeljau Gadidae       
2 Platichthys flesus     40.8   0.4 Flunder  Pleuronectidae
3 Pleuronectes platessa  54.4   0.1 Scholle  Pleuronectidae
4 Merlangius merlangus   41.3   0.2 Wittling Gadidae       

→ Seehecht und Hering fallen weg

Your turn …

Quiz 6-7 | Tabellen kombinieren

Q6

4 Arten kommen in beiden Tabellen vor, dazu der Seehecht (nur in fish_growth) und der Hering (nur in fish_info). Fehlende Werte werden mit NA aufgefüllt.

full_join(fish_growth, fish_info, by = join_by(Species))
# A tibble: 6 × 5
  Species                Linf     K Name_de  Familie       
  <chr>                 <dbl> <dbl> <chr>    <chr>         
1 Gadus morhua          110     0.4 Kabeljau Gadidae       
2 Platichthys flesus     40.8   0.4 Flunder  Pleuronectidae
3 Pleuronectes platessa  54.4   0.1 Scholle  Pleuronectidae
4 Merlangius merlangus   41.3   0.2 Wittling Gadidae       
5 Merluccius merluccius  81.7   0.1 <NA>     <NA>          
6 Clupea harengus        NA    NA   Hering   Clupeidae     

Q7

left_join() behält alle Zeilen der linken Tabelle (fish_growth), inner_join() würde den Seehecht entfernen. bind_cols() verknüpft nur nach Position – das ginge hier schief, weil die Arten in den Tabellen nicht in derselben Reihenfolge bzw. nicht vollständig vorliegen.

fish_all <- left_join(fish_growth, fish_info, by = join_by(Species))
fish_all
# A tibble: 5 × 5
  Species                Linf     K Name_de  Familie       
  <chr>                 <dbl> <dbl> <chr>    <chr>         
1 Gadus morhua          110     0.4 Kabeljau Gadidae       
2 Platichthys flesus     40.8   0.4 Flunder  Pleuronectidae
3 Pleuronectes platessa  54.4   0.1 Scholle  Pleuronectidae
4 Merlangius merlangus   41.3   0.2 Wittling Gadidae       
5 Merluccius merluccius  81.7   0.1 <NA>     <NA>          

Zurück zu Demo B..

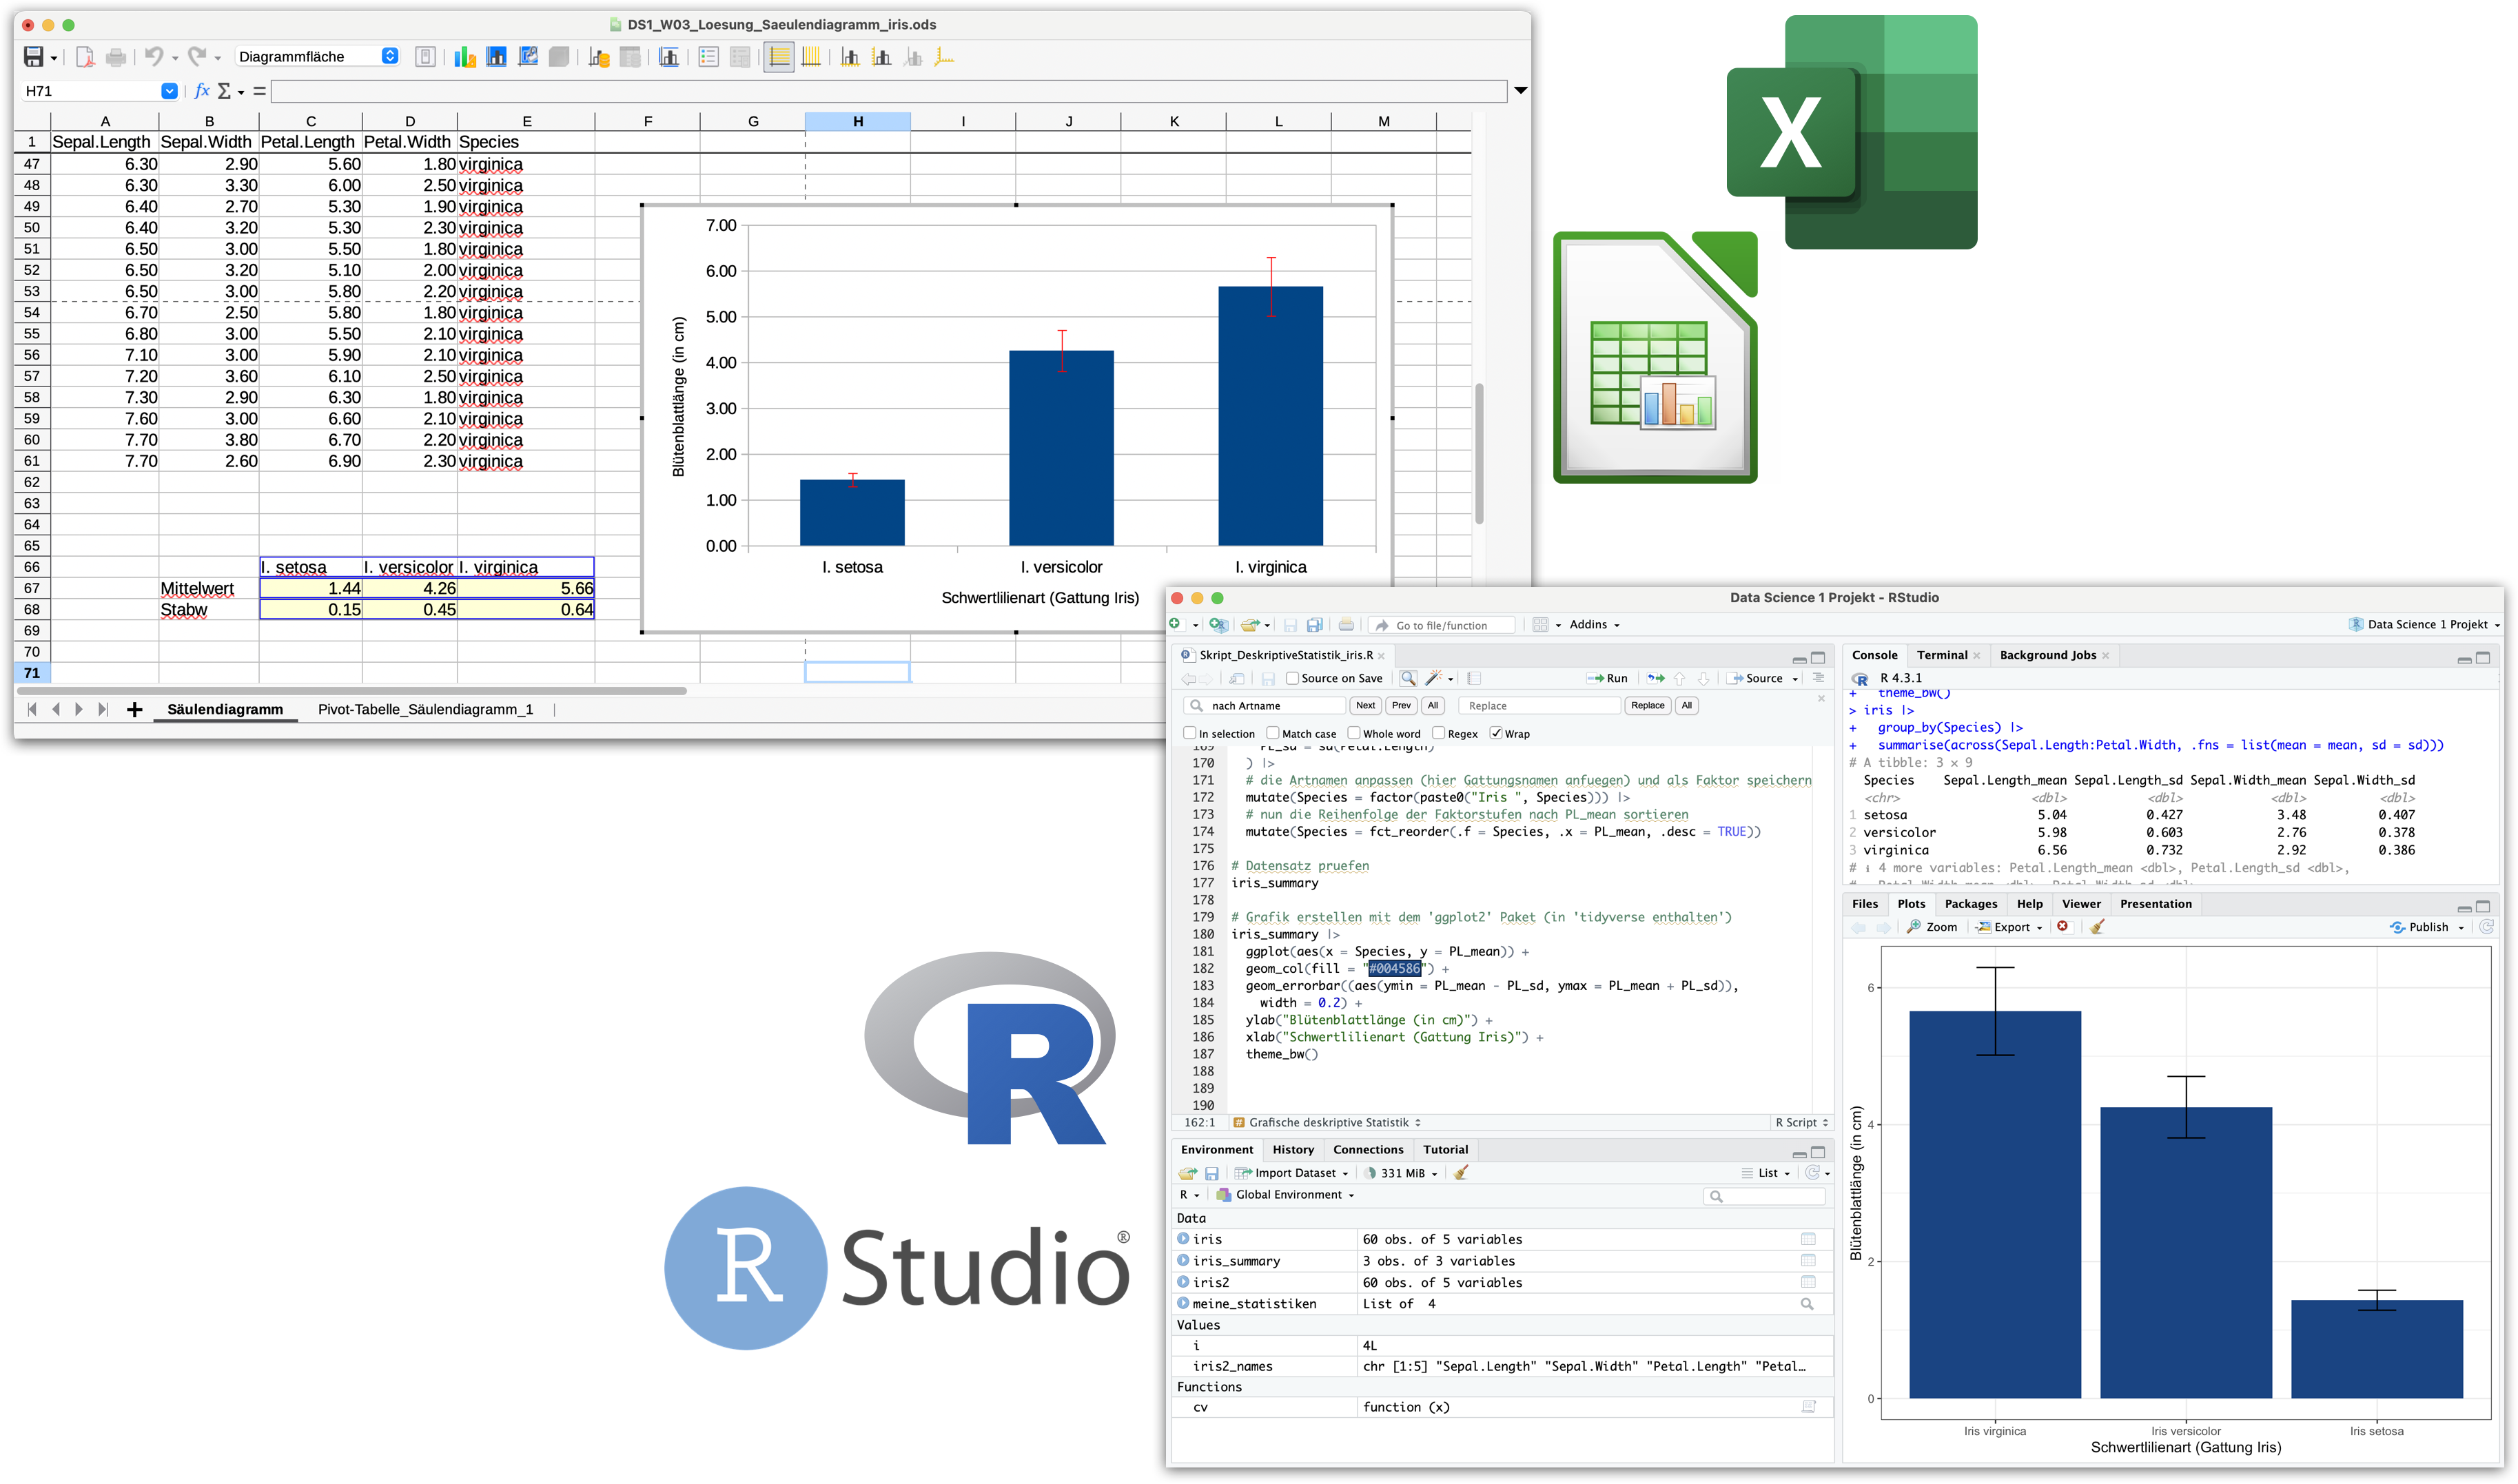
Von Calc zu R wechseln | Demo B

Deskriptive Statistik mit iris

Was haben wir gerade gelernt?

# ------------------------------ Vorbereitung ----------------------------------

#### Laden von Paketen
library(tidyverse) # laedt 9 Pakete

# # (das gleiche wie alle Pakete einzeln zu laden)
# library(dplyr)
# library(forcats)
# library(ggplot2)
# library(lubridate)
# library(purrr)
# library(readr)
# library(stringr)
# library(tibble)
# library(tidyr)

library(DSBtools)
options(DSBtools.language = "de") # Ausgabe auf Deutsch


#### Eigene Funktionen
# Variantionskoeffizient
cv <- function(x) {
  sd(x)/mean(x)
}


# -------------------- Import und Datenaufbereitung ----------------------------

#### Import von CSV-Dateien
# (-> Swirl-Lektion L01 in DSB-03-Datenaufbereitung oder per Anleitung durchs Tidyversum)

# Import der ODS-Datei, welche in den Zeilen 66-68 noch Text enthaelt
iris <- readODS::read_ods("data/DS1_W03_Saeulendiagramm_mit_iris.ods")


#### Prüfung des Imports und Datensichtung
# (-> Swirl-Lektion L02 in DSB-03)

# Prüfung des Datentyps --> IMMER DIREKT NACH DEM IMPORT VERWENDEN!
str(iris)  # str = structure

# Betrachtung des Inhalts
iris
# View(iris)

# Korrektur des Datentyps und der Zeilen
iris <- iris[1:60, ] |>
  mutate(across(Sepal.Length:Petal.Width, as.numeric)) |>
  mutate(Species = as.factor(Species))
str(iris)

# Welche Werte kommen in jeder Spalte vor?
lapply(iris, unique)

### Weitere Funktionen zur Sichtung einzelner Aspekte
head(iris) # zeigt erste 6 Zeilen (Kopfzeilen)
tail(iris) # zeigt letzte 6 Zeilen (Endzeilen)
class(iris) # Identifikation der Objektklasse (Vektor, Matrix, dataframe,..)
nrow(iris) # Anzahl Zeilen
ncol(iris) # Anzahl Spalten
dim(iris) # Anzahl aller Dimensionen
names(iris) # Spaltennamen
typeof(iris$Sepal.Length) # Datentyp von Spalte 'Sepal.Length'
typeof(iris$Species)      # Datentyp von Spalte 'Species'


# ----------------------- Deskriptive Statistik --------------------------------

#### Berechnung mehrerer Statistiken für jede Spalte im data frame

# Klassische Zusammenfassung mit base R (Ausgabe nur in der Konsole)
summary(iris)

# Shortcut mit DSBtools: Statistiken für jede Spalte, passend zum erkannten
# Variablentyp (z.B. Häufigkeiten bei 'Species', Mittelwert & Co. bei den
# metrischen Spalten). Das Ergebnis ist ein Objekt, mit dem Sie weiterarbeiten
# können - speichern Sie es dazu unter einem Namen:
describe_df(data = iris)


#### Berechnung versch. Statistiken der Kronblattlaenge, gruppiert nach Art
# (-> Lektion L01 in DSB-02-Datenexploration mit R)
# (-> Lektion L06-Gruppierte Aggregation in DSB-03)

iris_summary <- iris |>
  group_by(Species) |>
  summarise(
    PL_mean = mean(Petal.Length),                         # Mittelwert
    PL_median = median(Petal.Length),                     # Median
    PL_var = var(Petal.Length),                           # Varianz
    PL_sd = sd(Petal.Length),                             # Standardabweichung
    PL_se = sd(Petal.Length)/sqrt(length(Petal.Length)),  # Standardfehler
    PL_cv = cv(Petal.Length)                              # Variationskoeffizient
  ) |>
  # die Artnamen anpassen (hier Gattungsnamen anfügen) und als Faktor speichern
  mutate(Species = factor(paste0("Iris ", Species))) |>
  # nun die Reihenfolge der Faktorstufen nach PL_mean sortieren
  mutate(Species = fct_reorder(.f = Species, .x = PL_mean, .desc = TRUE))

# Zusammenfassung ansehen
iris_summary

# Kontrolle mit DSBtools: Stimmen Ihre Werte? describe_var() berechnet die
# Statistiken der Variable 'x' getrennt für jede Gruppe in 'by'
# (Angaben zum 95%-Konfidenzintervall -> kommt in Data Science 2)
iris_stats <- describe_var(x = iris$Petal.Length, by = iris$Species)
iris_stats


#### Saeulendiagramm erstellen mit dem 'ggplot2' Paket
#  (siehe auch swirl-Kurs DSB-04-Datenvisualisierung mit ggplot2)

iris_summary |>
  ggplot(aes(x = Species, y = PL_mean)) + # initiert Plot
  # die Saeulen hinzufügen
  geom_col(fill = "#004586") +
  # die Fehlerbalken hinzufügen
  geom_errorbar((aes(ymin = PL_mean - PL_sd, ymax = PL_mean + PL_sd)),
    width = 0.2) +
  # Achsenbeschriftung anpassen
  ylab("Kronblattlänge (in cm)") +
  xlab("Schwertlilienart (Gattung Iris)") +
  # das Layout anpassen
  theme_bw()

Übungen

Optionale swirl-Lektionen zur Vertiefung

Kurs DSB-03-Datenaufbereitung oder per Anleitung durchs Tidyversum

  • L05-Transformation mit dplyr: Manipulation von Zeilen und Spalten
  • L06-Transformation mit dplyr: Gruppierte Aggregation
  • L07-Transformation mit dplyr: Datensätze kombinieren

Übungsaufgaben Woche 8

Alle Aufgaben der Übungswoche finden Sie im Handbuch:

  • die zu bearbeitenden Übungsskripte
  • die (optionalen) swirl-Lektionen und
  • den aktuellen Stand der Fallstudie.
  • Die Übungsskripte und Daten liegen in Ihrem R-Projektordner DS1-R-Uebungen (Unterordner uebungsskripte bzw. data).
  • Öffnen Sie immer zuerst die Projektdatei DS1-R-Uebungen.Rproj, dann stimmen alle Dateipfade.

Wie fühlen Sie sich jetzt…?

Total konfus?


Lesetipps

  • Kapitel Data transformation (inkl. ‘pipe’ Operator) und
  • Kapitel Joins in ‘R for Data Science’ (2. Auflage)
  • Posit und DSB Cheatsheets (s. nächste Folien)

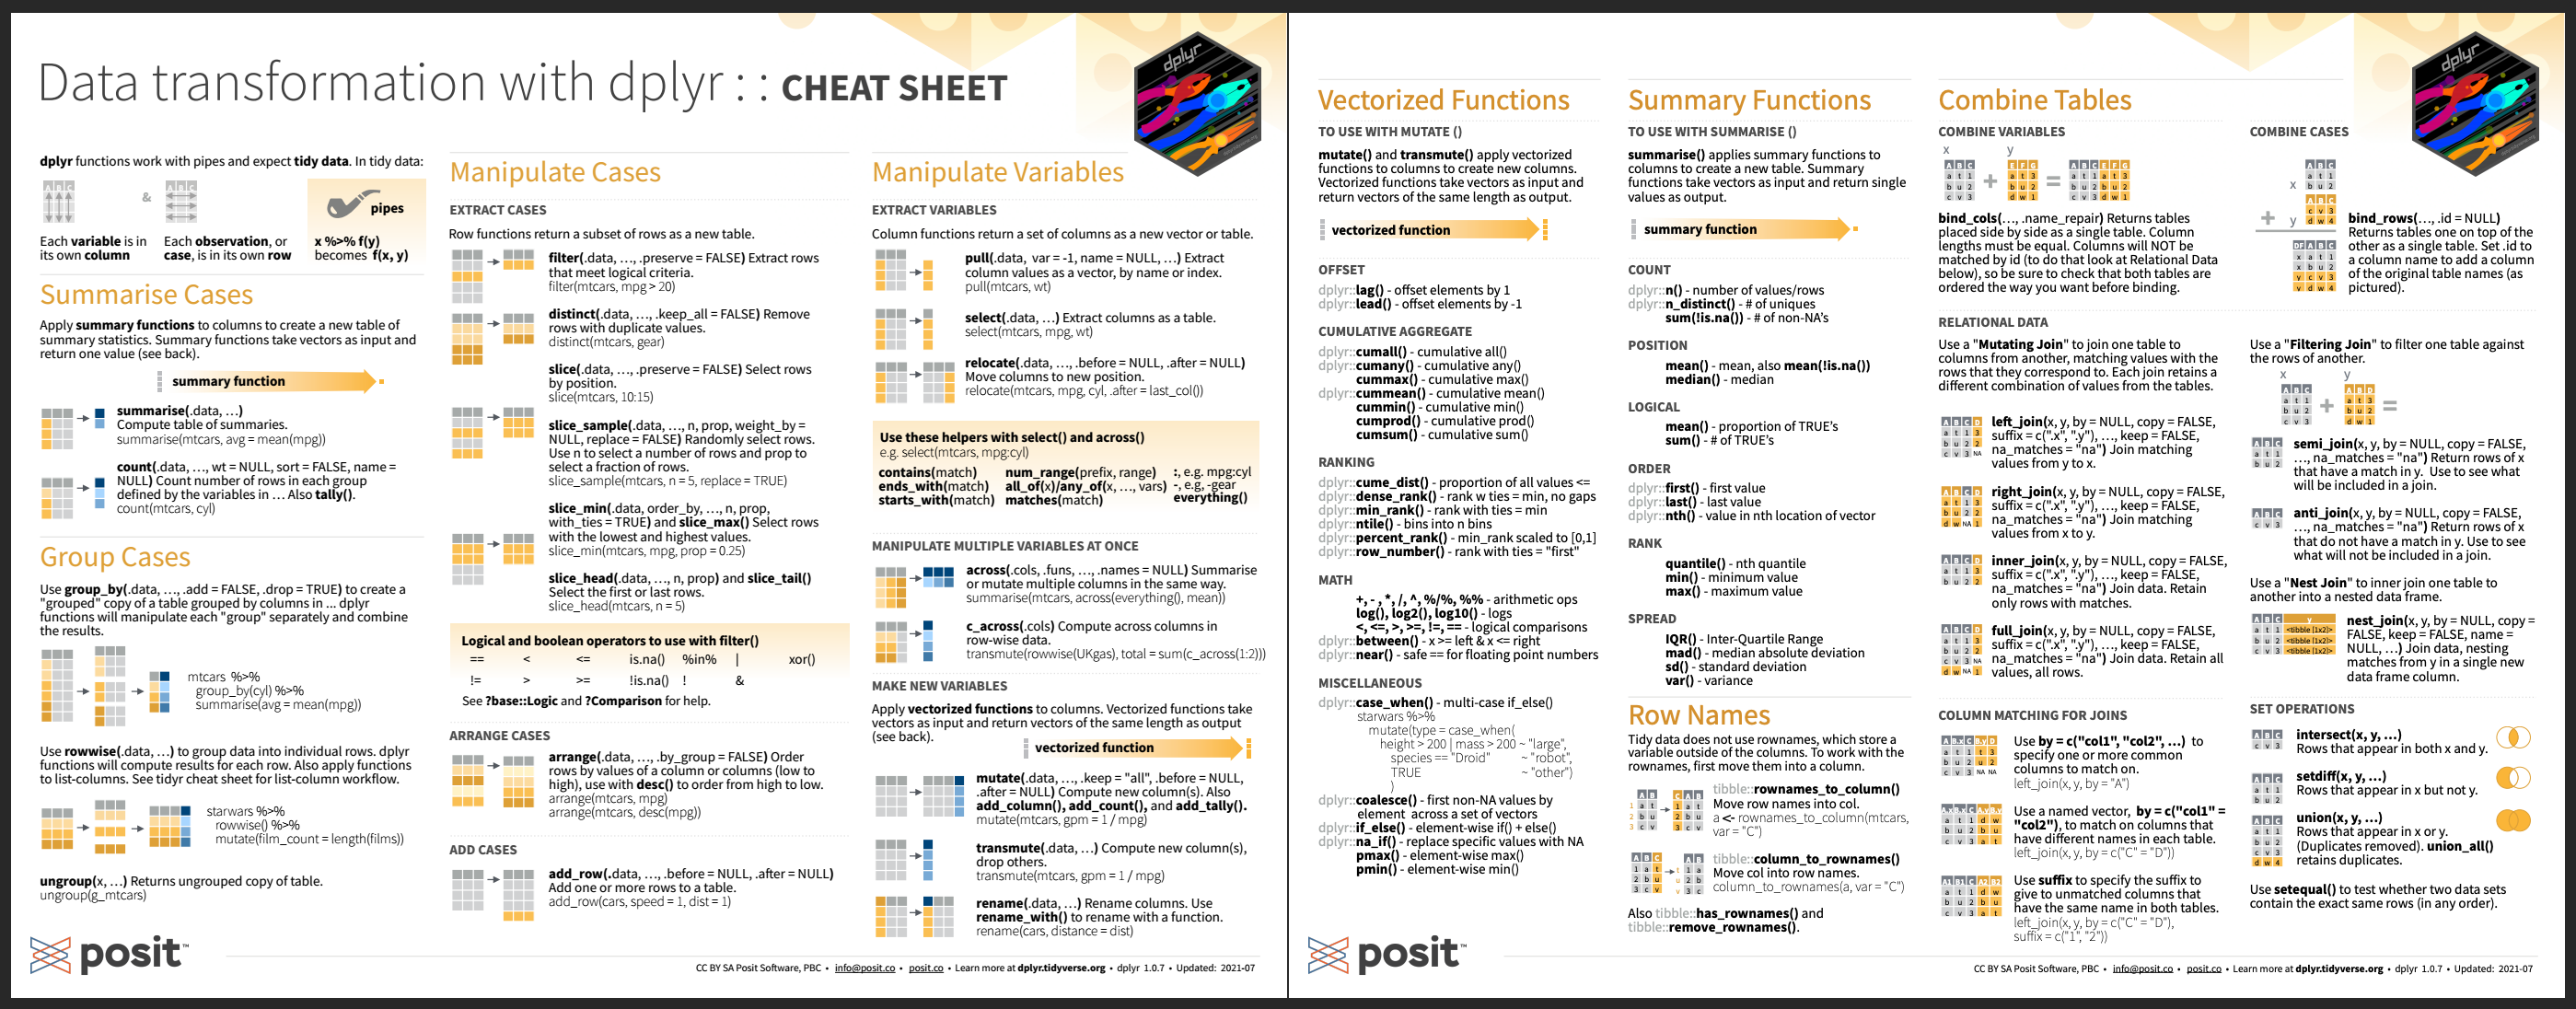
Posit Cheatsheet

Überblick an Funktionen im dplyr Paket

Cheatsheet zum dplyr Paket frei verfügbar unter diesem Link.

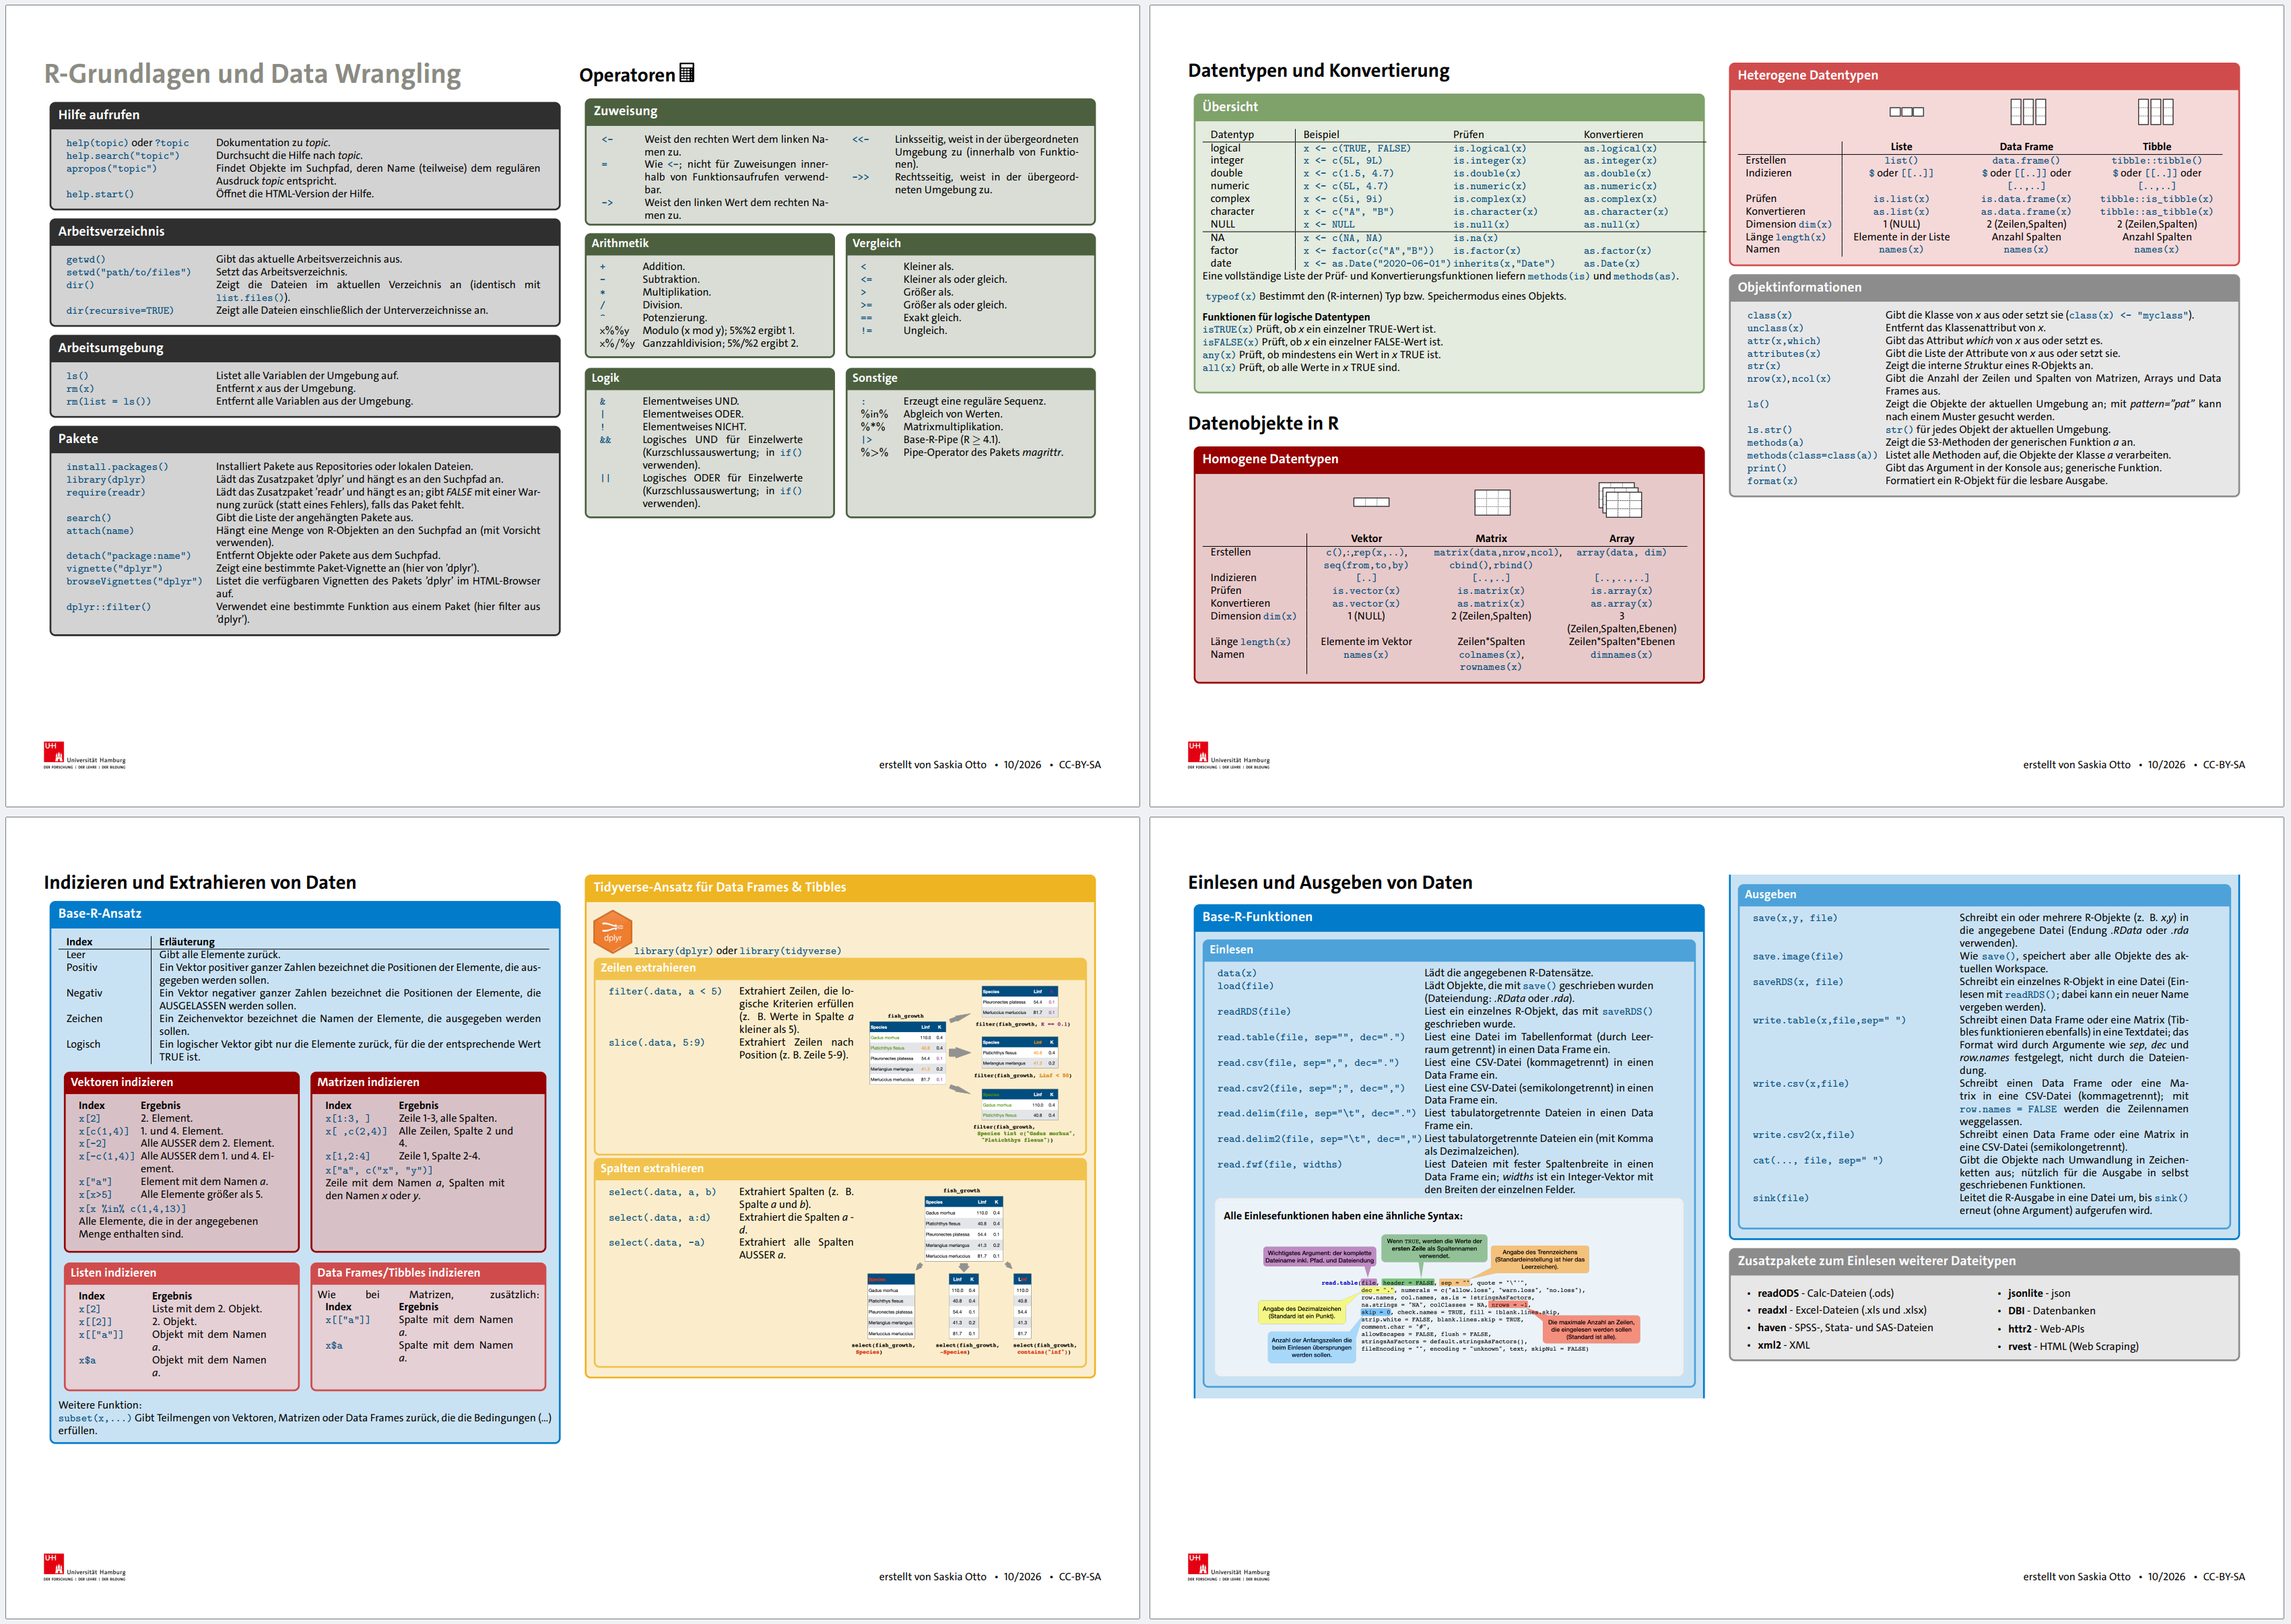
DSB Cheatsheet: R-Grundlagen und Data Wrangling

Enthält wichtigste Funktionen der Datenaufbereitung.

Total gelangweilt?


Dann testen Sie doch Ihr Wissen in folgendem Abschlussquiz…

Abschlussquiz

Bei weiteren Fragen: saskia.otto(at)uni-hamburg.de

Creative Commons License
Diese Arbeit ist lizenziert unter einer Creative Commons Attribution-ShareAlike 4.0 International License mit Ausnahme der entliehenen und mit Quellenangabe versehenen Abbildungen.