
CSV-Datei importieren
# Datei ist im Arbeitsverzeichnis
kabeljau <- read.csv(file = "Wachstum-Futter.csv")
# Alternativ: Angabe des Dateipfads
kabeljau <- read.csv(file = "Pfad/zur/Datei/Wachstum-Futter.csv")
Data Science 1 - Programmieren & Visualisieren
Universität Hamburg, IMF
Wintersemester

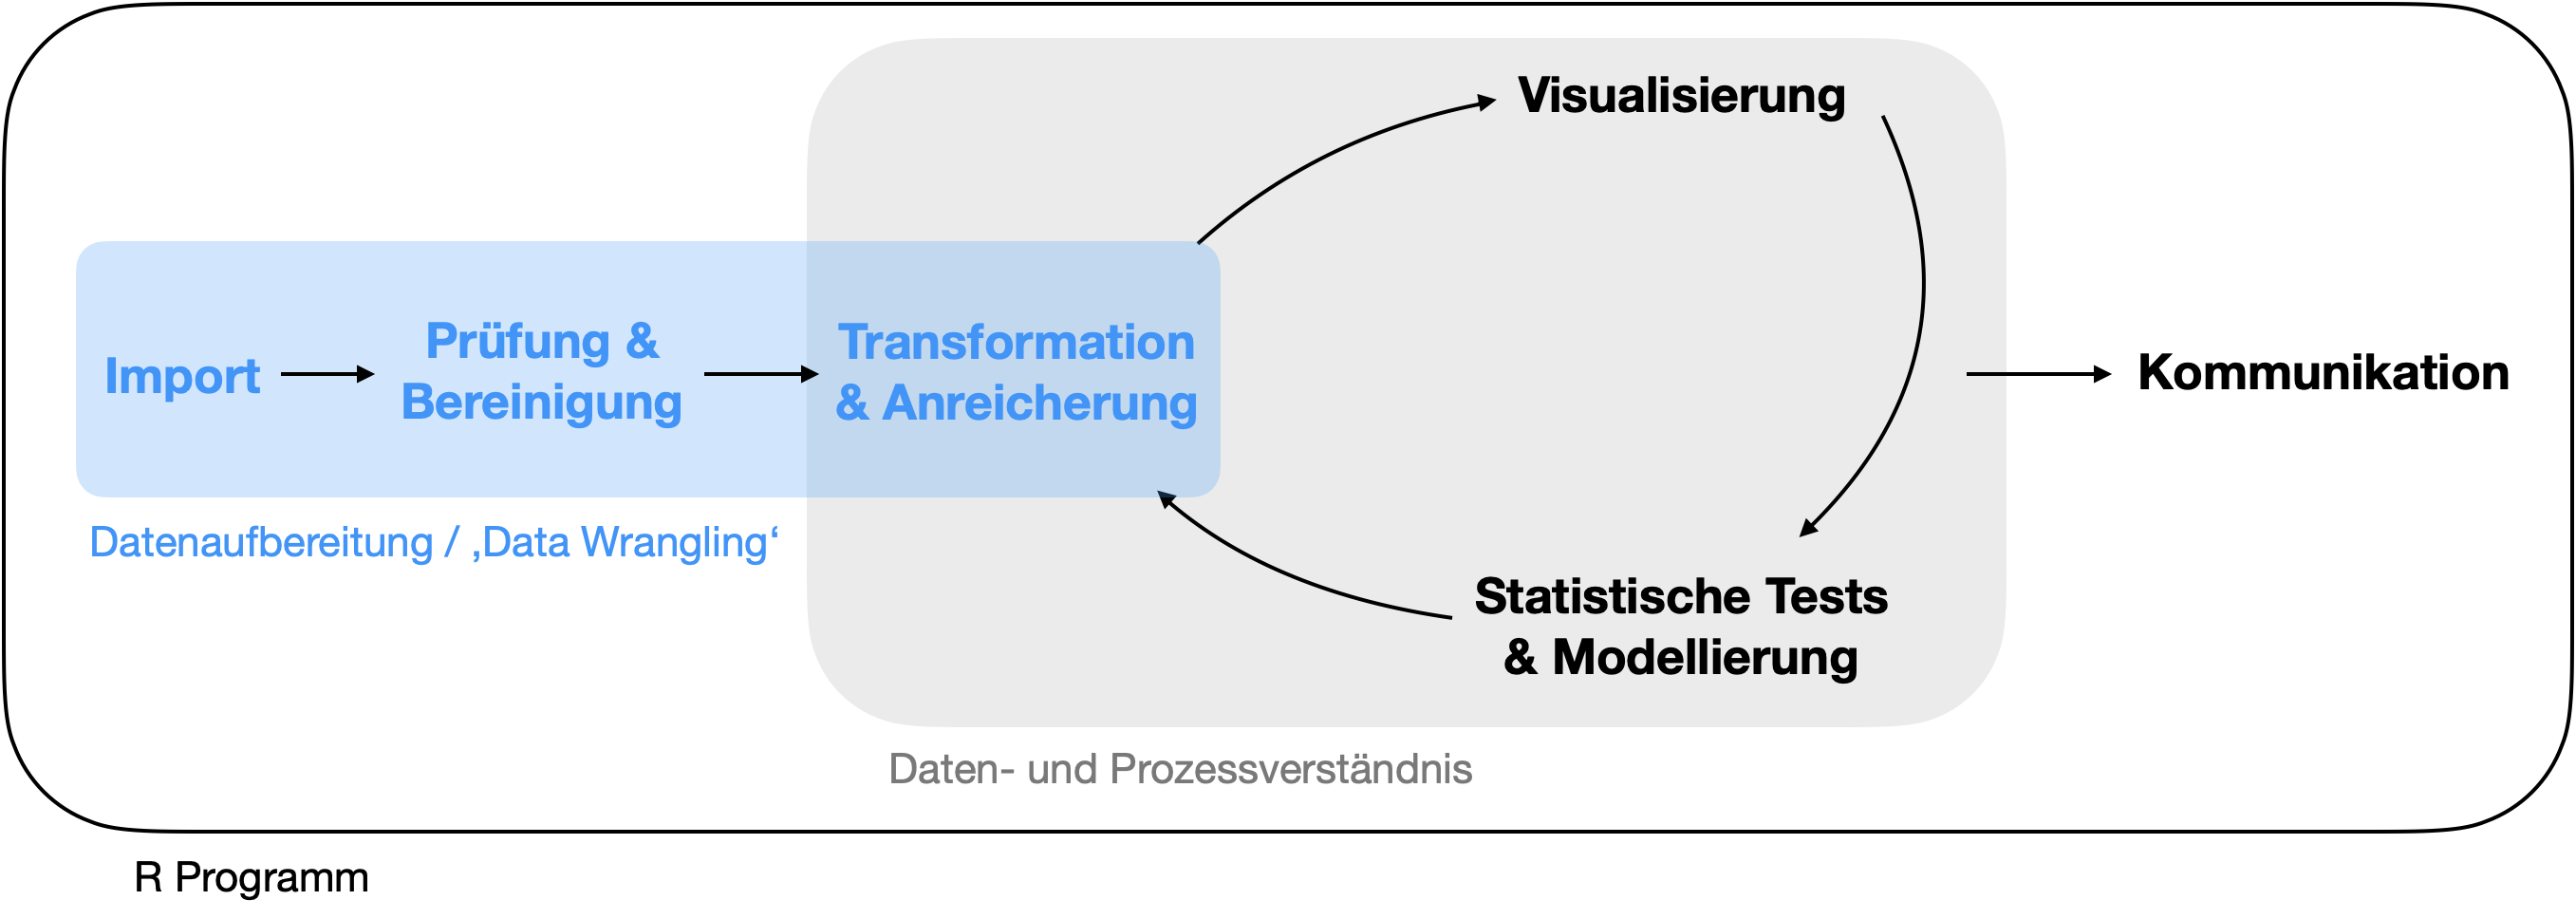
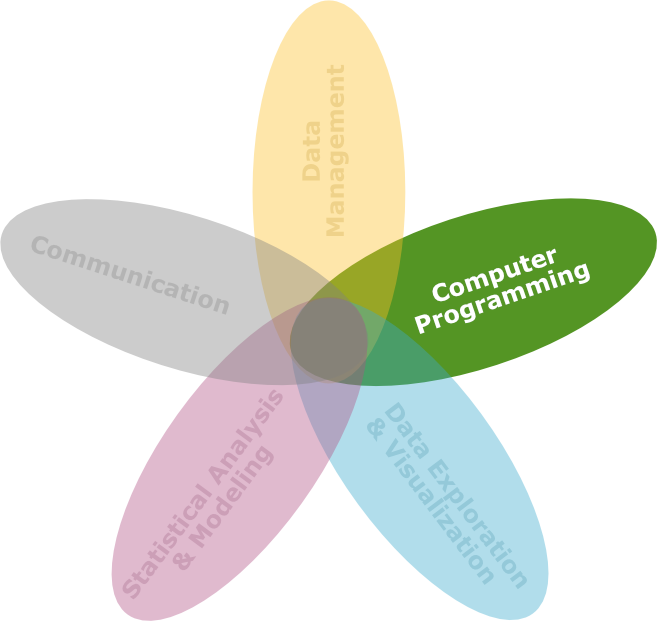
Die Datenaufbereitung
Modifiziert von: R for Data Science von Wickham & Grolemund, 2017 (lizenziert unter CC-BY-NC-ND 3.0 US).
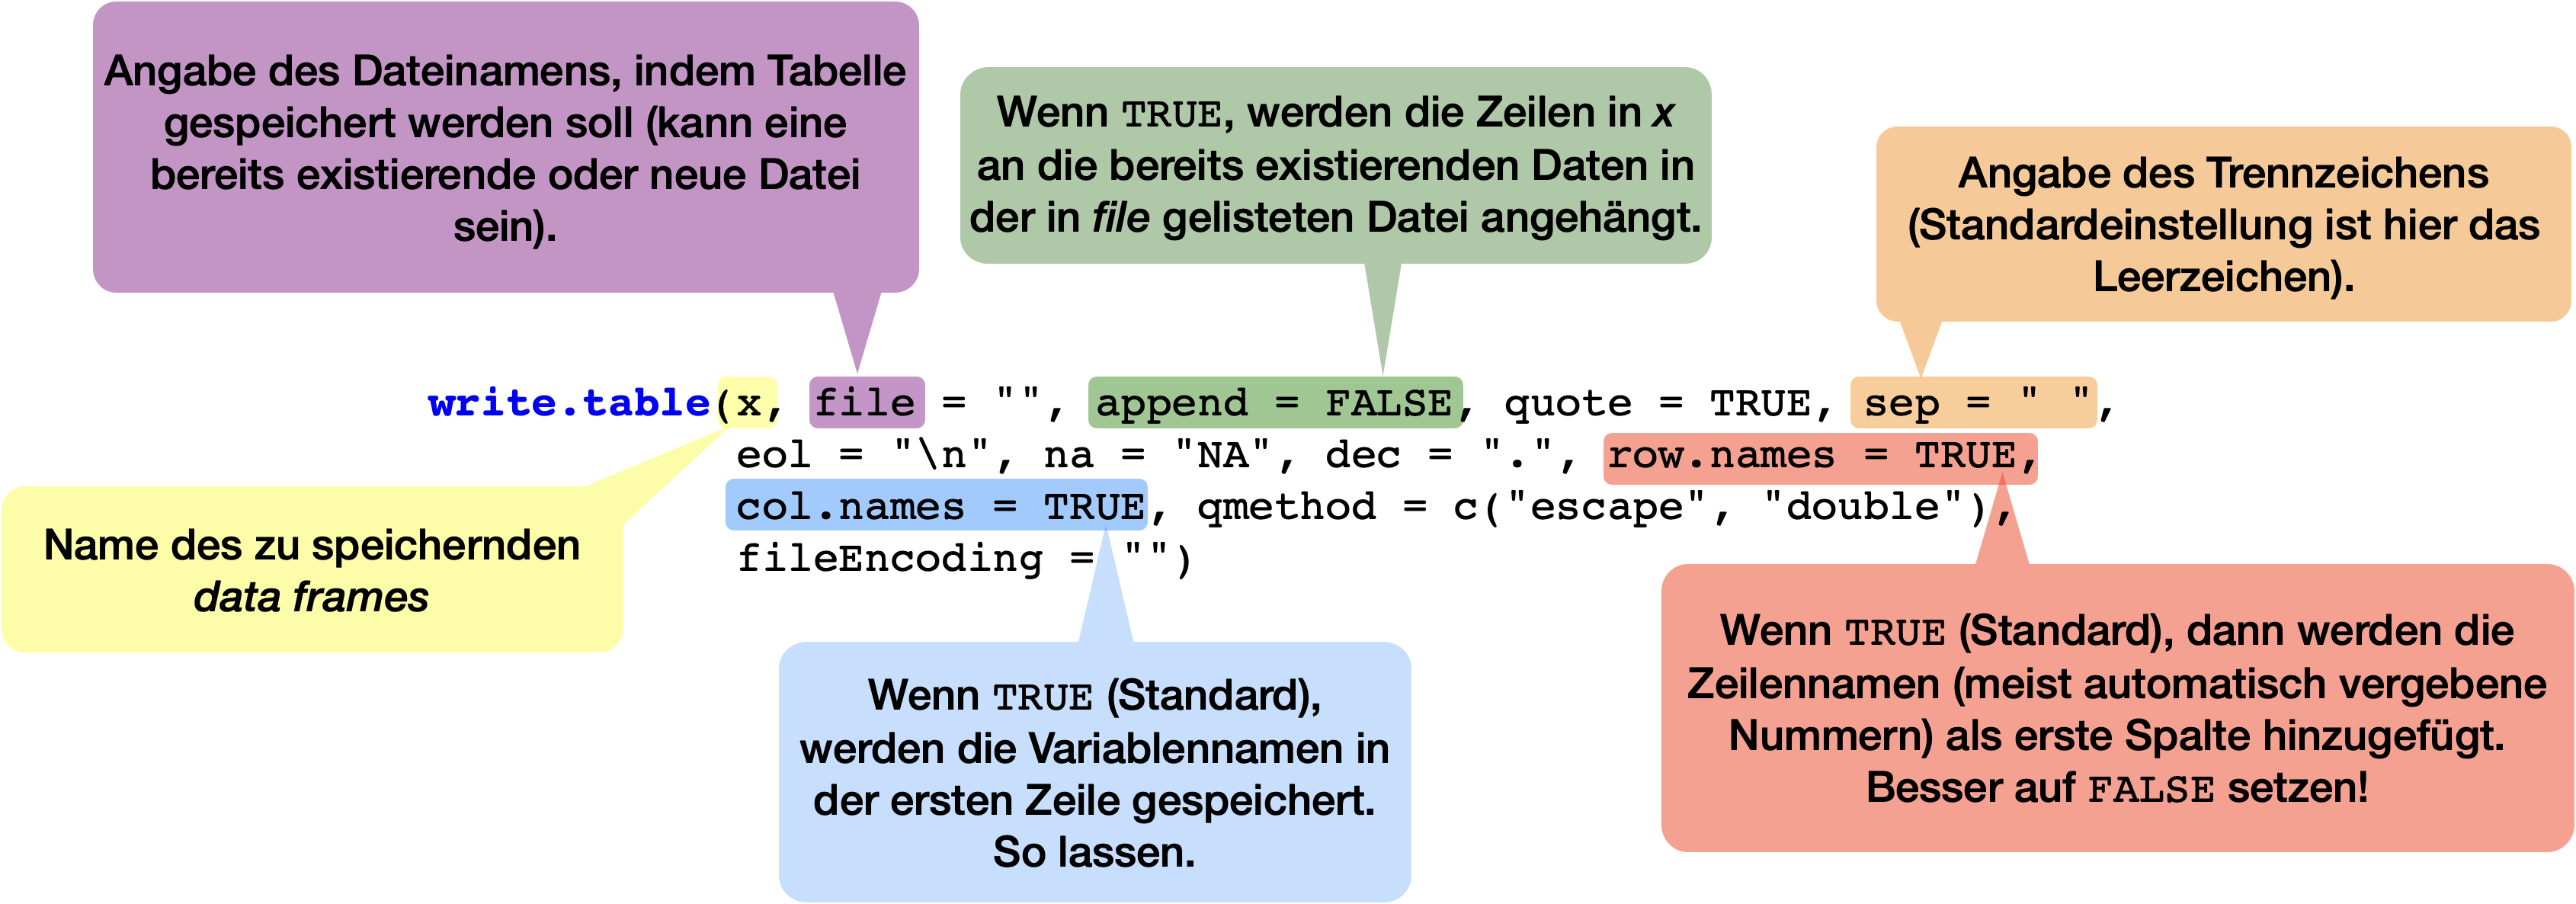
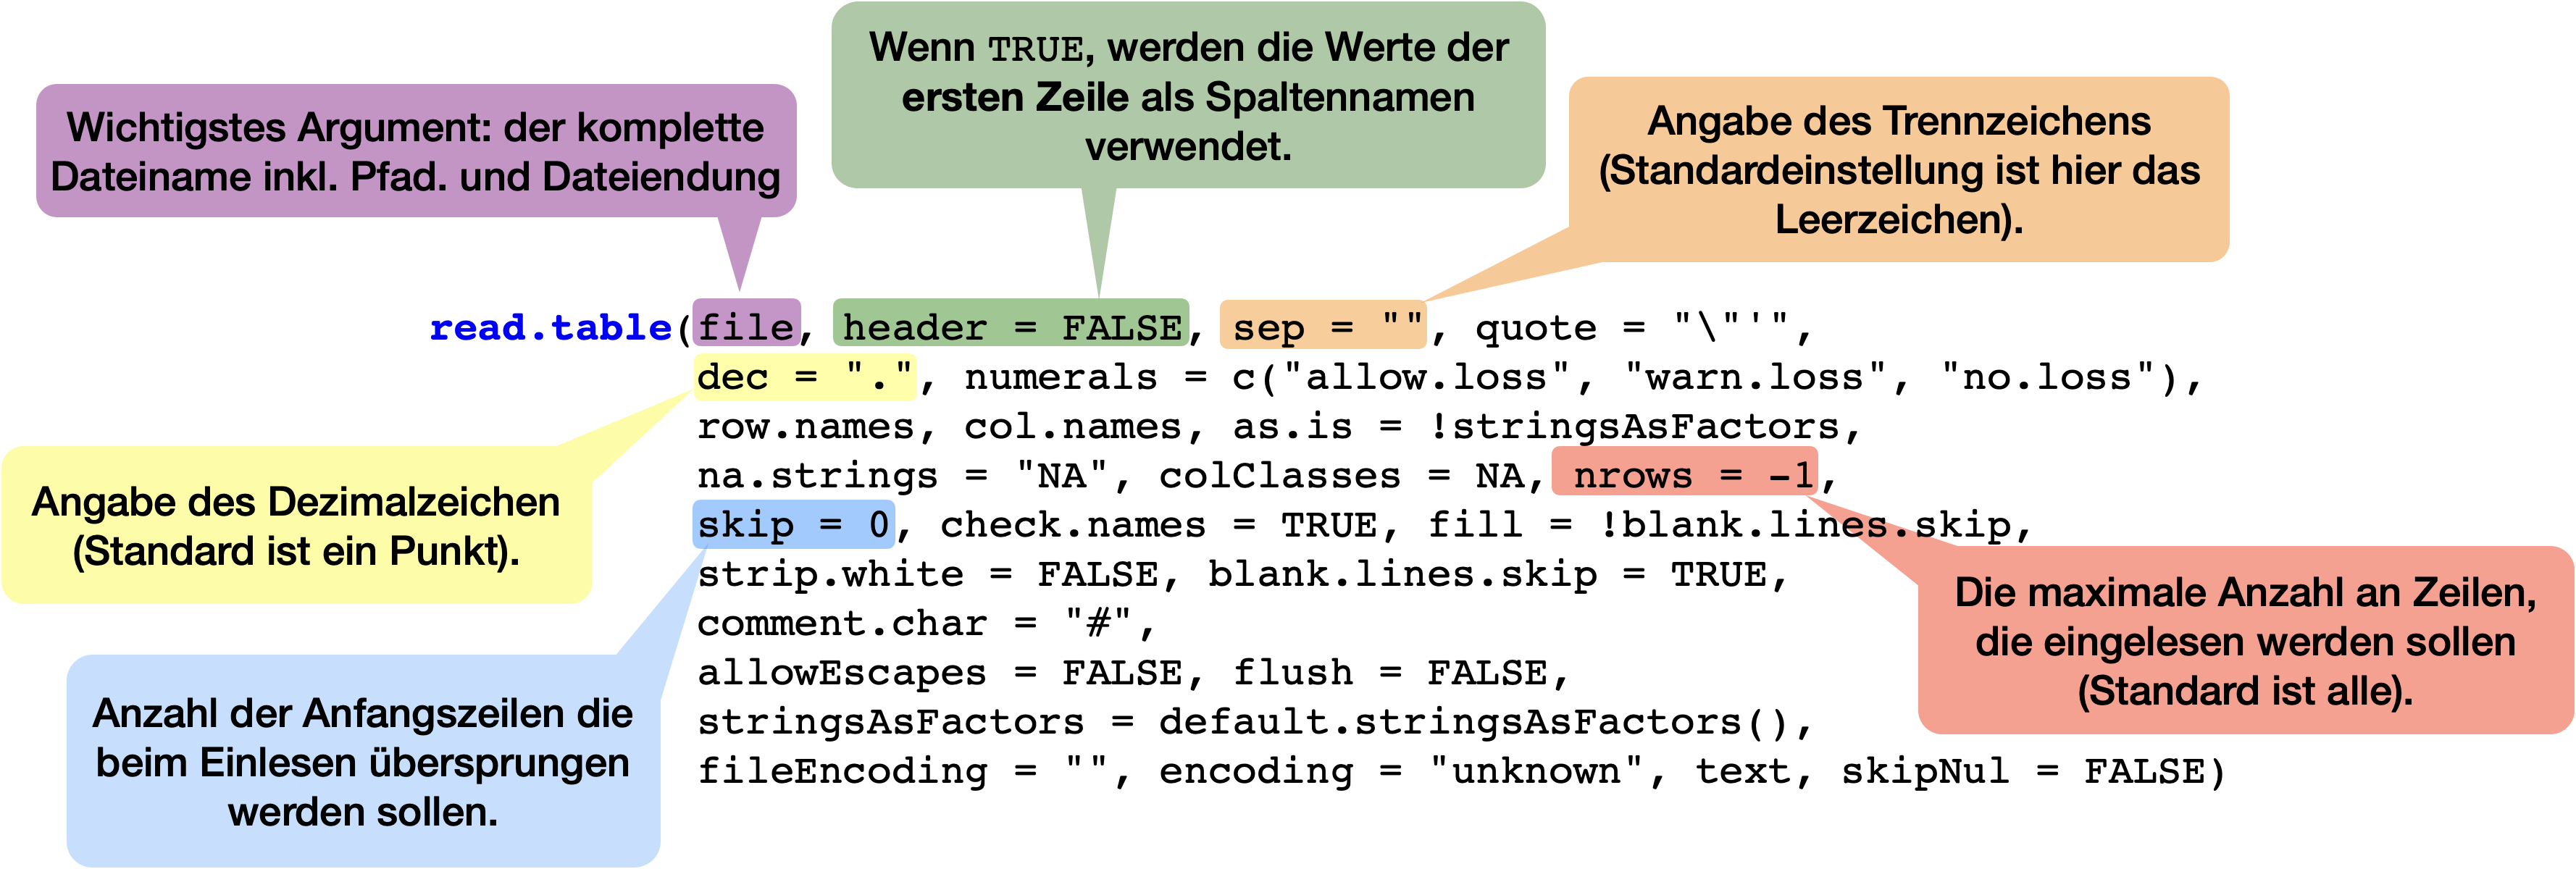
read.table()→ Liest eine Datei im Tabellenformat ein und erstellt daraus einen Dataframe:

read.csv():CSV-Datei importieren
# Datei ist im Arbeitsverzeichnis
kabeljau <- read.csv(file = "Wachstum-Futter.csv")
# Alternativ: Angabe des Dateipfads
kabeljau <- read.csv(file = "Pfad/zur/Datei/Wachstum-Futter.csv")str(), head()/tail(), View() und summary():Import prüfen
str(kabeljau) # Dimensionen und Datentyp'data.frame': 11 obs. of 2 variables:
$ Verzehr : num 1868 140 256 719 1714 ...
$ Wachstum: num 482.2 -90.5 -40.3 236 512.7 ...head(kabeljau) # Teilinhalt Verzehr Wachstum
1 1868.0 482.2
2 140.3 -90.5
3 255.6 -40.3
4 718.8 236.0
5 1714.4 512.7
6 1149.1 296.6# View(kabeljau) # kompletter Inhalt
summary(kabeljau) # deskriptive Statistik -> komische Extremwerte? Verzehr Wachstum
Min. : 140.3 Min. :-90.50
1st Qu.: 323.8 1st Qu.:-15.05
Median : 718.8 Median :198.00
Mean : 856.2 Mean :180.02
3rd Qu.:1323.5 3rd Qu.:349.80
Max. :1868.0 Max. :512.70 Wenn Sie Ihre Daten exportieren wollen, um sie dann mit anderen Programmen zu bearbeiten, verwenden Sie am besten das gleiche Format wie beim Import.
Die meisten Importfunktionen haben ein Äquivalent zum Exportieren:
write.table(), write.csv(), write.csv2()
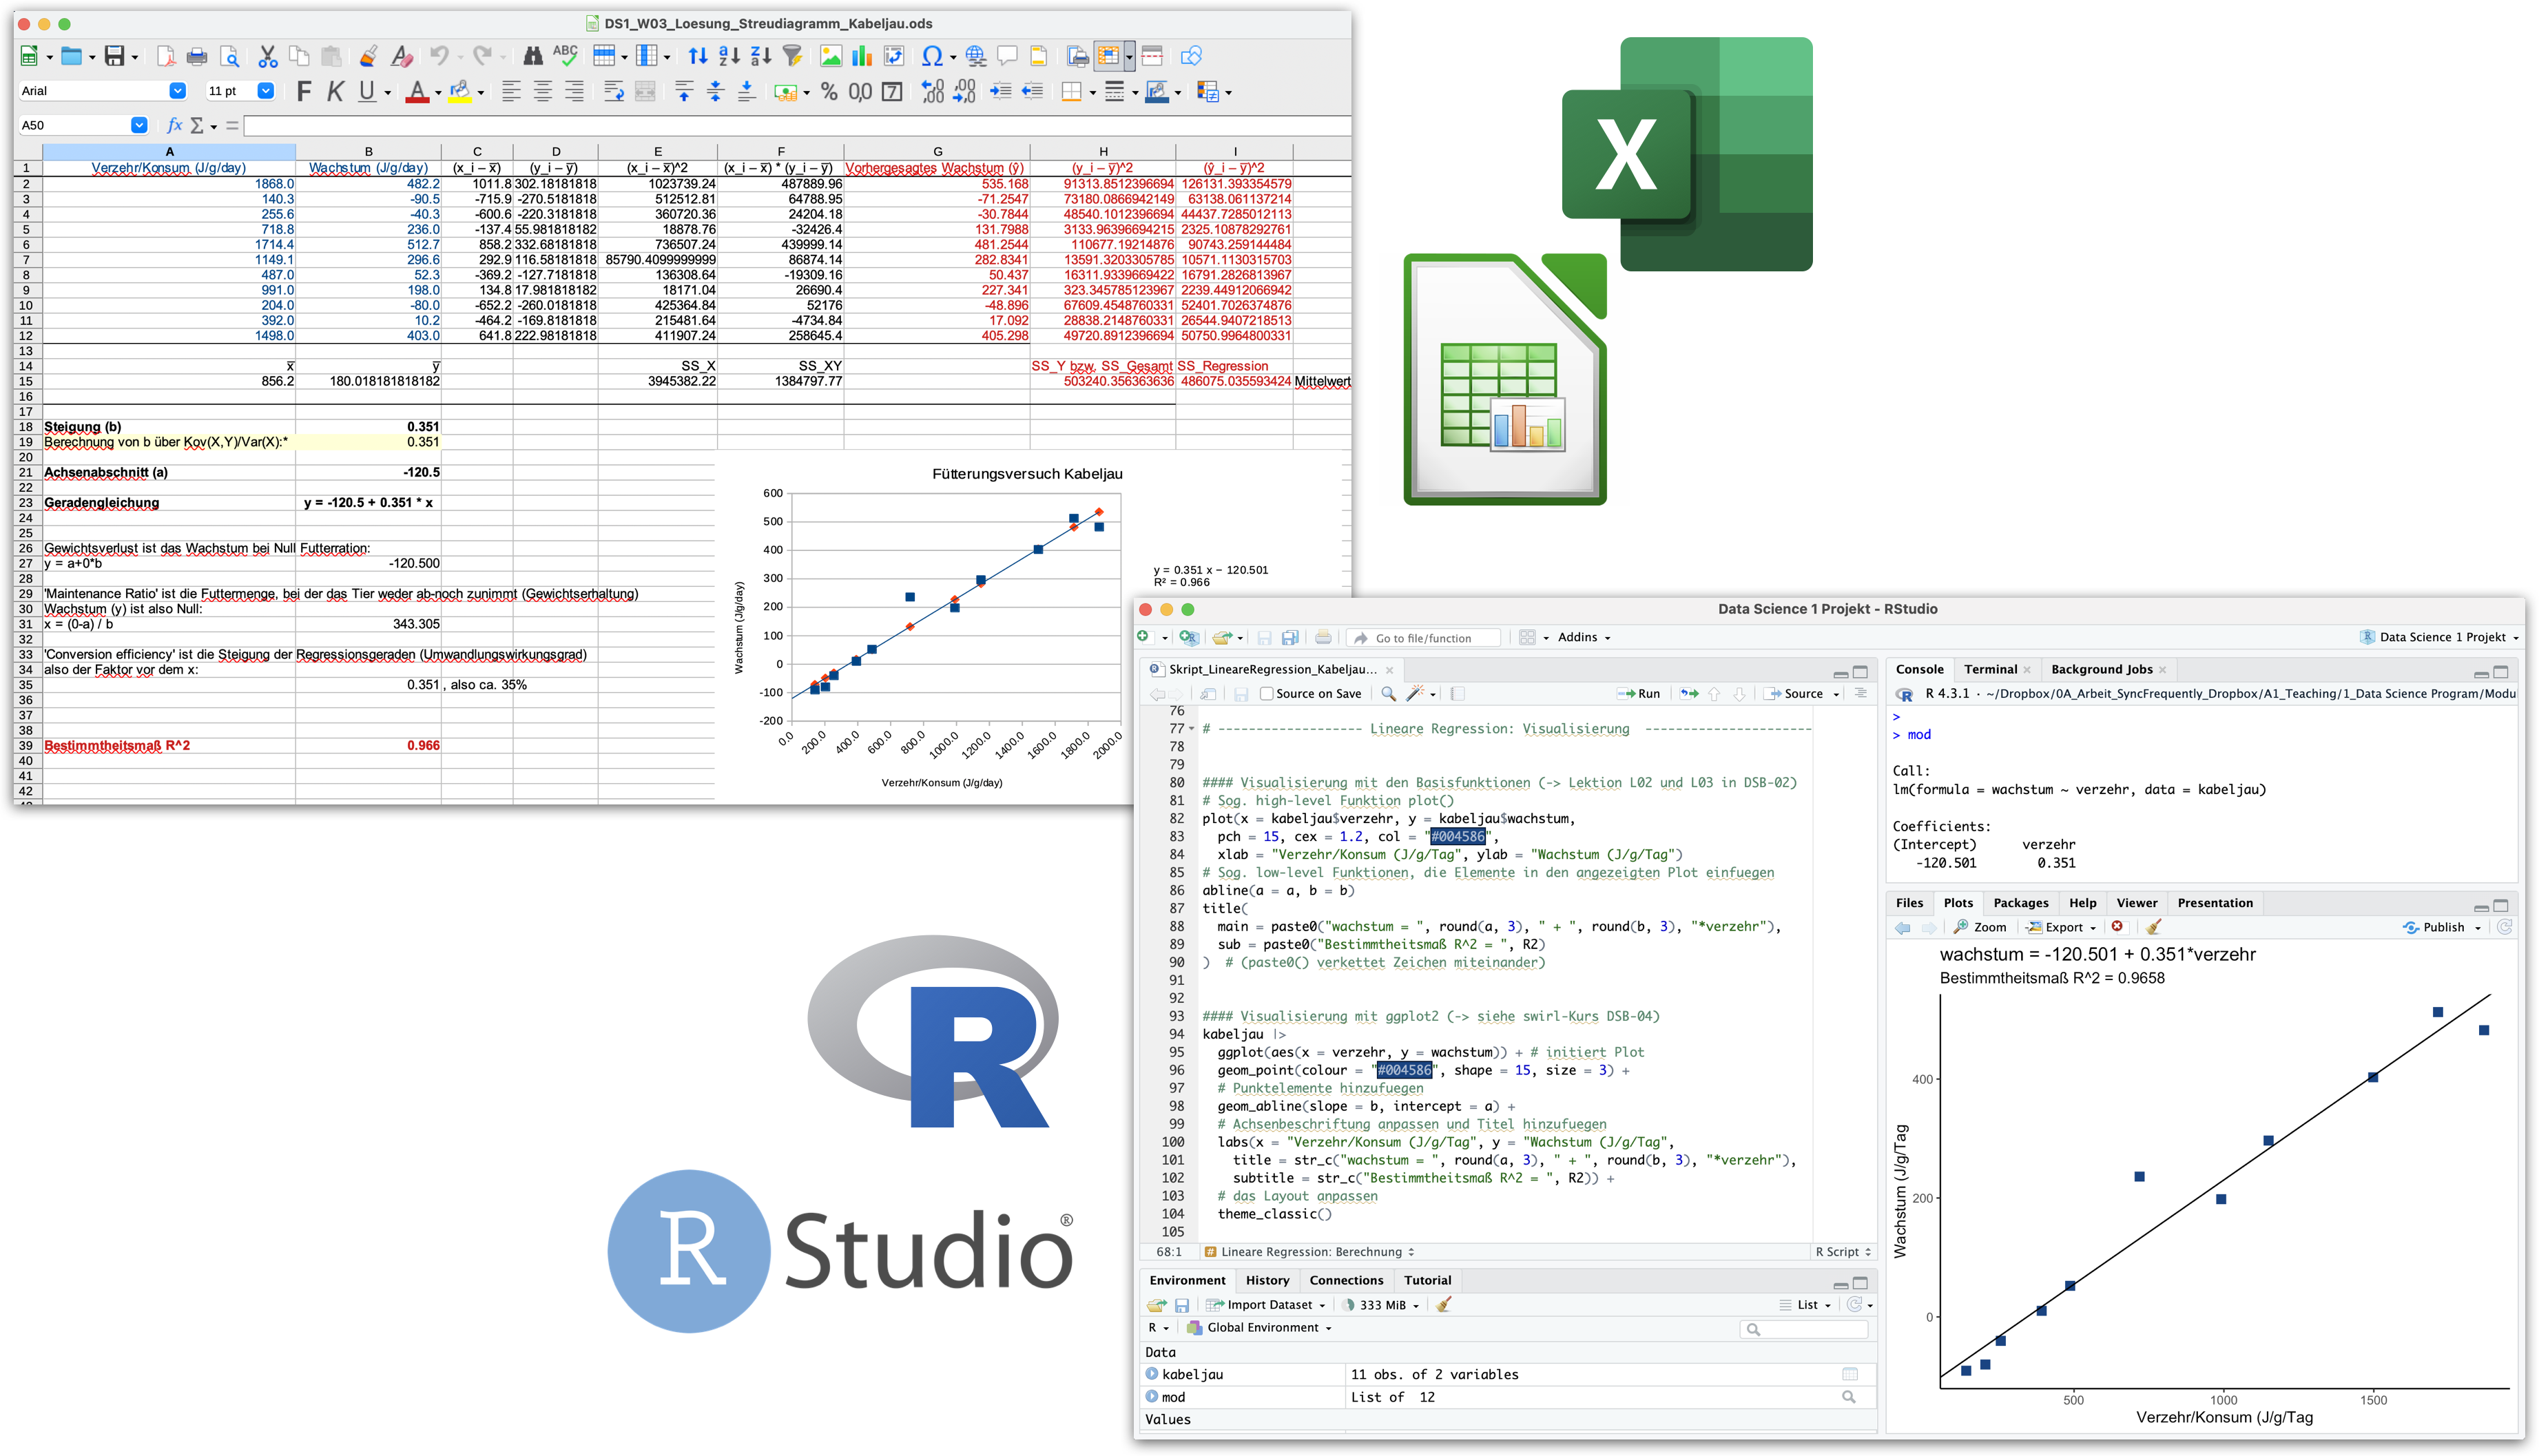
Was haben wir gerade gelernt?
# ------------------------------ Vorbereitung ----------------------------------

#### Laden von Paketen
library(tidyverse)
# library(readODS)
# library(readxl)
library(DSBtools)
options(DSBtools.language = "de") # Ausgabe auf Deutsch


#### Eigene Funktionen


# -------------------- Import und Datenaufbereitung ----------------------------

#### Import einer Textdatei im CSV-Format (das gängigste Format)
kabeljau_csv <- read.csv(file = "data/Wachstum-Futter.csv")
str(kabeljau_csv) # --> Output ist ein data frame


#### Import von Calc- und Excel-Dateien (ODS- und XLSX-Format)

# Import einer ODS-Datei mit dem 'readODS' Paket
kabeljau <- readODS::read_ods("data/DS1_W03_Streudiagramm_Kabeljau.ods",
  sheet = "Daten_Visualisierung")
str(kabeljau) # --> Output ist ein Tibble

# Import einer XLSX-Datei mit z.B. dem 'readxl' Paket
kabeljau_xlsx <- readxl::read_excel("data/DS1_W03_Streudiagramm_Kabeljau.xlsx",
  sheet = "Daten_Visualisierung")
str(kabeljau_xlsx) # --> Output ist ein Tibble


#### Datensichtung und -transformation

# Anpassen der Spaltennamen
names(kabeljau) <- c("verzehr", "wachstum")
str(kabeljau)

# Wertebereich prüfen
summary(kabeljau)

# Beziehung explorieren: Ist sie linear? Gibt es Ausreisser?
explore_var(x = kabeljau$verzehr, y = kabeljau$wachstum,
  xlab = "Verzehr/Konsum (J/g/Tag)", ylab = "Wachstum (J/g/Tag)")


# ---------------------- Lineare Regression: Berechnung ------------------------
# (-> Lektion L03 in DSB-02-Datenexploration mit R)

#### Manuelle Berechnung

# Um Tipparbeit zu sparen, speichern wir die Spalten als einzelne Vektoren
x <- kabeljau$verzehr
y <- kabeljau$wachstum

# Steigungsparameter b berechnen
b <- cov(x = x, y = y)/ var(x) # der shortcut mit der Kovarianz und Varianz
b

# Achsenabschnitt a berechnen
a <- mean(y) - b*mean(x)
a

# Das Bestimmtheitsmass R^2 berechnen
y_pred <- a + b*x   # die vorhergesagten Werte
ss_gesamt <- sum( (y - mean(y))^2 ) # Summenquadrate Gesamt
ss_regression <- sum( (y_pred - mean(y))^2 ) # Summenquadrate der Regression
R2 <- round(ss_regression/ss_gesamt, 4)
R2


##### Zum Vergleich die Regression automatisch berechnen mit lm()

# Erstellung des Modells
mod <- lm(formula = wachstum ~ verzehr, data = kabeljau)
mod

# Ausgabe nur der beiden Koeffizienten
coef(mod)

# Ausgabe aller wichtigen Statistiken des Modells, inklusive von R^2
# (mehr dazu in Data Science 2)
summary(mod)


# ------------------- Lineare Regression: Visualisierung  ----------------------


#### Visualisierung mit den Basisfunktionen (-> Lektion L02 und L03 in DSB-02)
# Sog. high-level Funktion plot()
plot(x = kabeljau$verzehr, y = kabeljau$wachstum,
  pch = 15, cex = 1.2, col = "#004586",
  xlab = "Verzehr/Konsum (J/g/Tag)", ylab = "Wachstum (J/g/Tag)")
# Sog. low-level Funktionen, die Elemente in den angezeigten Plot einfügen
abline(a = a, b = b)
title(
  main = paste0("wachstum = ", round(a, 3), " + ", round(b, 3), "*verzehr"),
  sub = paste0("Bestimmtheitsmaß R^2 = ", R2)
)  # (paste0() verkettet Zeichen miteinander)


#### Visualisierung mit ggplot2 (-> siehe swirl-Kurs DSB-04)
kabeljau |>
  ggplot(aes(x = verzehr, y = wachstum)) + # initiert Plot
  geom_point(colour = "#004586", shape = 15, size = 3) +
  # Punktelemente hinzufügen
  geom_abline(slope = b, intercept = a) +
  # Achsenbeschriftung anpassen und Titel hinzufügen
  labs(x = "Verzehr/Konsum (J/g/Tag)", y = "Wachstum (J/g/Tag)",
    title = str_c("wachstum = ", round(a, 3), " + ", round(b, 3), "*verzehr"),
    subtitle = str_c("Bestimmtheitsmaß R^2 = ", R2)) +
  # das Layout anpassen
  theme_bw()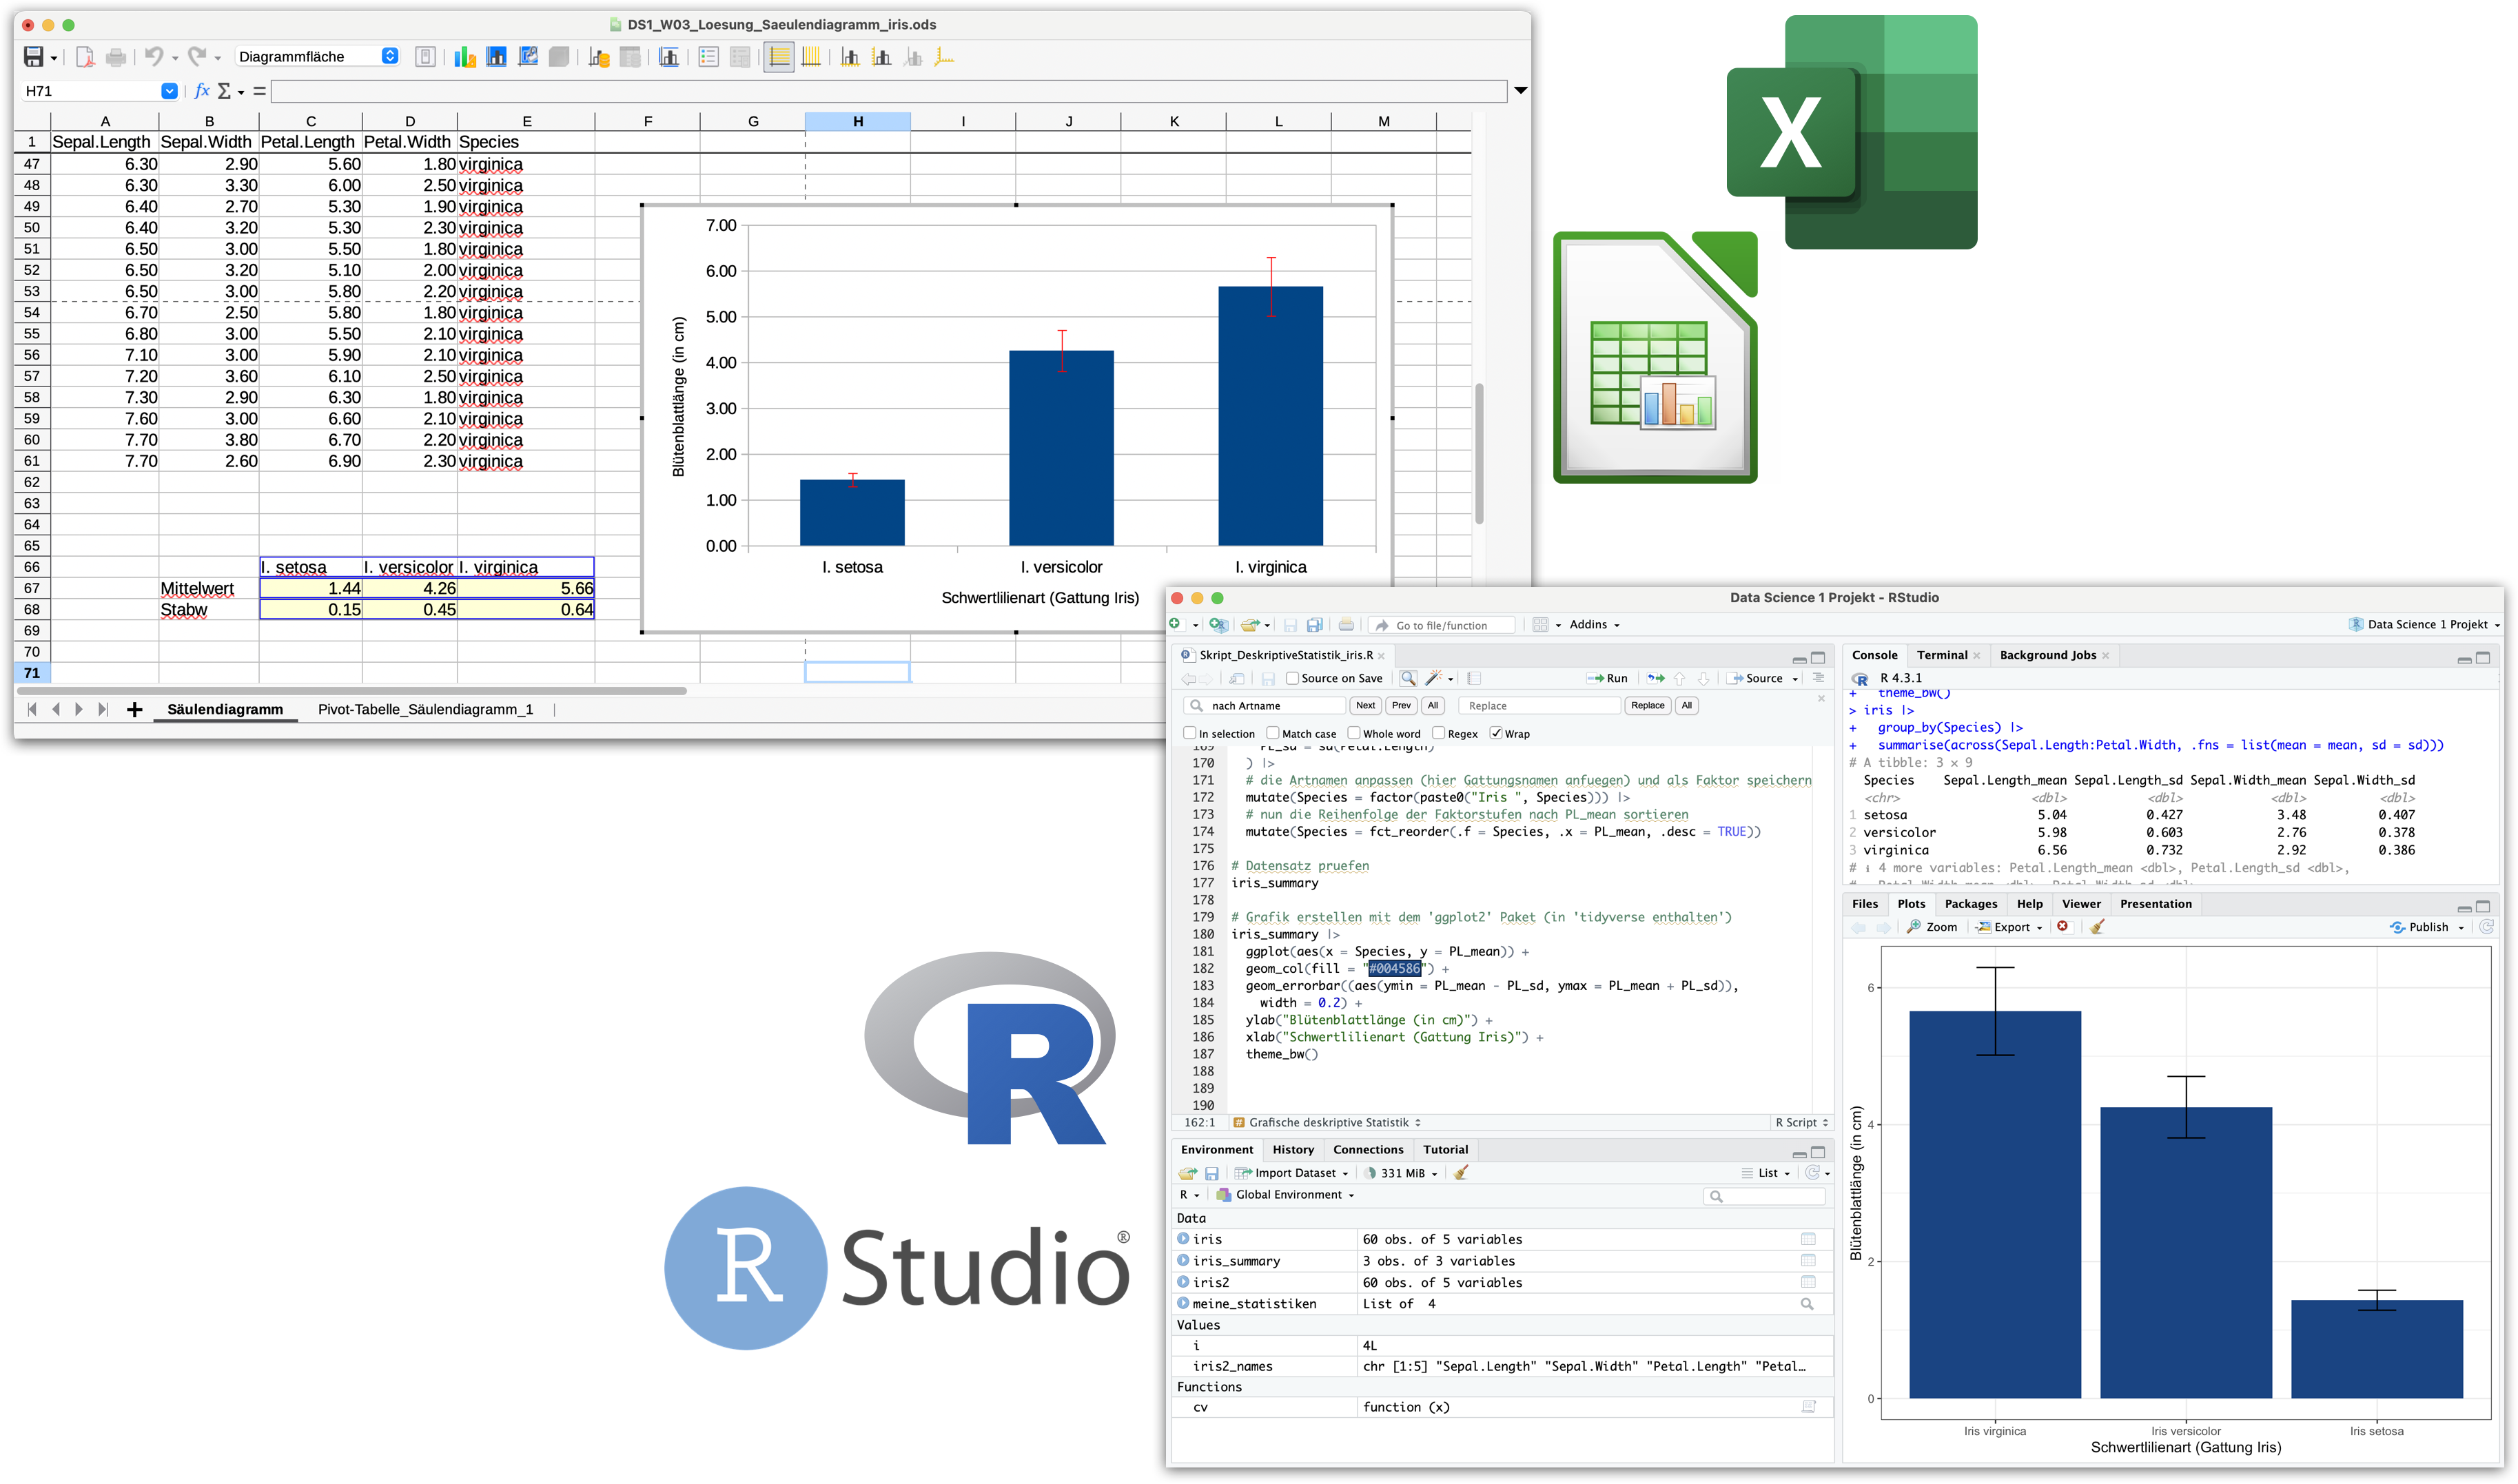
Was haben wir gerade gelernt?
# ------------------------------ Vorbereitung ----------------------------------

#### Laden von Paketen
library(tidyverse) # laedt 9 Pakete

# # (das gleiche wie alle Pakete einzeln zu laden)
# library(dplyr)
# library(forcats)
# library(ggplot2)
# library(lubridate)
# library(purrr)
# library(readr)
# library(stringr)
# library(tibble)
# library(tidyr)

library(DSBtools)
options(DSBtools.language = "de") # Ausgabe auf Deutsch


#### Eigene Funktionen
# Variantionskoeffizient
cv <- function(x) {
  sd(x)/mean(x)
}


# -------------------- Import und Datenaufbereitung ----------------------------

#### Import von CSV-Dateien
# (-> Swirl-Lektion L01 in DSB-03-Datenaufbereitung oder per Anleitung durchs Tidyversum)

# Import der ODS-Datei, welche in den Zeilen 66-68 noch Text enthaelt
iris <- readODS::read_ods("data/DS1_W03_Saeulendiagramm_mit_iris.ods")


#### Prüfung des Imports und Datensichtung
# (-> Swirl-Lektion L02 in DSB-03)

# Prüfung des Datentyps --> IMMER DIREKT NACH DEM IMPORT VERWENDEN!
str(iris)  # str = structure

# Betrachtung des Inhalts
iris
# View(iris)

# Korrektur des Datentyps und der Zeilen
iris <- iris[1:60, ] |>
  mutate(across(Sepal.Length:Petal.Width, as.numeric)) |>
  mutate(Species = as.factor(Species))
str(iris)

# Welche Werte kommen in jeder Spalte vor?
lapply(iris, unique)

### Weitere Funktionen zur Sichtung einzelner Aspekte
head(iris) # zeigt erste 6 Zeilen (Kopfzeilen)
tail(iris) # zeigt letzte 6 Zeilen (Endzeilen)
class(iris) # Identifikation der Objektklasse (Vektor, Matrix, dataframe,..)
nrow(iris) # Anzahl Zeilen
ncol(iris) # Anzahl Spalten
dim(iris) # Anzahl aller Dimensionen
names(iris) # Spaltennamen
typeof(iris$Sepal.Length) # Datentyp von Spalte 'Sepal.Length'
typeof(iris$Species)      # Datentyp von Spalte 'Species'


# ----------------------- Deskriptive Statistik --------------------------------

#### Berechnung mehrerer Statistiken für jede Spalte im data frame

# Klassische Zusammenfassung mit base R (Ausgabe nur in der Konsole)
summary(iris)

# Shortcut mit DSBtools: Statistiken für jede Spalte, passend zum erkannten
# Variablentyp (z.B. Häufigkeiten bei 'Species', Mittelwert & Co. bei den
# metrischen Spalten). Das Ergebnis ist ein Objekt, mit dem Sie weiterarbeiten
# können - speichern Sie es dazu unter einem Namen:
describe_df(data = iris)


#### Berechnung versch. Statistiken der Kronblattlaenge, gruppiert nach Art
# (-> Lektion L01 in DSB-02-Datenexploration mit R)
# (-> Lektion L06-Gruppierte Aggregation in DSB-03)

iris_summary <- iris |>
  group_by(Species) |>
  summarise(
    PL_mean = mean(Petal.Length),                         # Mittelwert
    PL_median = median(Petal.Length),                     # Median
    PL_var = var(Petal.Length),                           # Varianz
    PL_sd = sd(Petal.Length),                             # Standardabweichung
    PL_se = sd(Petal.Length)/sqrt(length(Petal.Length)),  # Standardfehler
    PL_cv = cv(Petal.Length)                              # Variationskoeffizient
  ) |>
  # die Artnamen anpassen (hier Gattungsnamen anfügen) und als Faktor speichern
  mutate(Species = factor(paste0("Iris ", Species))) |>
  # nun die Reihenfolge der Faktorstufen nach PL_mean sortieren
  mutate(Species = fct_reorder(.f = Species, .x = PL_mean, .desc = TRUE))

# Zusammenfassung ansehen
iris_summary

# Kontrolle mit DSBtools: Stimmen Ihre Werte? describe_var() berechnet die
# Statistiken der Variable 'x' getrennt für jede Gruppe in 'by'
# (Angaben zum 95%-Konfidenzintervall -> kommt in Data Science 2)
iris_stats <- describe_var(x = iris$Petal.Length, by = iris$Species)
iris_stats


#### Saeulendiagramm erstellen mit dem 'ggplot2' Paket
#  (siehe auch swirl-Kurs DSB-04-Datenvisualisierung mit ggplot2)

iris_summary |>
  ggplot(aes(x = Species, y = PL_mean)) + # initiert Plot
  # die Saeulen hinzufügen
  geom_col(fill = "#004586") +
  # die Fehlerbalken hinzufügen
  geom_errorbar((aes(ymin = PL_mean - PL_sd, ymax = PL_mean + PL_sd)),
    width = 0.2) +
  # Achsenbeschriftung anpassen
  ylab("Kronblattlänge (in cm)") +
  xlab("Schwertlilienart (Gattung Iris)") +
  # das Layout anpassen
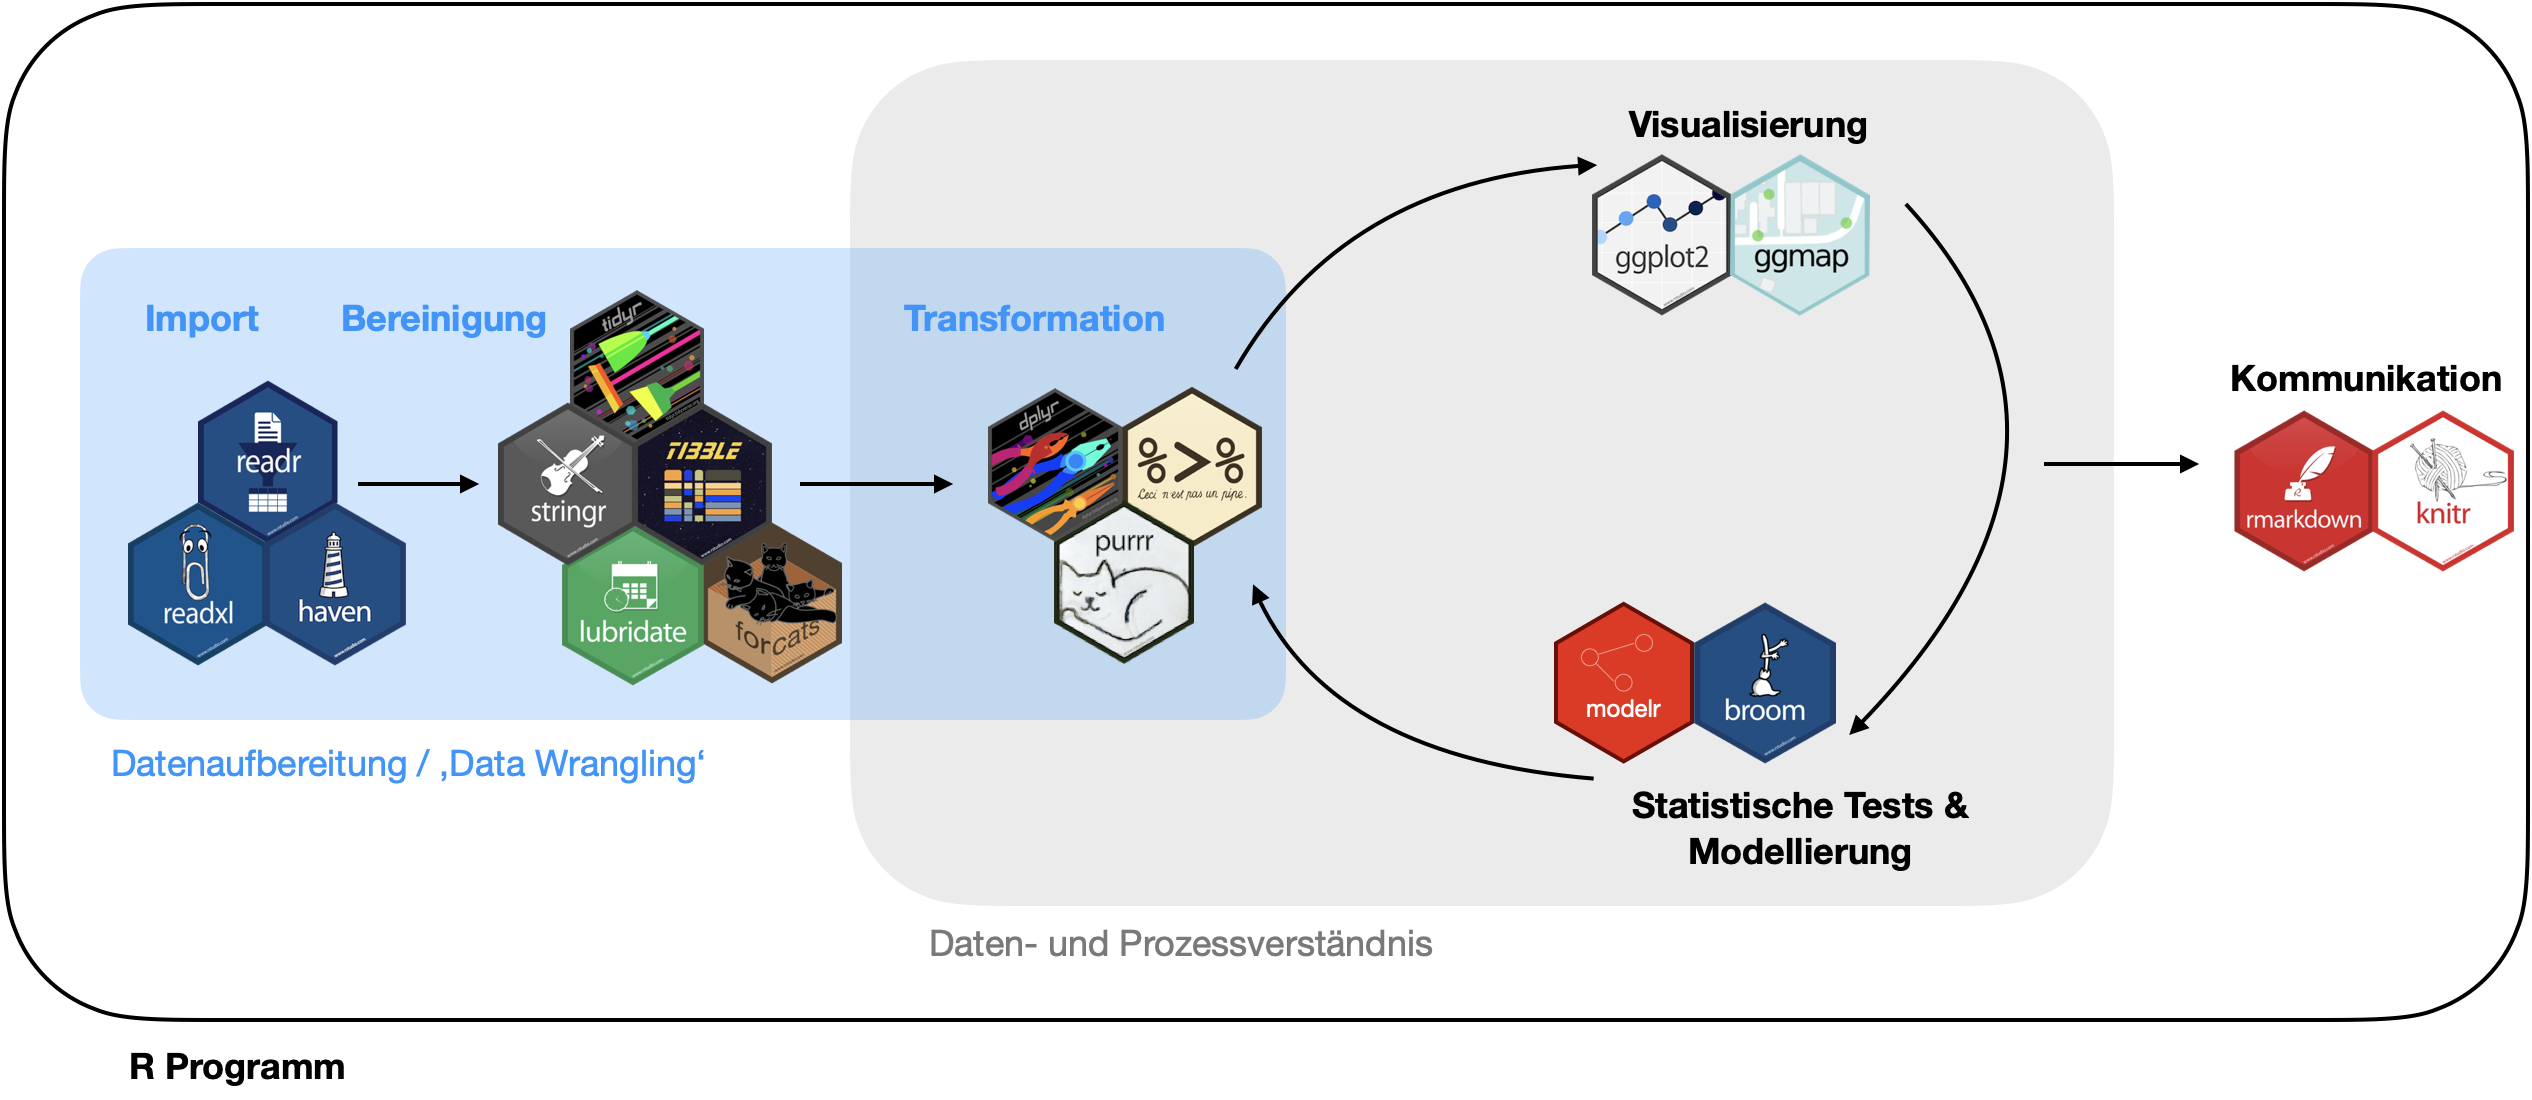
theme_bw()Ist eine Sammlung von R Paketen, die die gleiche Philosophie teilen und aufeinander abgestimmt sind:
Modifiziert von: R for Data Science von Wickham & Grolemund, 2017 (lizenziert unter CC-BY-NC-ND 3.0 US).
Wenn ein spezifisches Paket geladen wird, wird es als ‘default’ zum Suchpfad hinzugefügt:

Modifiziert von: Advanced R von H. Wickham, 2014
Sie können sich den Suchpfad explizit anzeigen lassen mit search().
Suchpfad einer frischen Sitzung
search() [1] ".GlobalEnv" "tools:rstudio" "package:stats"
[4] "package:graphics" "package:grDevices" "package:utils"
[7] "package:datasets" "package:methods" "Autoloads"
[10] "package:base" Beim Laden von tidyverse werden 9 weitere ‘tidyverse’ Pakete mit geladen (es wird dabei auch ein Konflikt mit Funktionsnamen angezeigt - filter() und lag() existieren in 2 Paketen):
tidyverse laden
library(tidyverse)── Attaching core tidyverse packages ──────────────── tidyverse 2.0.0 ──
✔ dplyr 1.1.4 ✔ readr 2.1.6
✔ forcats 1.0.1 ✔ stringr 1.6.0
✔ ggplot2 4.0.1 ✔ tibble 3.3.1
✔ lubridate 1.9.4 ✔ tidyr 1.3.2
✔ purrr 1.2.1
── Conflicts ────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag() masks stats::lag()
ℹ Use the conflicted package to force all conflicts to become errors(Die Versionsnummern können bei Ihnen abweichen.)
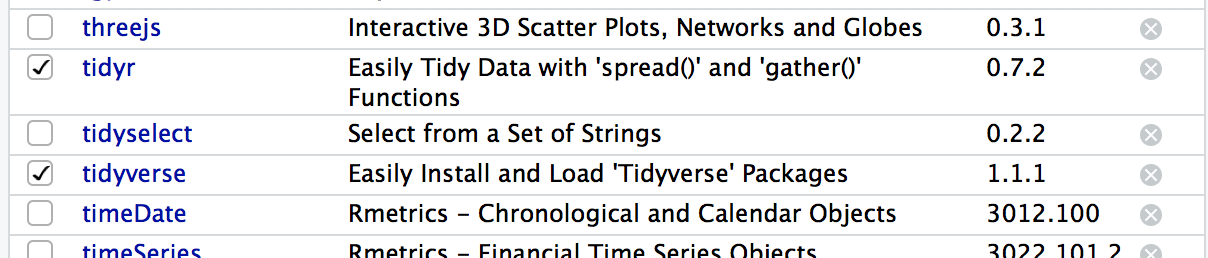
Pakete werden aus dem Suchpfad mit detach() entfernt - dabei muss package: vor den Paketnamen gesetzt werden:
Paket entfernen
detach("package:dplyr")Oder indem die Box neben dem Paketnamen im ‘Packages’ Fenster entfernt wird:

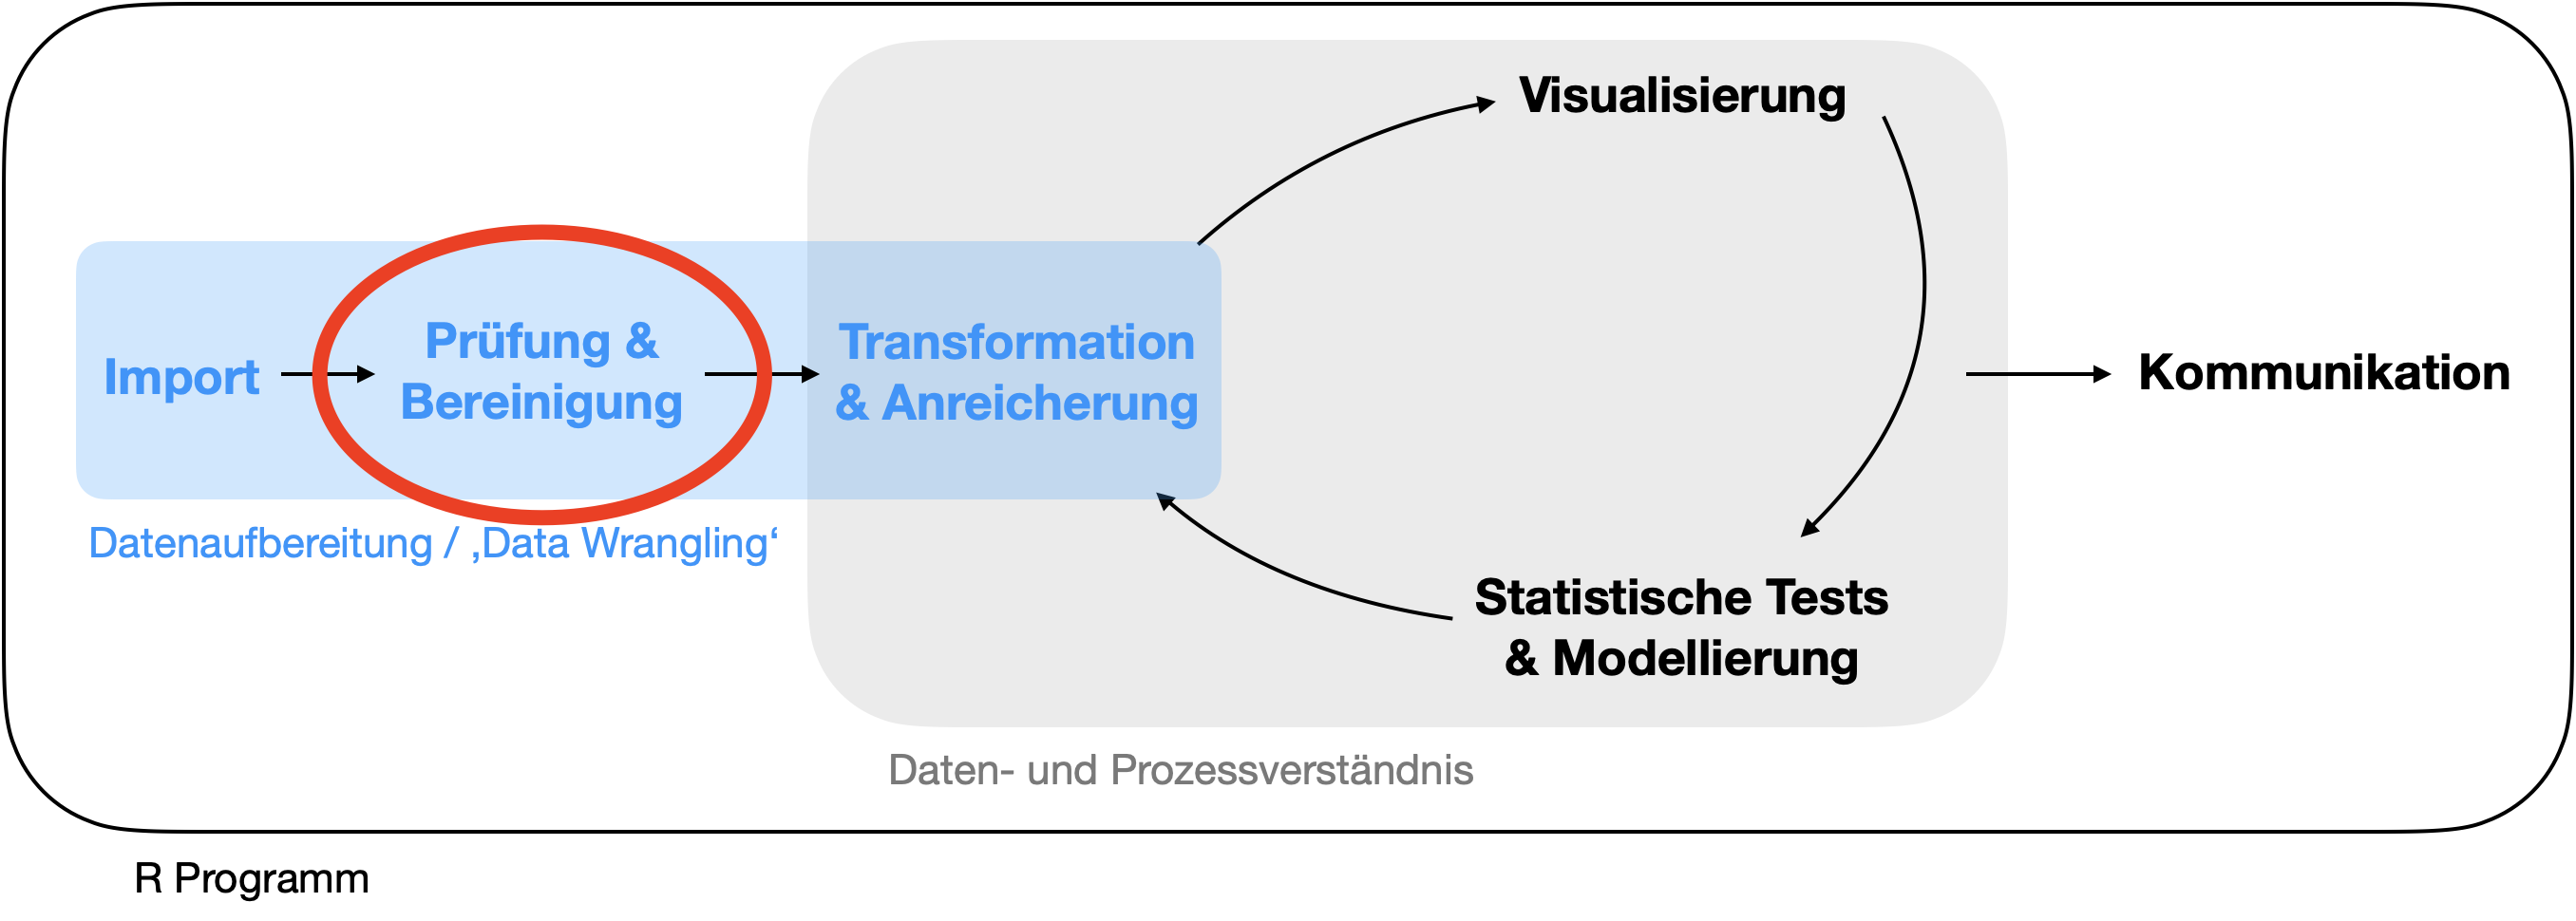
tidyr::drop_na(data, ...): Entfernt alle Zeilen, die fehlende Werte enthalten. tidyr::fill(data, ..., .direction = c("down", "up")): Füllt fehlende Werte mit den vorherigen (direction = “down”) oder nachfolgenden (direction = “up”) Einträgen auf. tidyr::replace_na(data, replace = list(), ...): Ersetzt fehlende Werte mit einem spezifischen Wert für jede Spalte.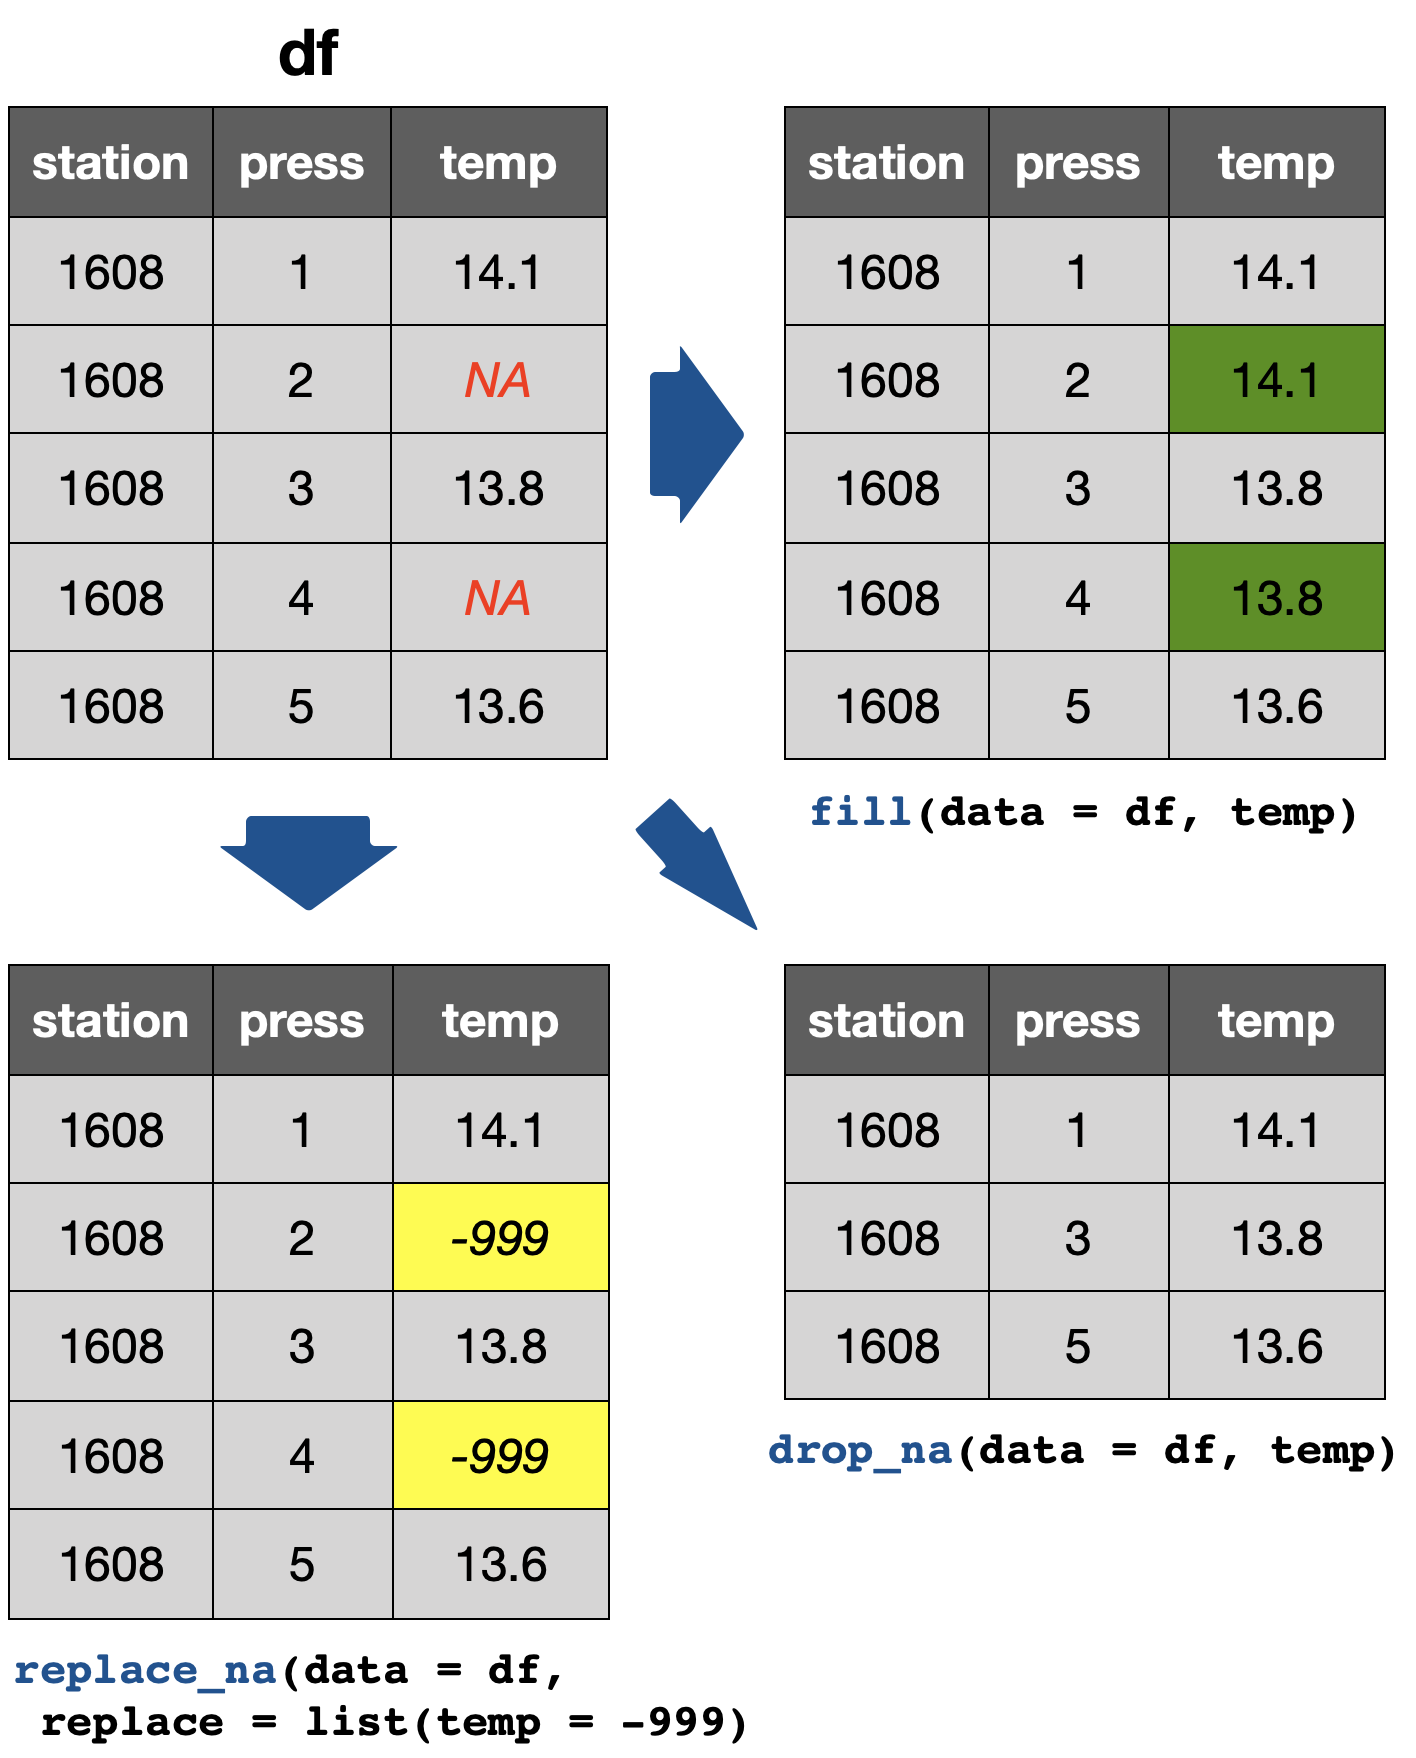

Gegeben sind folgende hydrografische Messungen der Ostsee-Station 1321 vom August 2015:
sample1 station lat long depth pres temp psal doxy
1 1321 55 13.3 47 0.2 17.93 8.167 NA
2 1321 55 13.3 47 1.0 NA NA NA
3 1321 55 13.3 47 5.0 NA 8.328 4.60
4 1321 55 13.3 47 10.0 17.49 8.349 4.50
5 1321 55 13.3 47 15.0 17.44 NA 4.50
6 1321 55 13.3 47 20.0 17.04 8.340 4.50
7 1321 55 13.3 47 25.0 NA 8.303 4.60
8 1321 55 13.3 47 30.0 15.56 NA 4.60
9 1321 55 13.3 47 35.0 11.29 7.915 4.78
10 1321 55 13.3 47 40.0 NA 8.417 NA
11 1321 55 13.3 47 45.0 11.19 NA NApres = Druck, temp = Temperatur, psal = Salinität, doxy = gelöster Sauerstoff
sample1_mod1 <- drop_na(sample1, psal)
sample1_mod1[ ,5:8]
pres temp psal doxy
1 0.2 17.93 8.167 NA
2 5.0 NA 8.328 4.60
3 10.0 17.49 8.349 4.50
4 20.0 17.04 8.340 4.50
5 25.0 NA 8.303 4.60
6 35.0 11.29 7.915 4.78
7 40.0 NA 8.417 NAsample1_mod2 <- fill(sample1, temp:doxy, .direction = 'downup')
sample1_mod2[ ,5:8] pres temp psal doxy
1 0.2 17.93 8.167 4.60
2 1.0 17.93 8.167 4.60
3 5.0 17.93 8.328 4.60
4 10.0 17.49 8.349 4.50
5 15.0 17.44 8.349 4.50
6 20.0 17.04 8.340 4.50
7 25.0 17.04 8.303 4.60
8 30.0 15.56 8.303 4.60
9 35.0 11.29 7.915 4.78
10 40.0 11.29 8.417 4.78
11 45.0 11.19 8.417 4.78sample1_mod3 <- replace_na(sample1, list(
temp = median(sample1$temp, na.rm = TRUE),
psal = median(sample1$psal, na.rm = TRUE),
doxy = median(sample1$doxy, na.rm = TRUE) )
)
sample1_mod3[ ,5:8] pres temp psal doxy
1 0.2 17.93 8.167 4.60
2 1.0 17.04 8.328 4.60
3 5.0 17.04 8.328 4.60
4 10.0 17.49 8.349 4.50
5 15.0 17.44 8.328 4.50
6 20.0 17.04 8.340 4.50
7 25.0 17.04 8.303 4.60
8 30.0 15.56 8.328 4.60
9 35.0 11.29 7.915 4.78
10 40.0 17.04 8.417 4.60
11 45.0 11.19 8.328 4.60
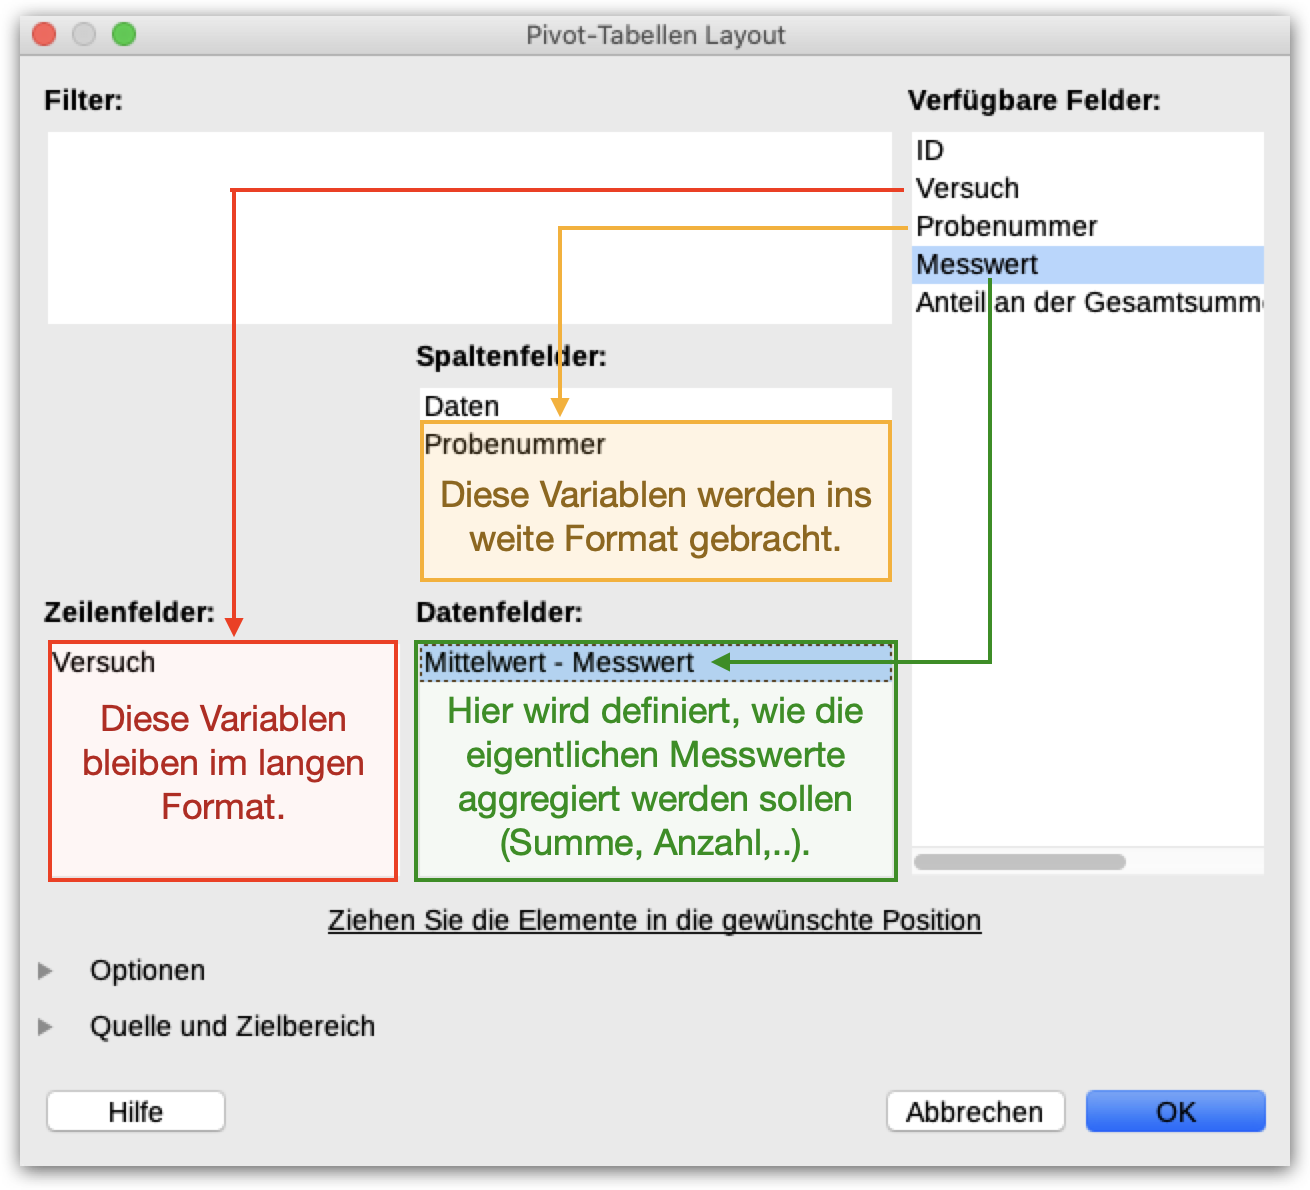
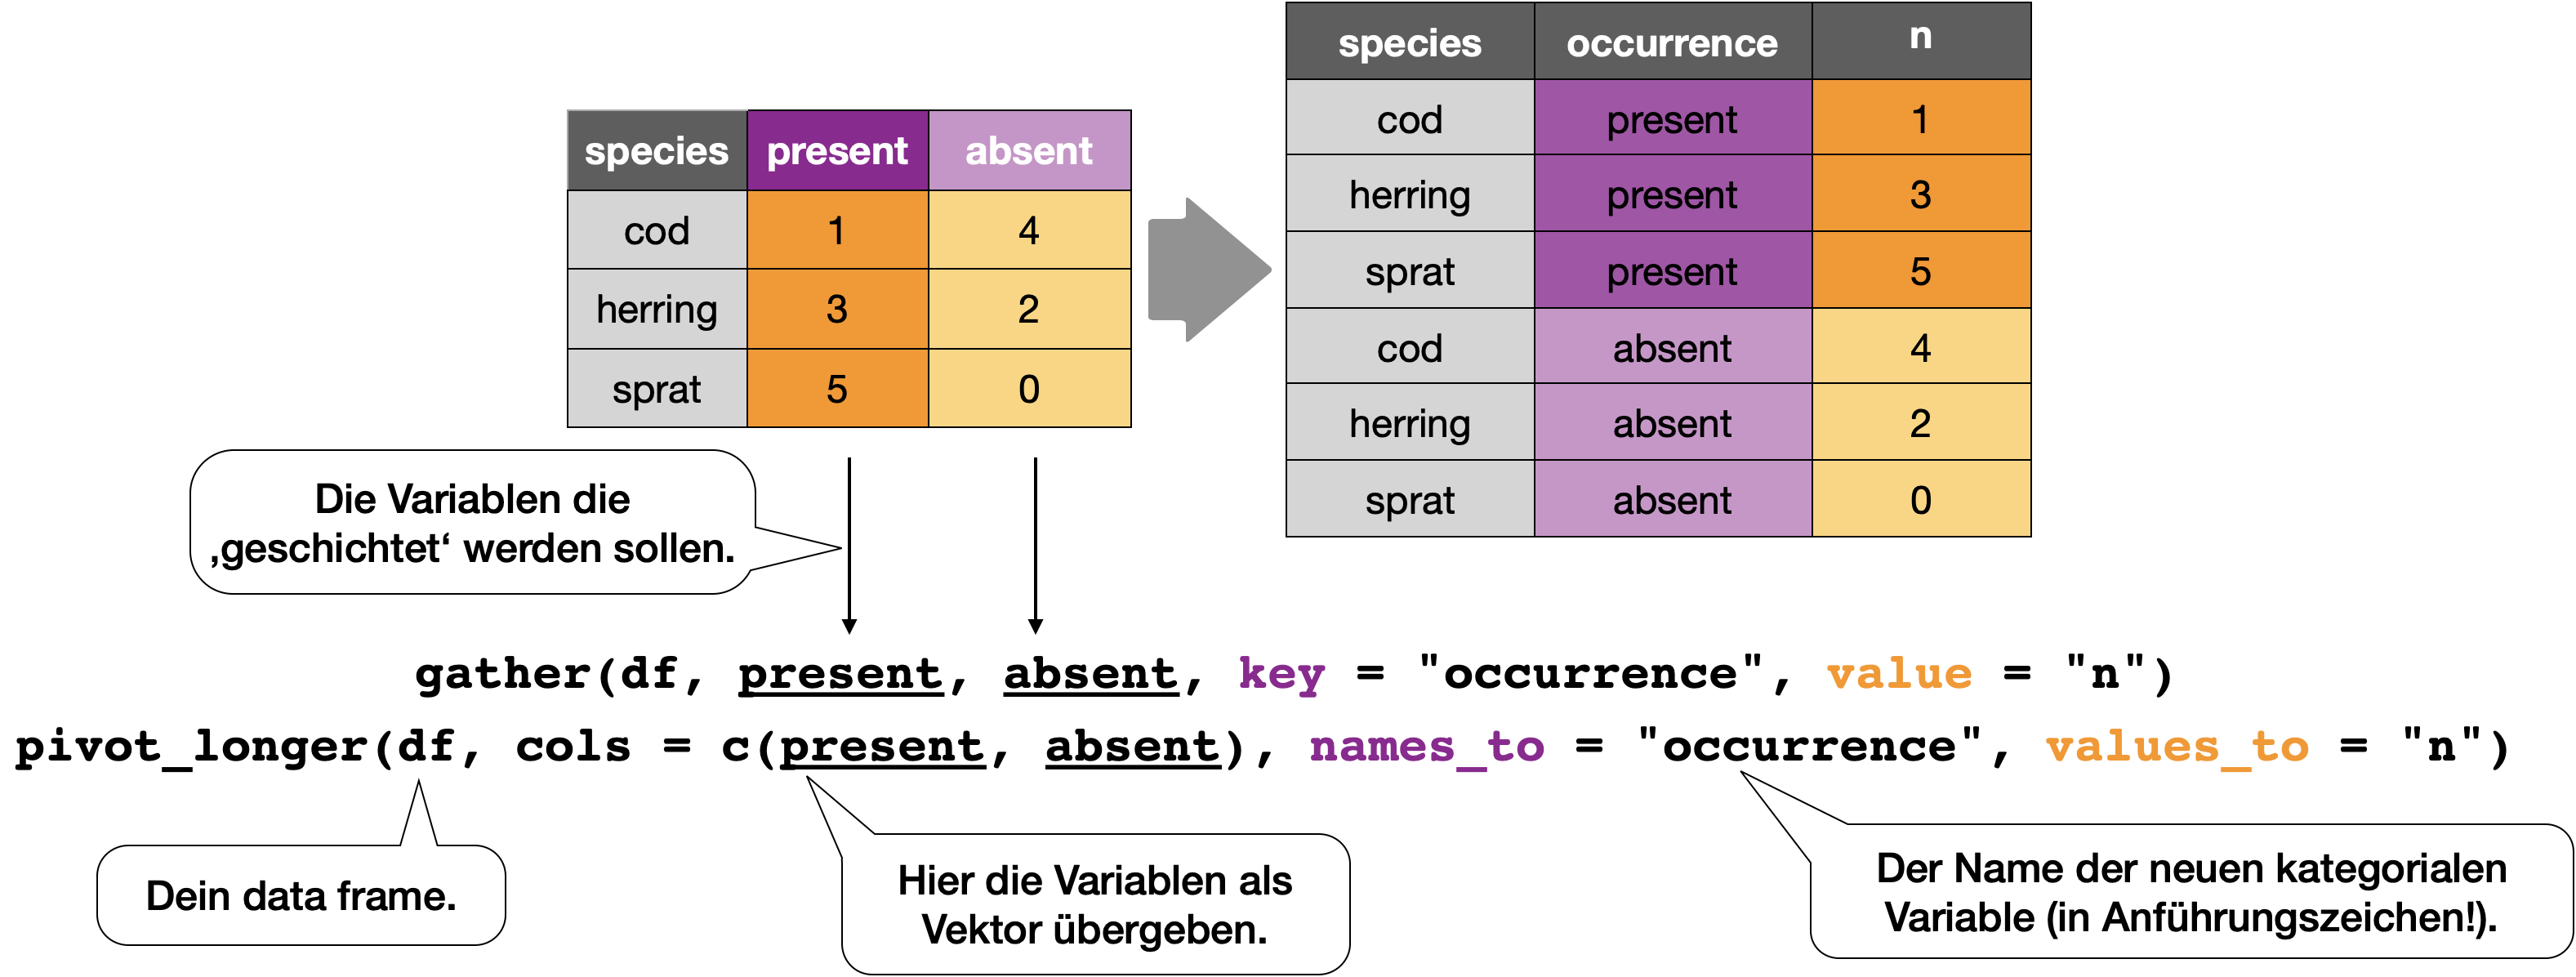
Das ‘tidyr’ Paket bietet zwei Funktionen für den Wechsel des Formats:
pivot_longer() (ehemals gather())pivot_wider() (ehemals spread())pivot_longer() → bewegt Spaltennamen in eine Schlüsselspalte und rafft die Werte der Spalten in eine einzelne Spalte zusammen.
irisVom weiten ins lange Format
iris_long <- pivot_longer(
  data = iris,
  cols = Sepal.Length:Petal.Width,
  names_to = "Leaf.Param",
  values_to = "Size"
)
Objektklasse prüfen
class(iris_long)[1] "tbl_df" "tbl" "data.frame"Aus dem Dataframe ist ein Tibble geworden - das machen alle tidyverse-Funktionen so (dazu gleich mehr).
Die ersten 12 Zeilen
print(iris_long, n = 12)# A tibble: 600 × 3
Species Leaf.Param Size
<fct> <chr> <dbl>
1 setosa Sepal.Length 5.1
2 setosa Sepal.Width 3.5
3 setosa Petal.Length 1.4
4 setosa Petal.Width 0.2
5 setosa Sepal.Length 4.9
6 setosa Sepal.Width 3
7 setosa Petal.Length 1.4
8 setosa Petal.Width 0.2
9 setosa Sepal.Length 4.7
10 setosa Sepal.Width 3.2
11 setosa Petal.Length 1.3
12 setosa Petal.Width 0.2
# ℹ 588 more rowsEin Panel pro Parameter
iris_long |>
  ggplot(aes(x = Species, y = Size)) +
  geom_boxplot() +
  facet_wrap(~Leaf.Param)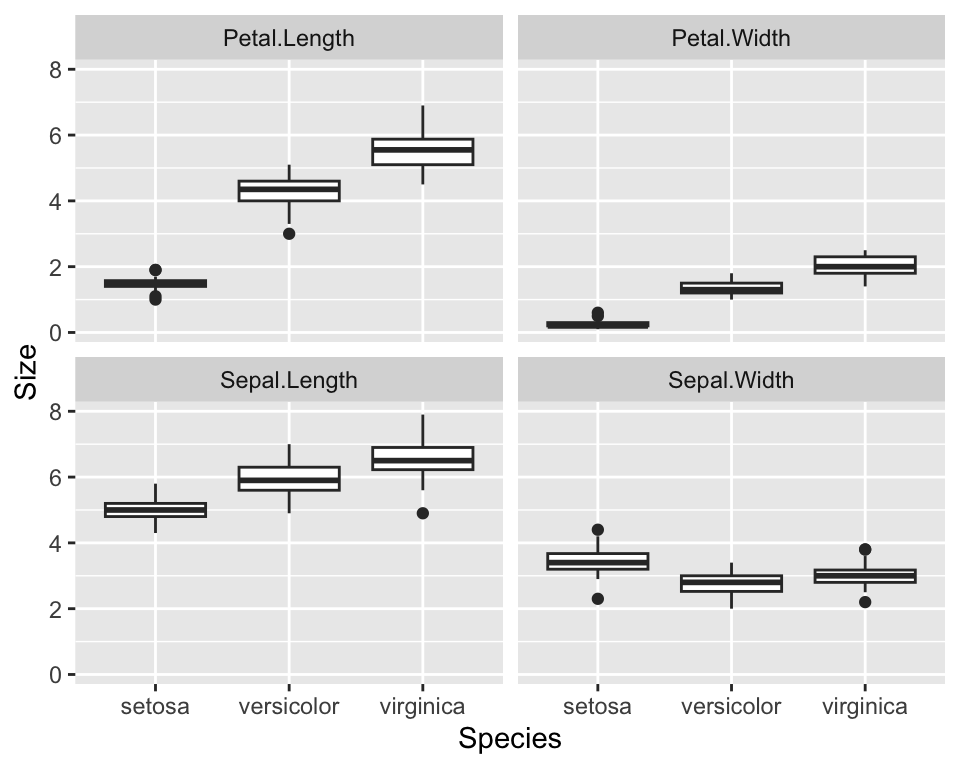
read_csv() & Co. (readr) sowie mit readODS oder readxlas_tibble():Dataframe umwandeln
iris_tbl <- as_tibble(iris)
class(iris)
[1] "data.frame"class(iris_tbl)[1] "tbl_df" "tbl" "data.frame"Ein ‘Tibble’ ist weiterhin ein ‘Dataframe’, hat aber zusätzlich die Klassen ‘tbl_df’ und ‘tbl’.
Standardmäßig zeigt ein ‘Tibble’ nur die ersten 10 Zeilen und alle Spalten, die in die Konsole passen. Mit print() lässt sich das ändern:
Zeilen (n) und Spalten (width) festlegen
print(iris_tbl, n = 2, width = Inf) # Inf = alle Spalten# A tibble: 150 × 5
Sepal.Length Sepal.Width Petal.Length Petal.Width Species
<dbl> <dbl> <dbl> <dbl> <fct>
1 5.1 3.5 1.4 0.2 setosa
2 4.9 3 1.4 0.2 setosa
# ℹ 148 more rowsMehr zu ‘Tibbles’: vignette("tibble")
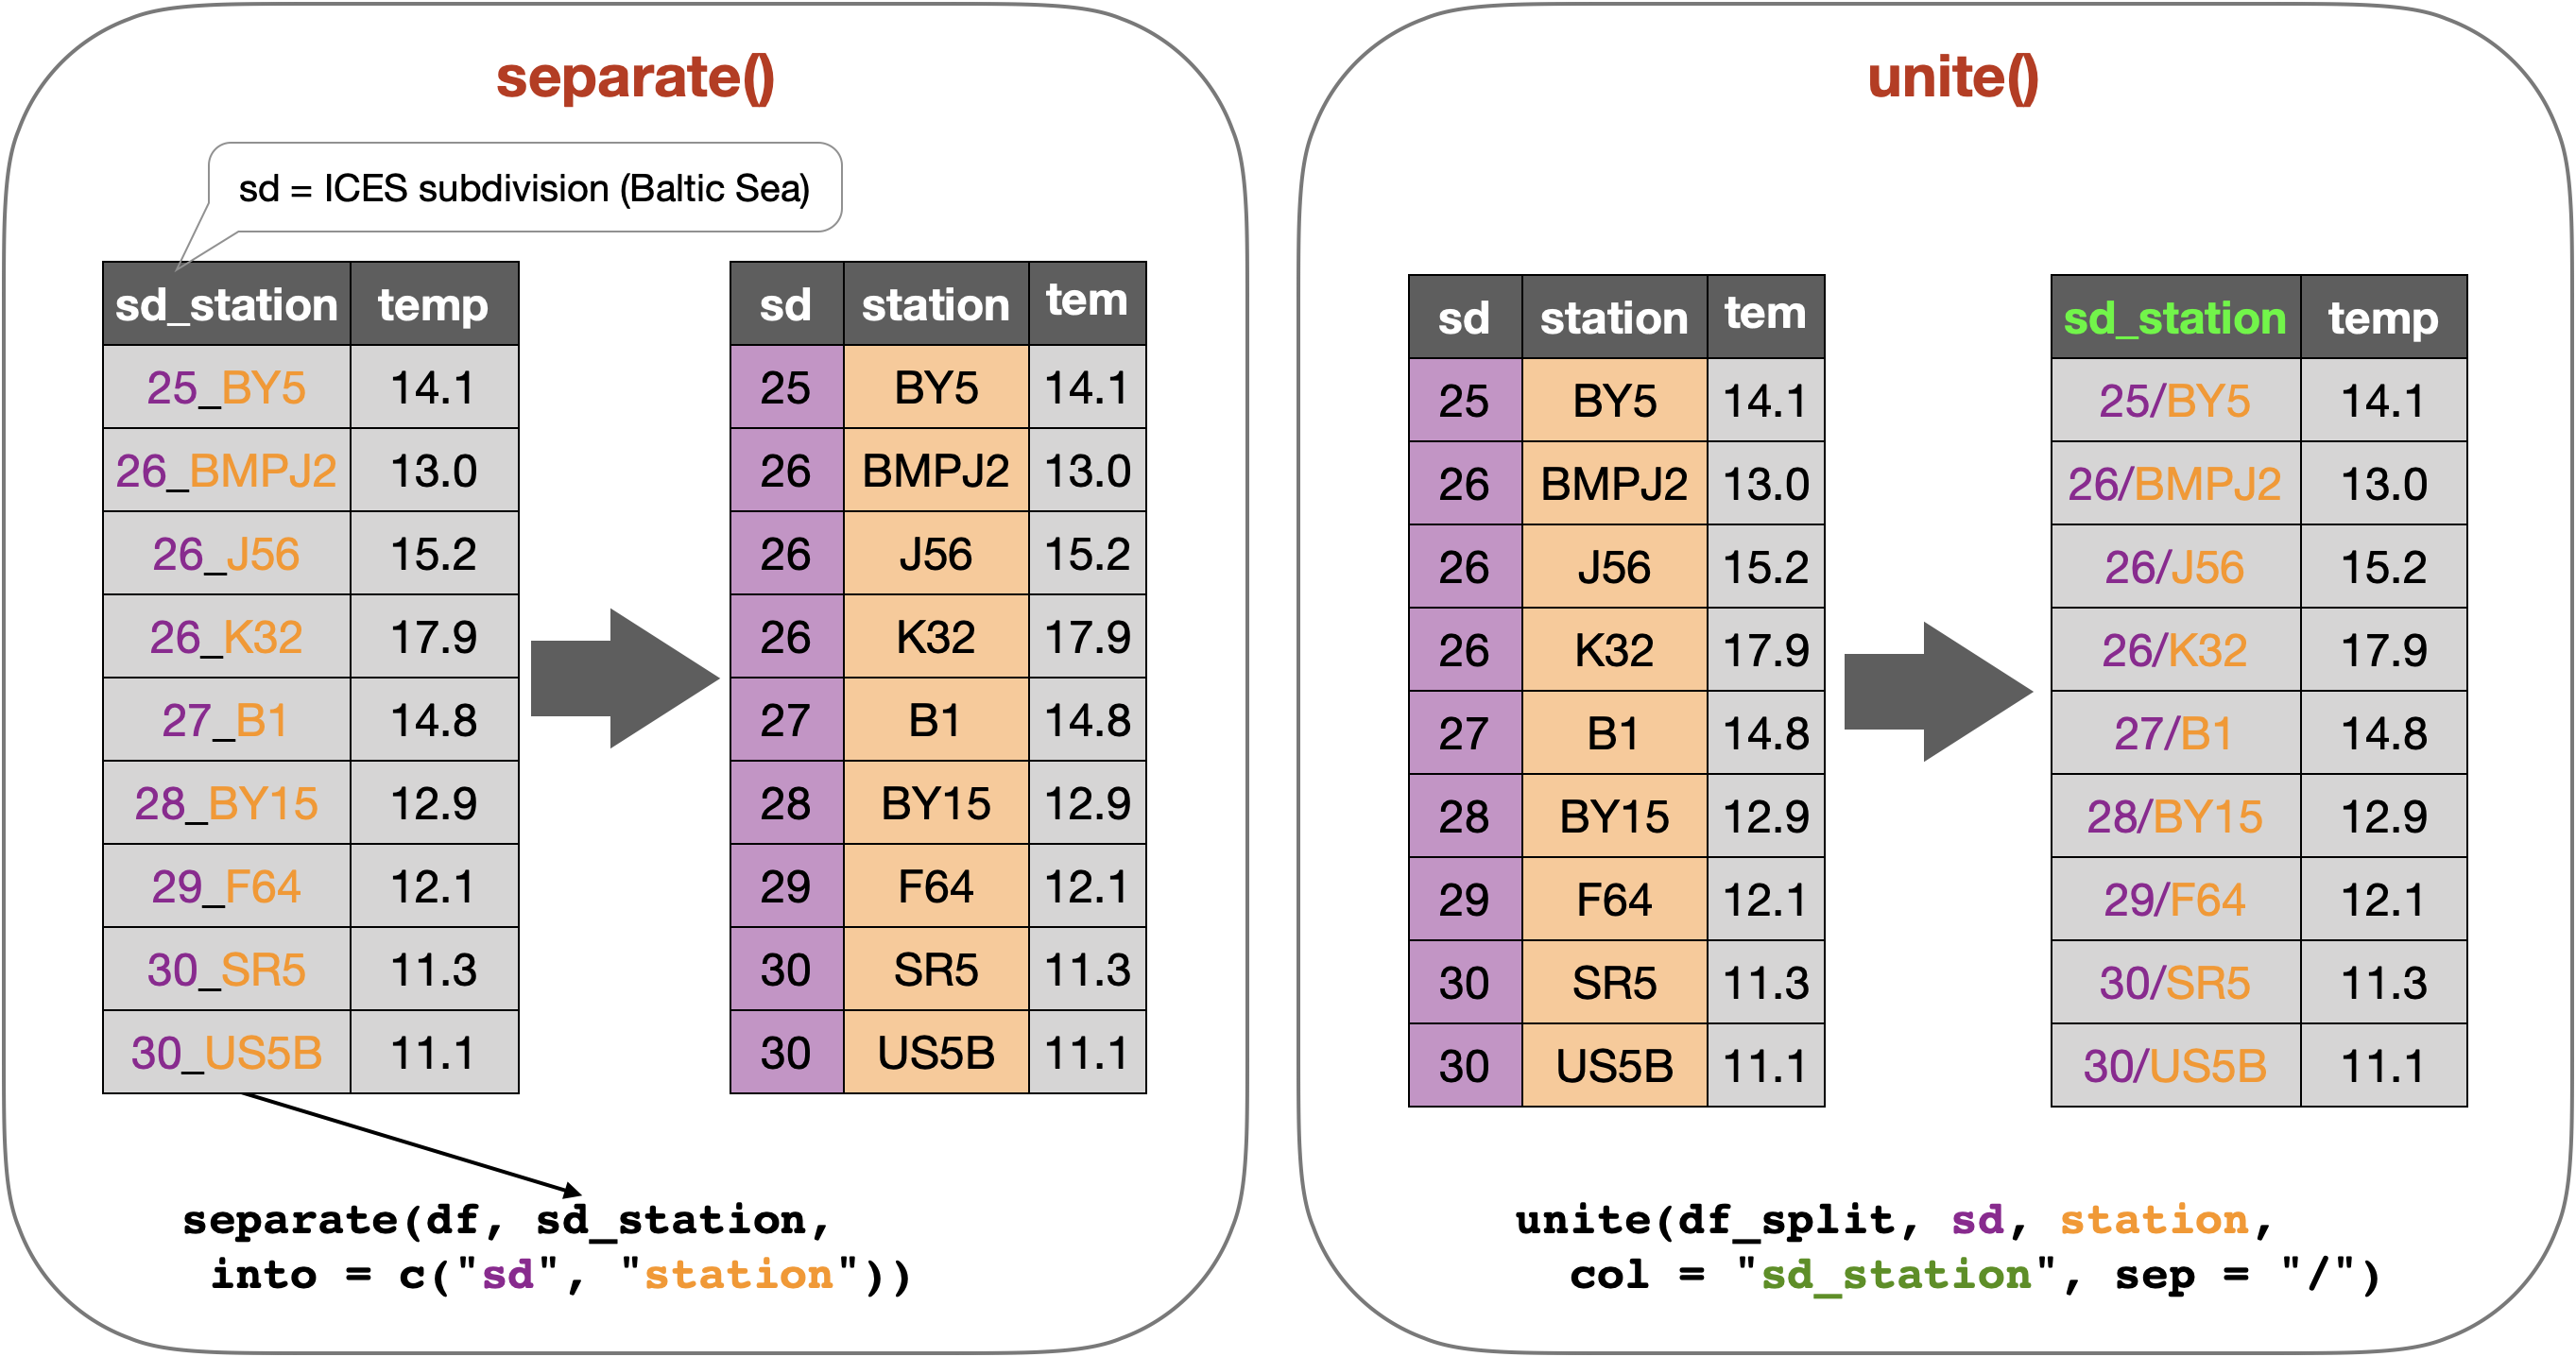
→ separate() wurde in neueren tidyr-Versionen durch separate_wider_delim() abgelöst (‘superseded’), funktioniert aber weiterhin.
Warum sind pivot_longer() und pivot_wider() nicht perfekt symmetrisch? Begutachten Sie sorgfältig folgenden Datensatz (hier wieder ein Tibble):
stocks# A tibble: 9 × 3
year quarter stock_return
<dbl> <int> <dbl>
1 2014 2 0.97
2 2014 3 1.13
3 2014 4 0.77
4 2015 1 0.61
5 2015 2 0.77
6 2015 3 1
7 2015 4 0.95
8 2016 1 0.79
9 2016 2 1.36Vervollständigen Sie den Code, um den Datensatz in folgendes Format zu bringen:
# A tibble: 3 × 5
   year   `2`   `3`   `4`   `1`
  <dbl> <dbl> <dbl> <dbl> <dbl>
1  2014  0.97  1.13  0.77 NA
2  2015  0.77  1     0.95  0.61
3 2016 1.36 NA NA 0.79stocks_mod1 <- pivot_wider(
stocks,
names_from = quarter,
values_from = stock_return
)
stocks_mod1# A tibble: 3 × 5
year `2` `3` `4` `1`
<dbl> <dbl> <dbl> <dbl> <dbl>
1 2014 0.97 1.13 0.77 NA
2 2015 0.77 1 0.95 0.61
3 2016 1.36 NA NA 0.79Vervollständigen Sie den Code, um den Datensatz zurück ins ursprüngliche Format zu bringen.
stocks_mod2 <- pivot_longer(
  stocks_mod1,
  cols = -year,
  names_to = 'quarter',
  values_to = 'stock_return'
)
stocks_mod2
# A tibble: 12 × 3
year quarter stock_return
<dbl> <chr> <dbl>
1 2014 2 0.97
2 2014 3 1.13
3 2014 4 0.77
4 2014 1 NA
5 2015 2 0.77
6 2015 3 1
7 2015 4 0.95
8 2015 1 0.61
9 2016 2 1.36
10 2016 3 NA
11 2016 4 NA
12 2016 1 0.79Zurück zur Eingangsfrage: Warum sind pivot_longer() und pivot_wider() nicht perfekt symmetrisch?
stocks1 <- unite(
  stocks, quarter, year,
  col = 'time',
  sep = '/')
stocks1
# A tibble: 9 × 2
time stock_return
<chr> <dbl>
1 2/2014 0.97
2 3/2014 1.13
3 4/2014 0.77
4 1/2015 0.61
5 2/2015 0.77
6 3/2015 1
7 4/2015 0.95
8 1/2016 0.79
9 2/2016 1.36stocks2 <- separate(
stocks1, time,
into = c('quarter', 'year'))
stocks2# A tibble: 9 × 3
quarter year stock_return
<chr> <chr> <dbl>
1 2 2014 0.97
2 3 2014 1.13
3 4 2014 0.77
4 1 2015 0.61
5 2 2015 0.77
6 3 2015 1
7 4 2015 0.95
8 1 2016 0.79
9 2 2016 1.36

Alle Aufgaben der Übungswoche finden Sie im Handbuch:
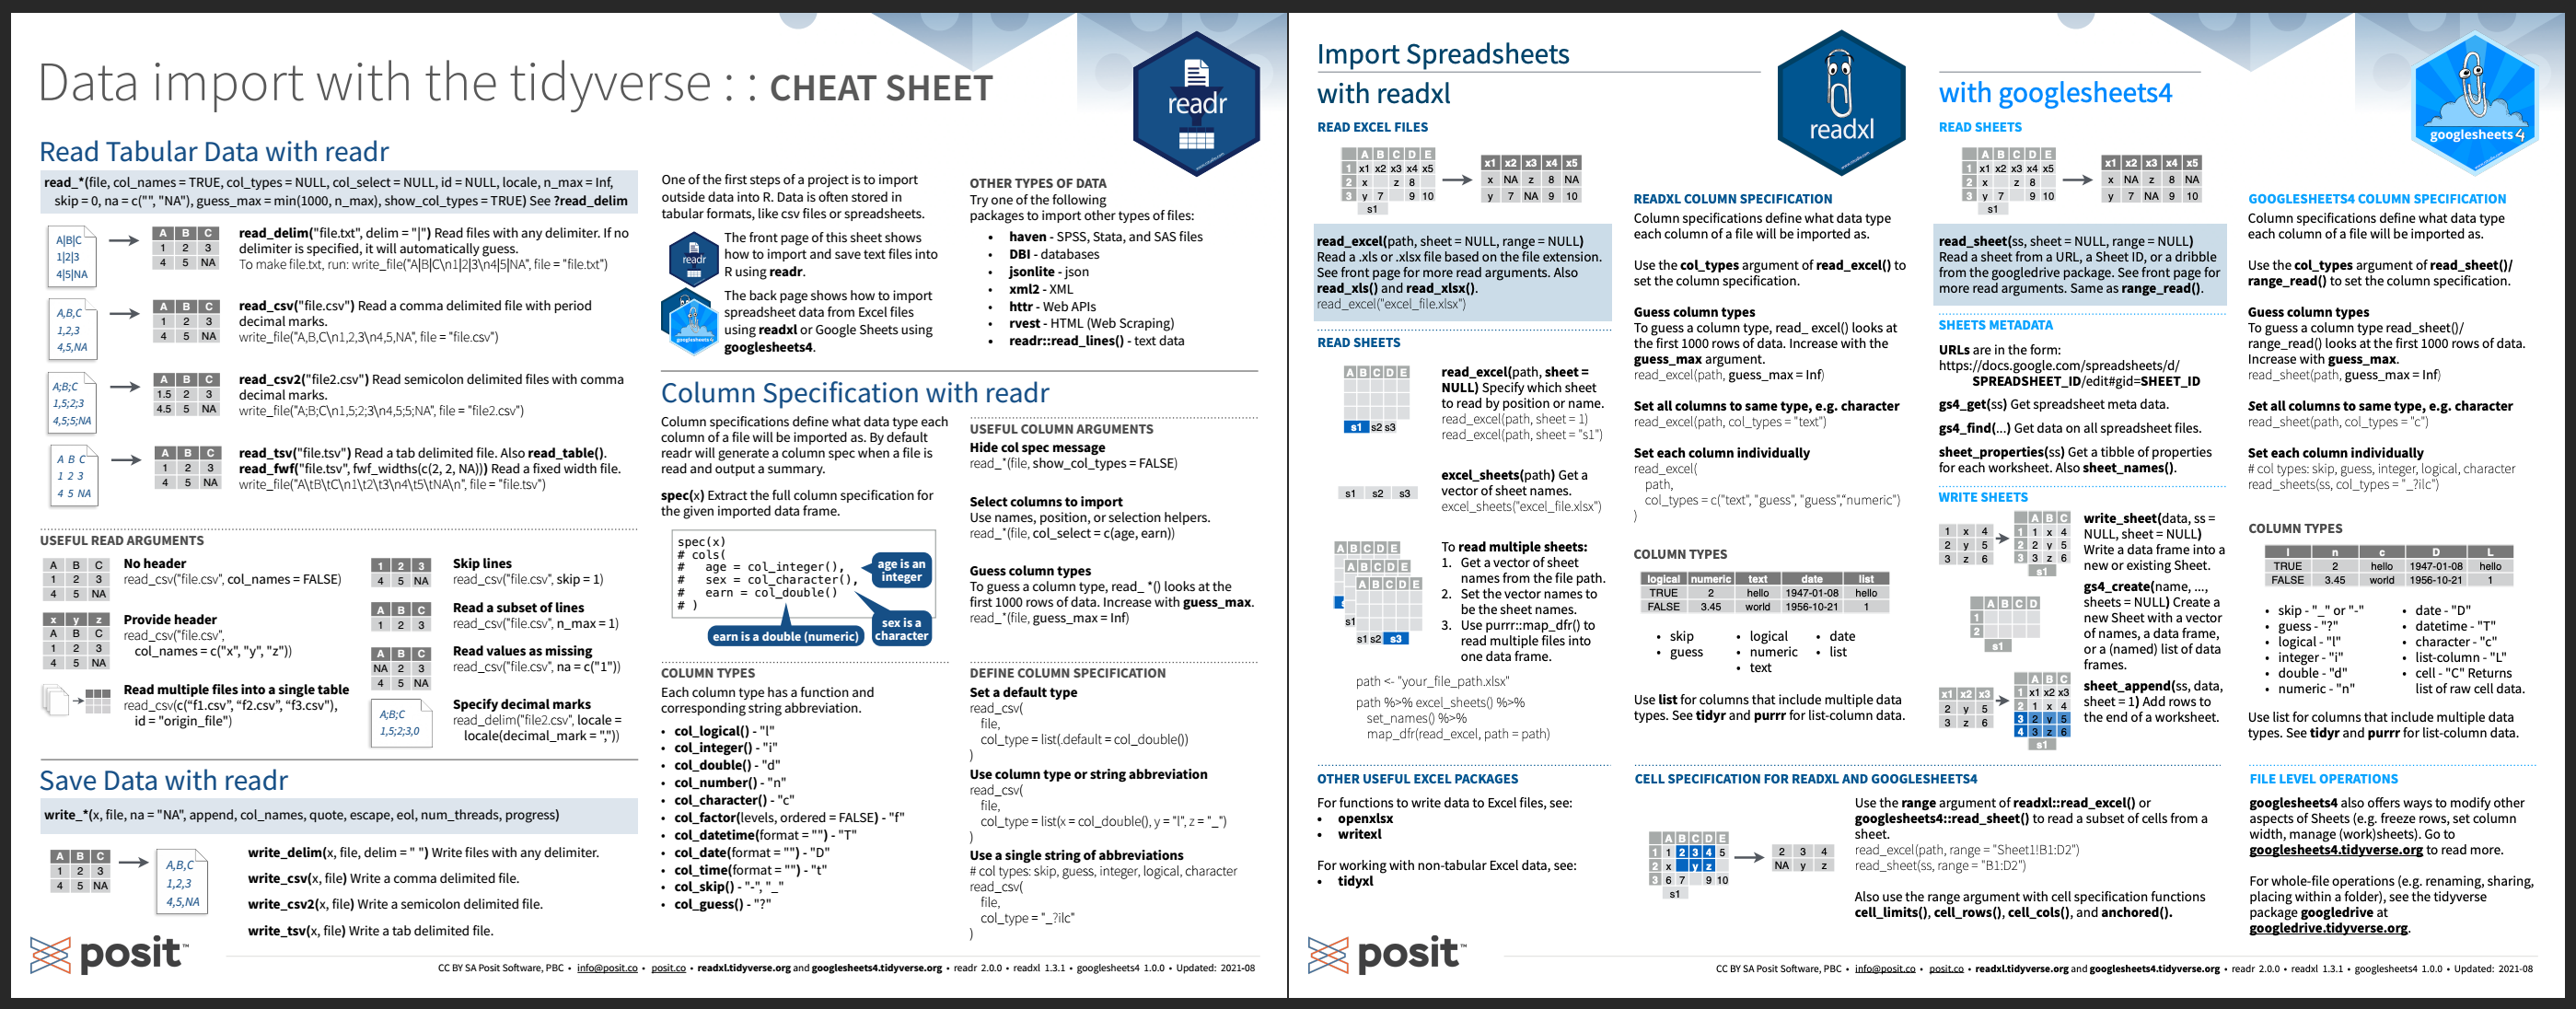
Cheatsheet zum readr Paket frei verfügbar unter diesem Link.
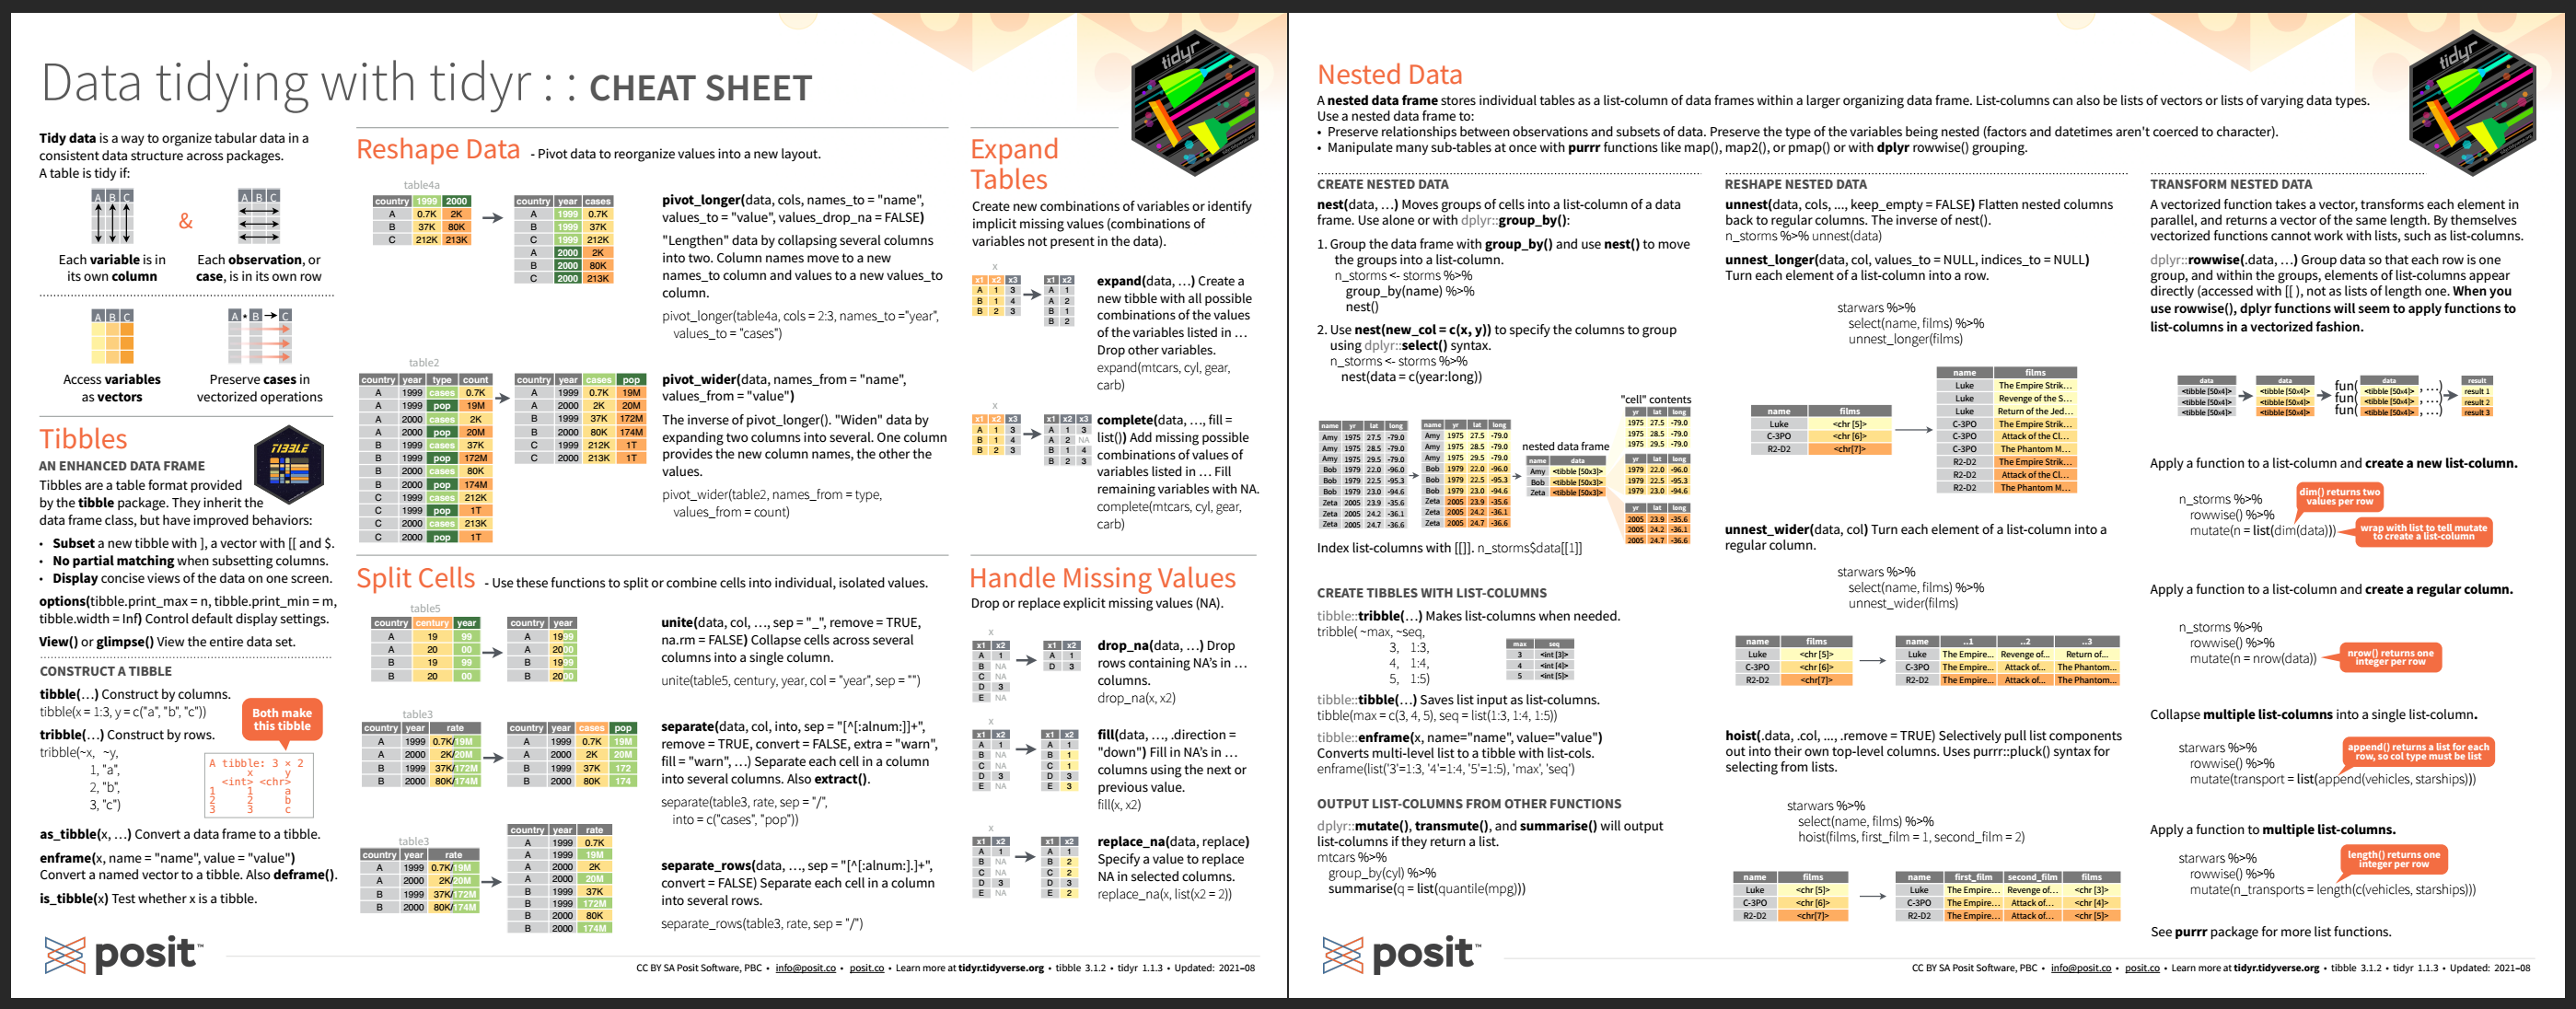
Cheatsheet zum tidyr Paket frei verfügbar unter diesem Link.
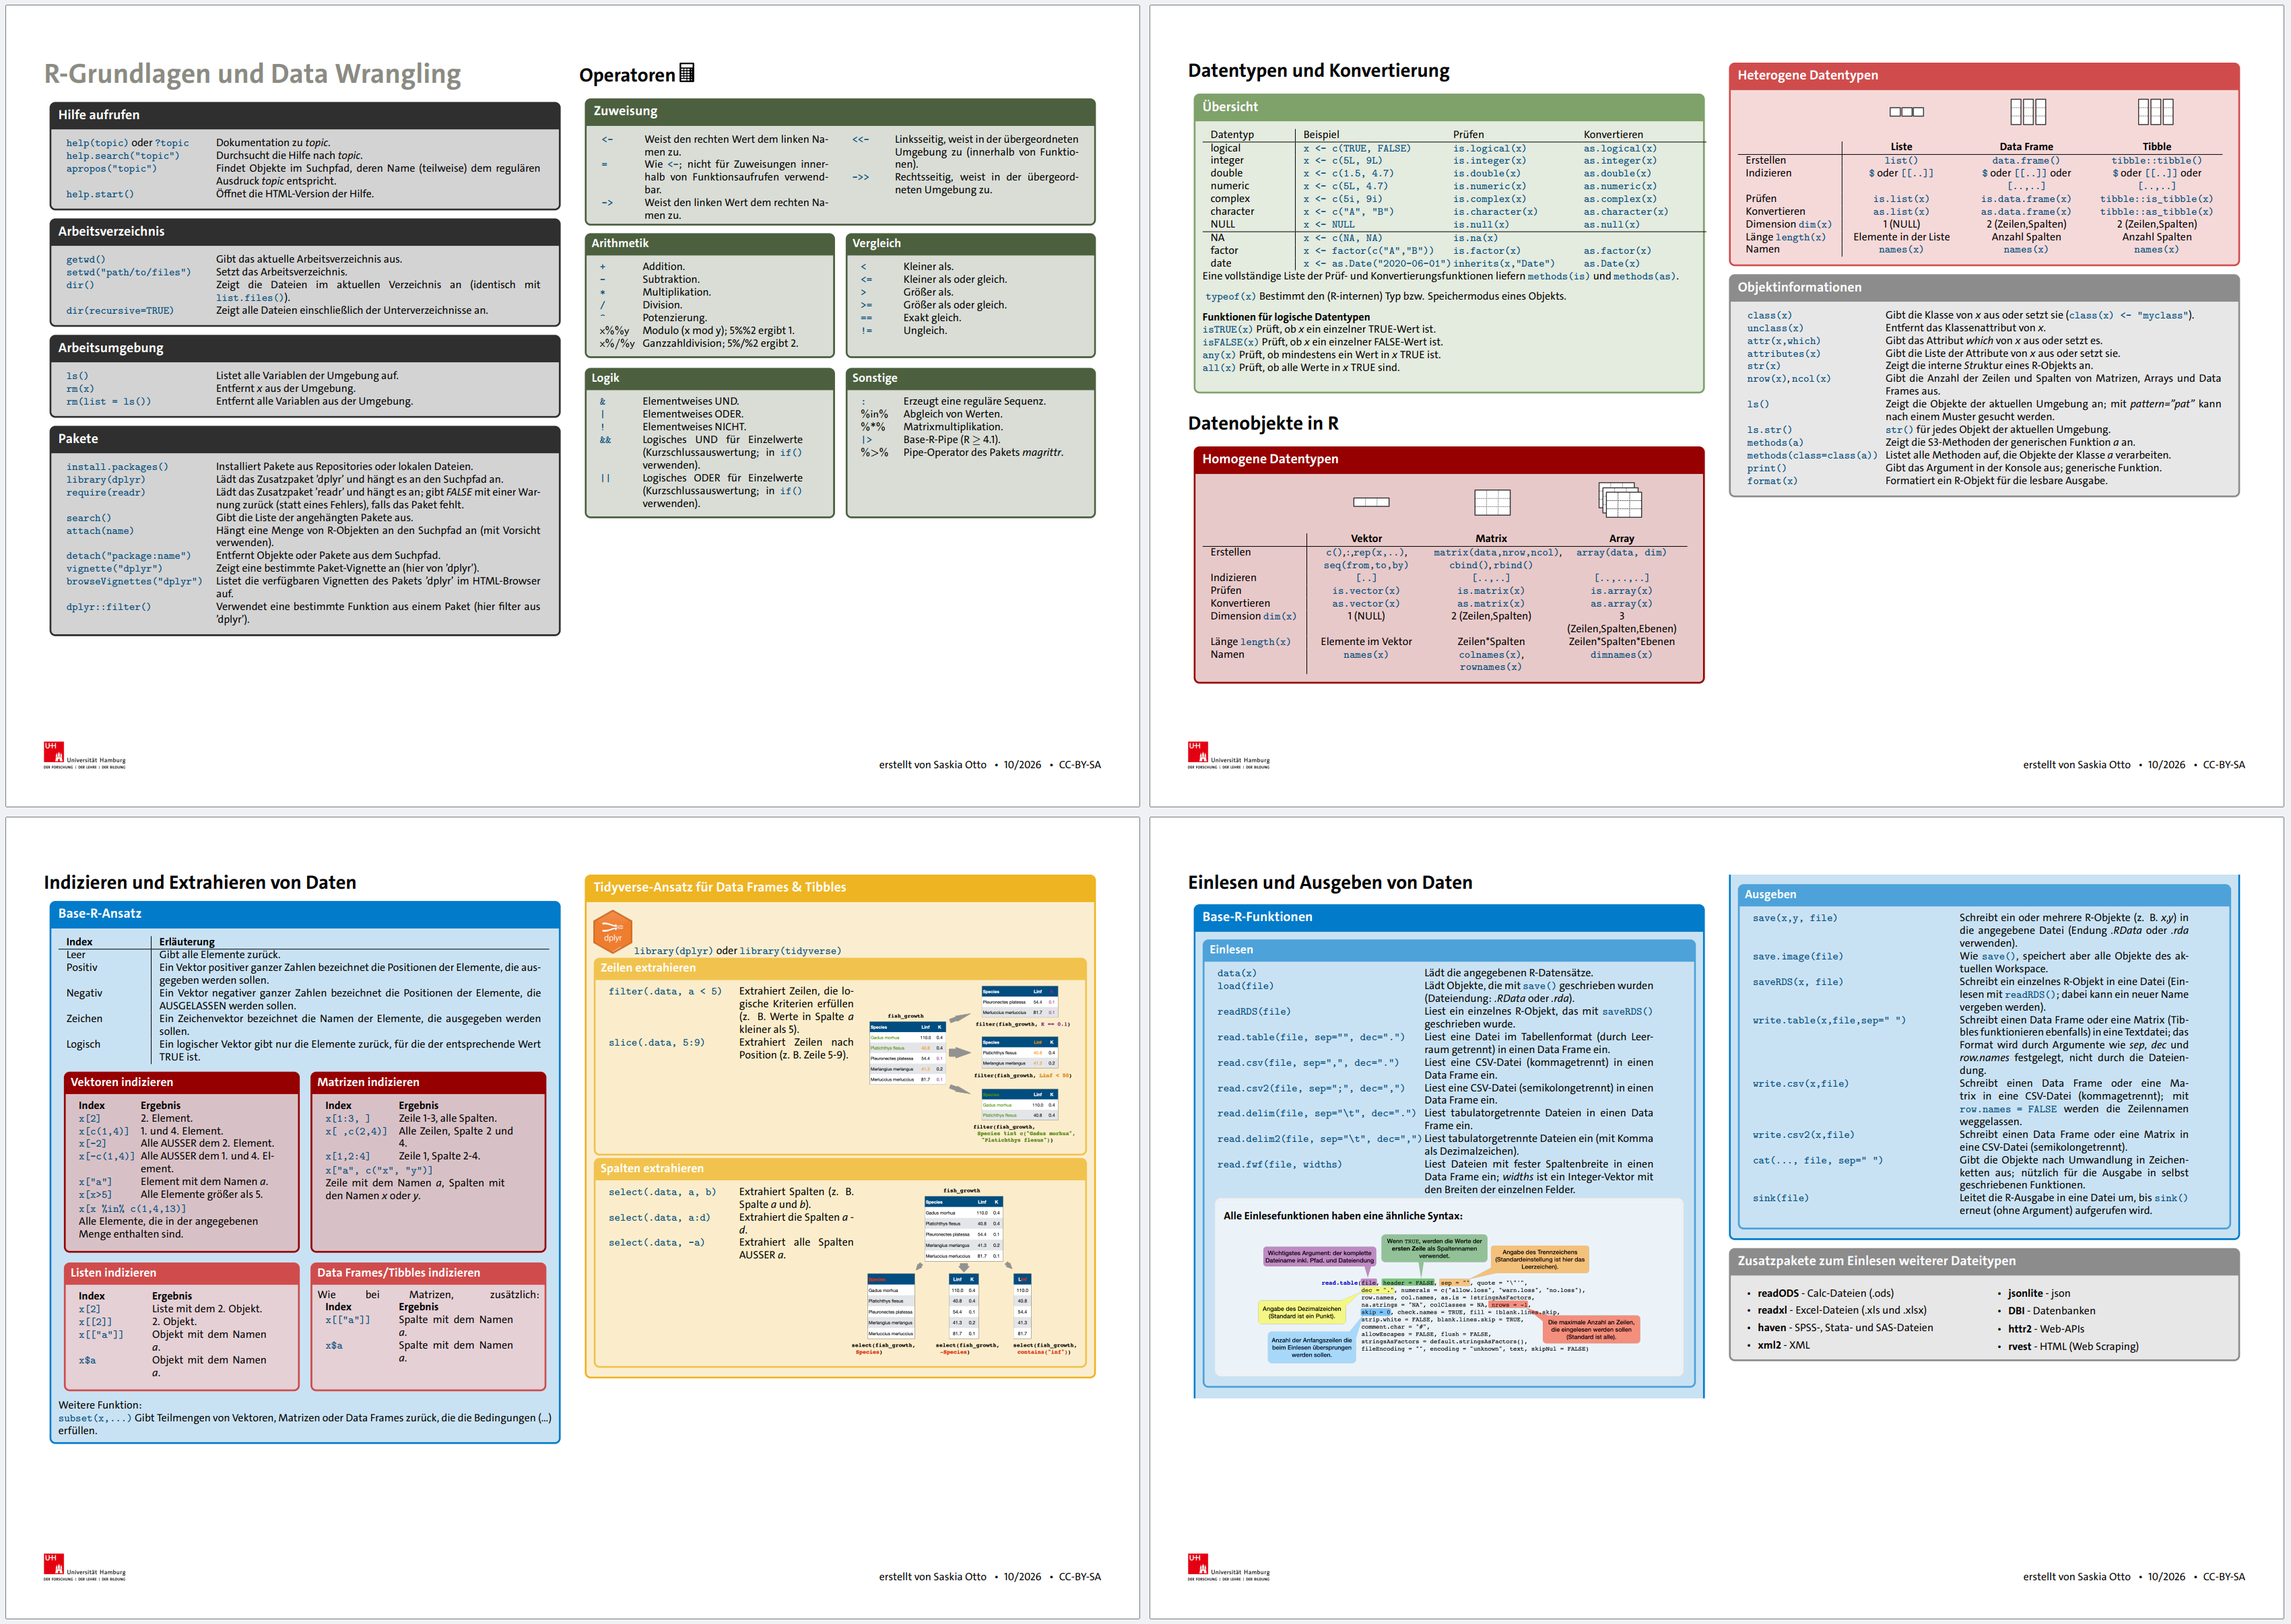
Enthält wichtigste Funktionen der Datenaufbereitung.
Dann testen Sie doch Ihr Wissen in folgendem Abschlussquiz…
Bei weiteren Fragen: saskia.otto(at)uni-hamburg.de

Diese Arbeit ist lizenziert unter einer Creative Commons Attribution-ShareAlike 4.0 International License mit Ausnahme der entliehenen und mit Quellenangabe versehenen Abbildungen.