Eine Liste mit 3 Elementen
fang <- list(
  station = "Ostsee_01",
  arten = c("Hering", "Dorsch", "Sprotte"),
  anzahl = c(120, 15, 300)
)
fang
$station
[1] "Ostsee_01"
$arten
[1] "Hering"  "Dorsch"  "Sprotte"
$anzahl
[1] 120 15 300
Data Science 1 - Programmieren & Visualisieren
Universität Hamburg, IMF
Wintersemester

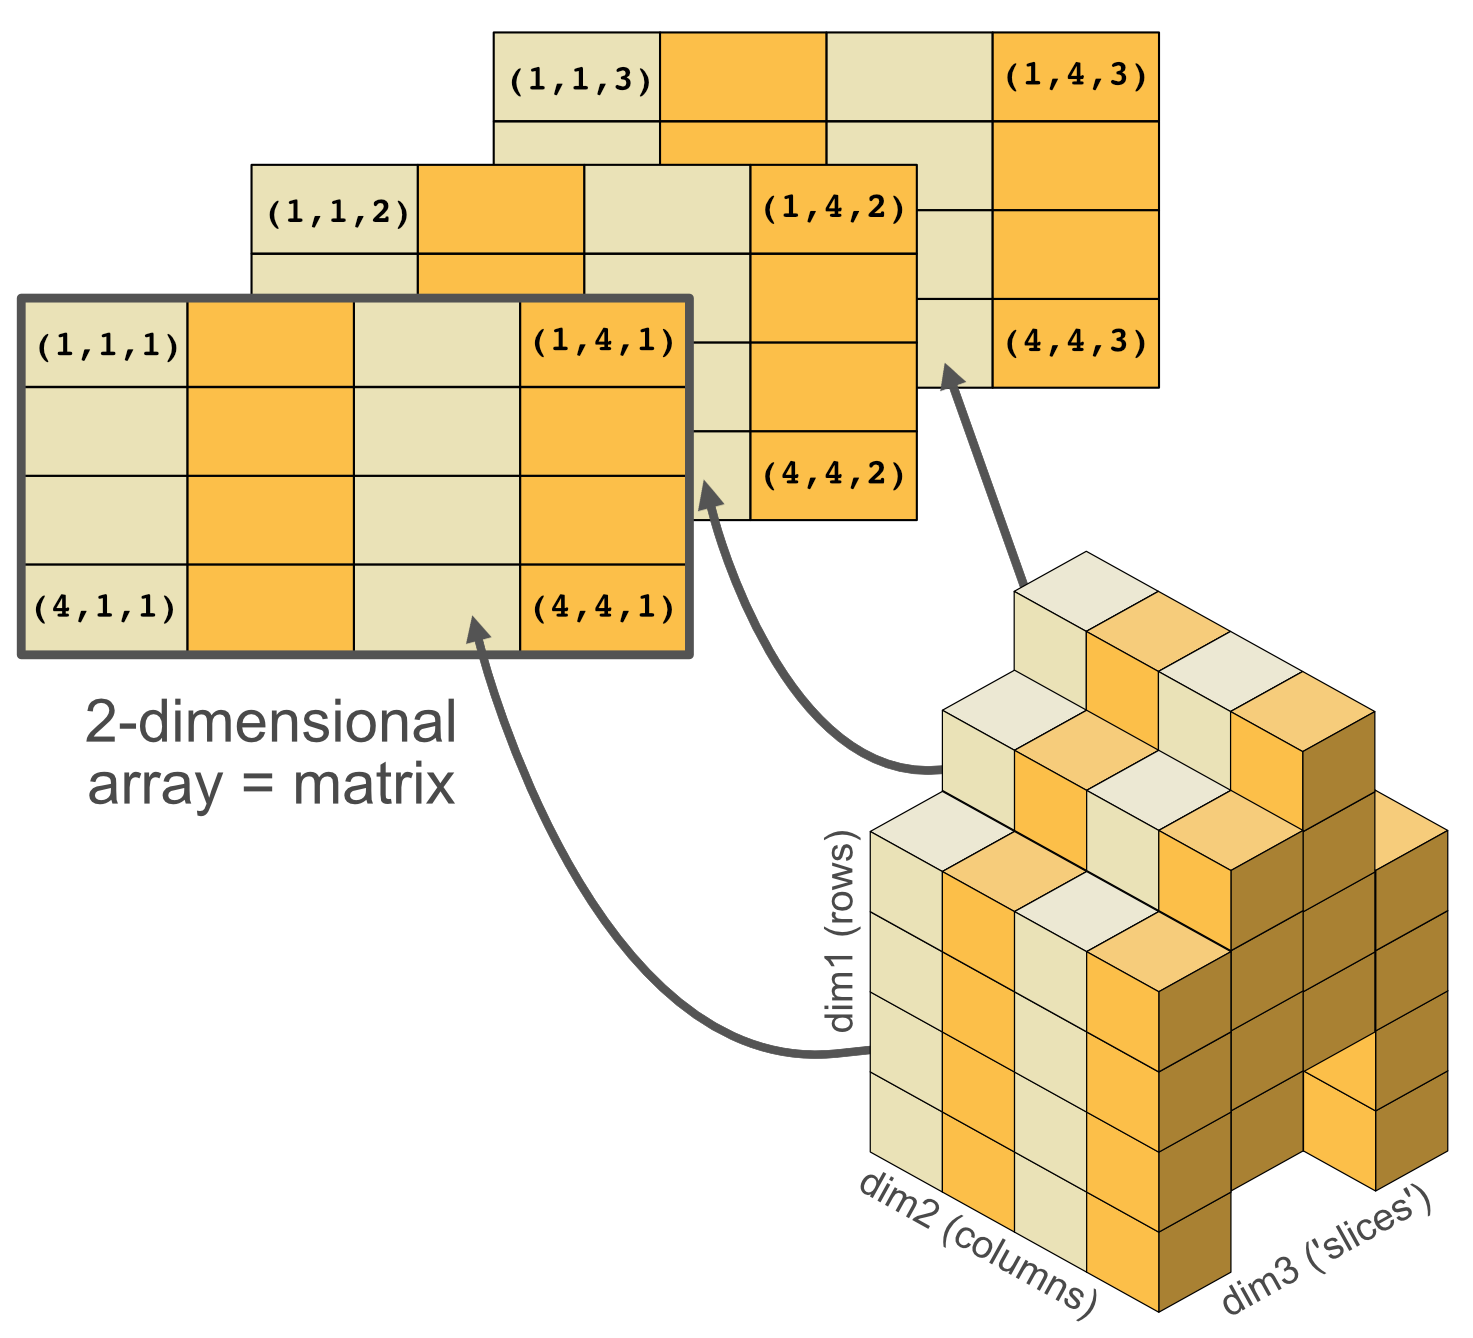
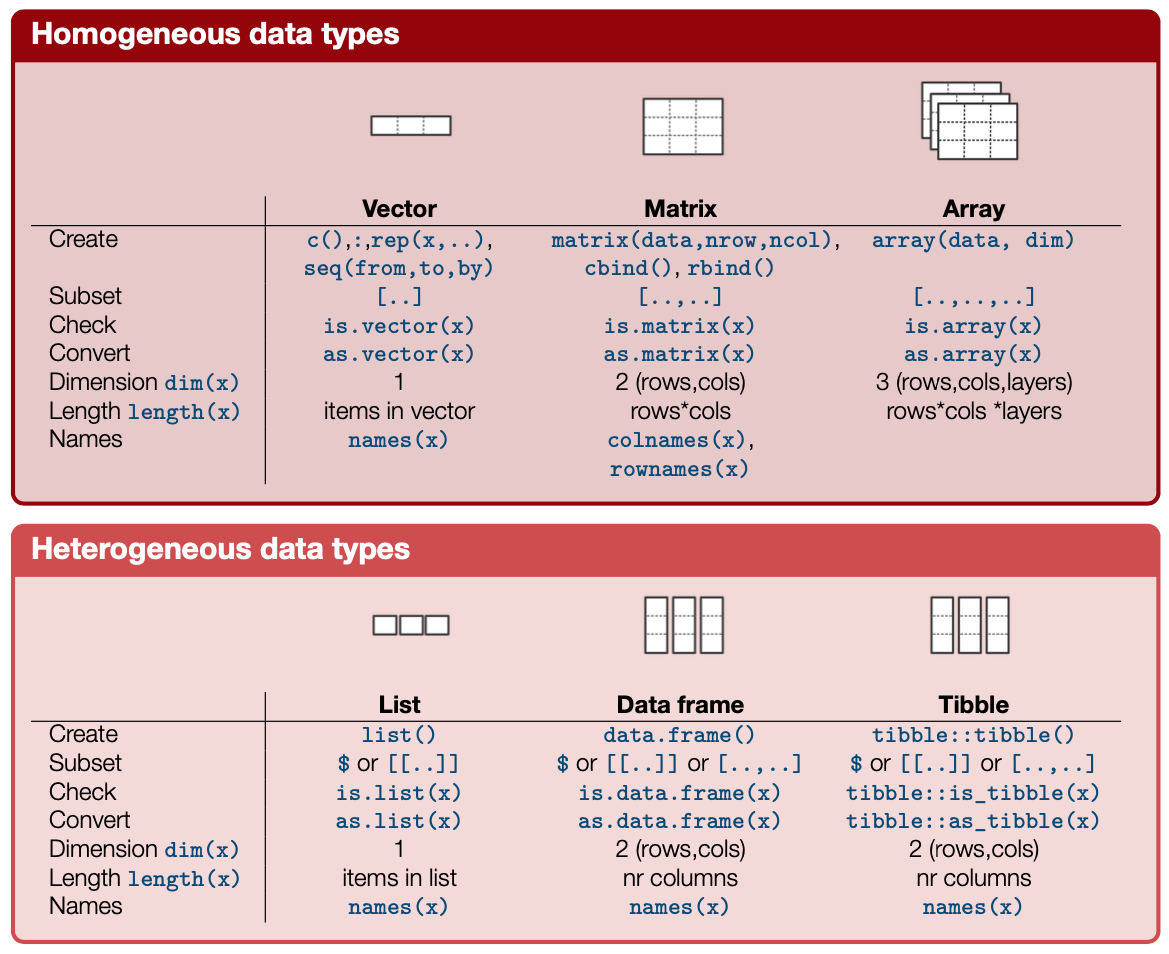
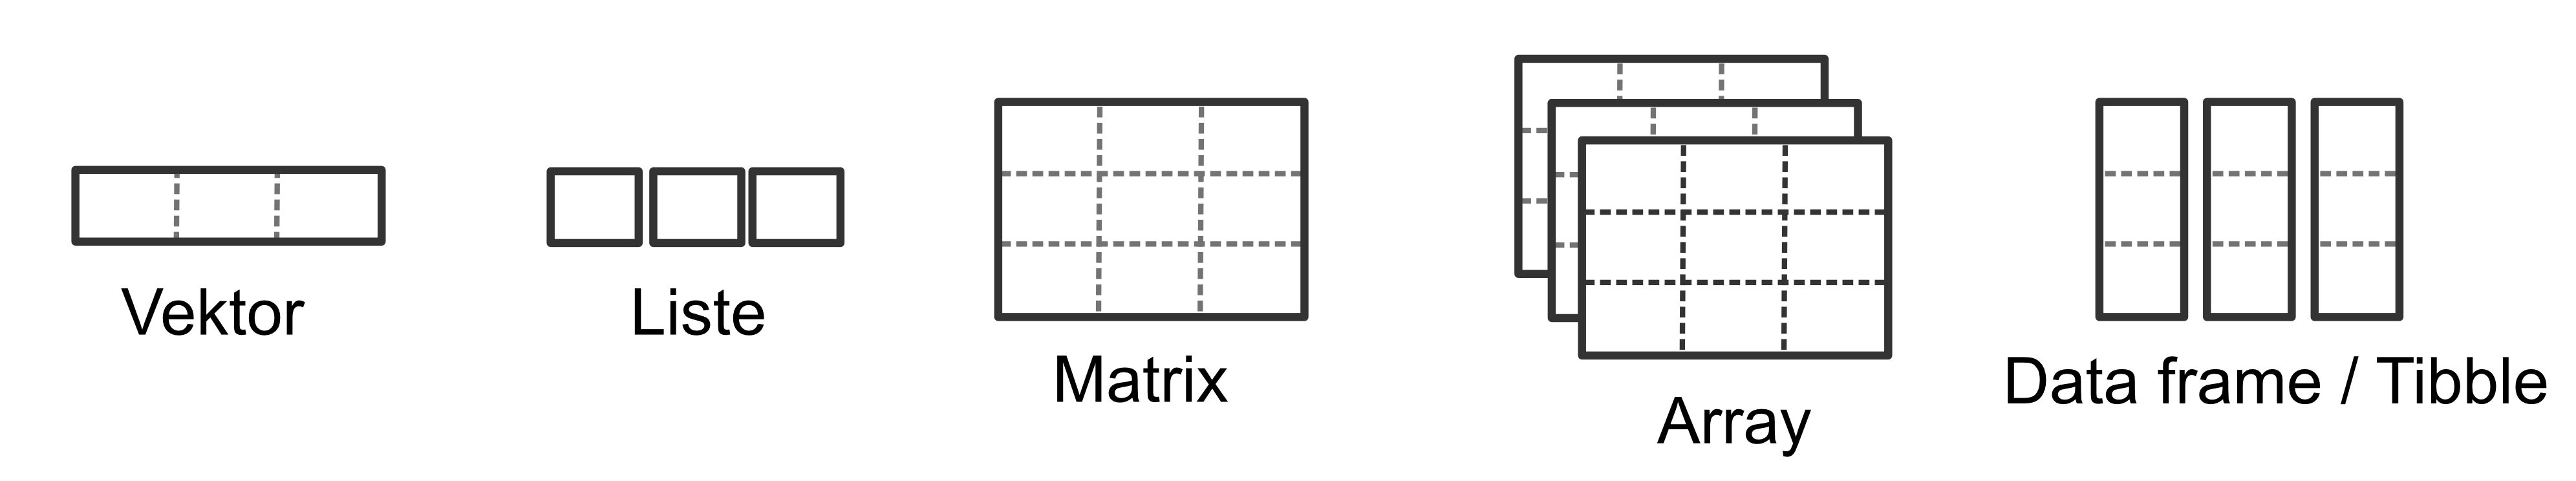
Datenstrukturen in R lassen sich bzgl. ihrer Dimensionalität und der Homogenität bzw. Heterogenität ihrer Datentypen in fünf verschiedene Objekttypen unterscheiden:
| Dimensionen | Homogen | Heterogen |
|---|---|---|
| 1D | (Atomarer) Vektor | Liste |
| 2D | Matrix | ‘Dataframe’ (& ‘Tibble’) |
| >2D | ‘Array’ |
lm() bei der Regression) und sind praktisch bei Schleifen.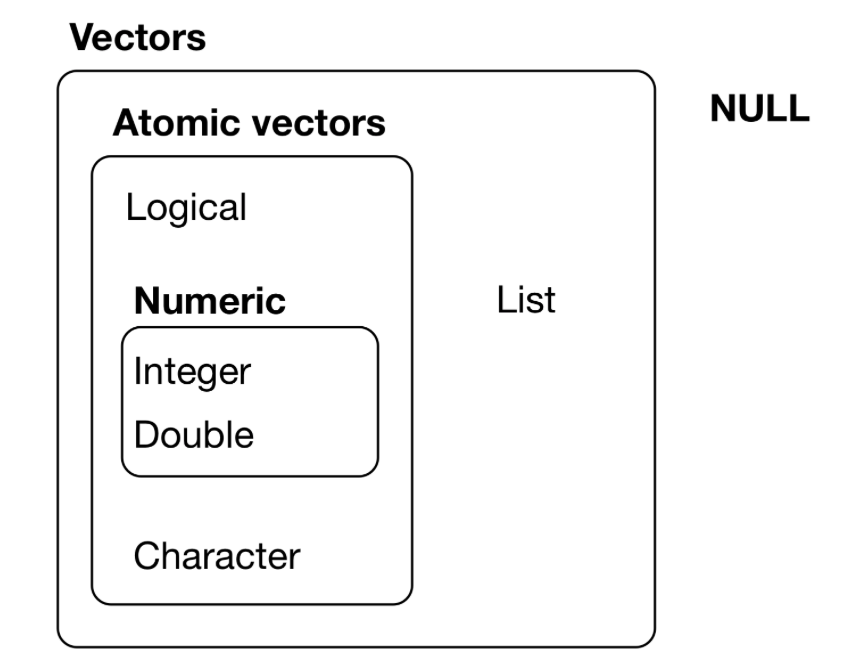
Arrays sind multi-dimensionale Objekte des gleichen Datentyps. Sie werden in der Datenanalyse in R aber eher selten genutzt und daher hier nicht näher beschrieben.
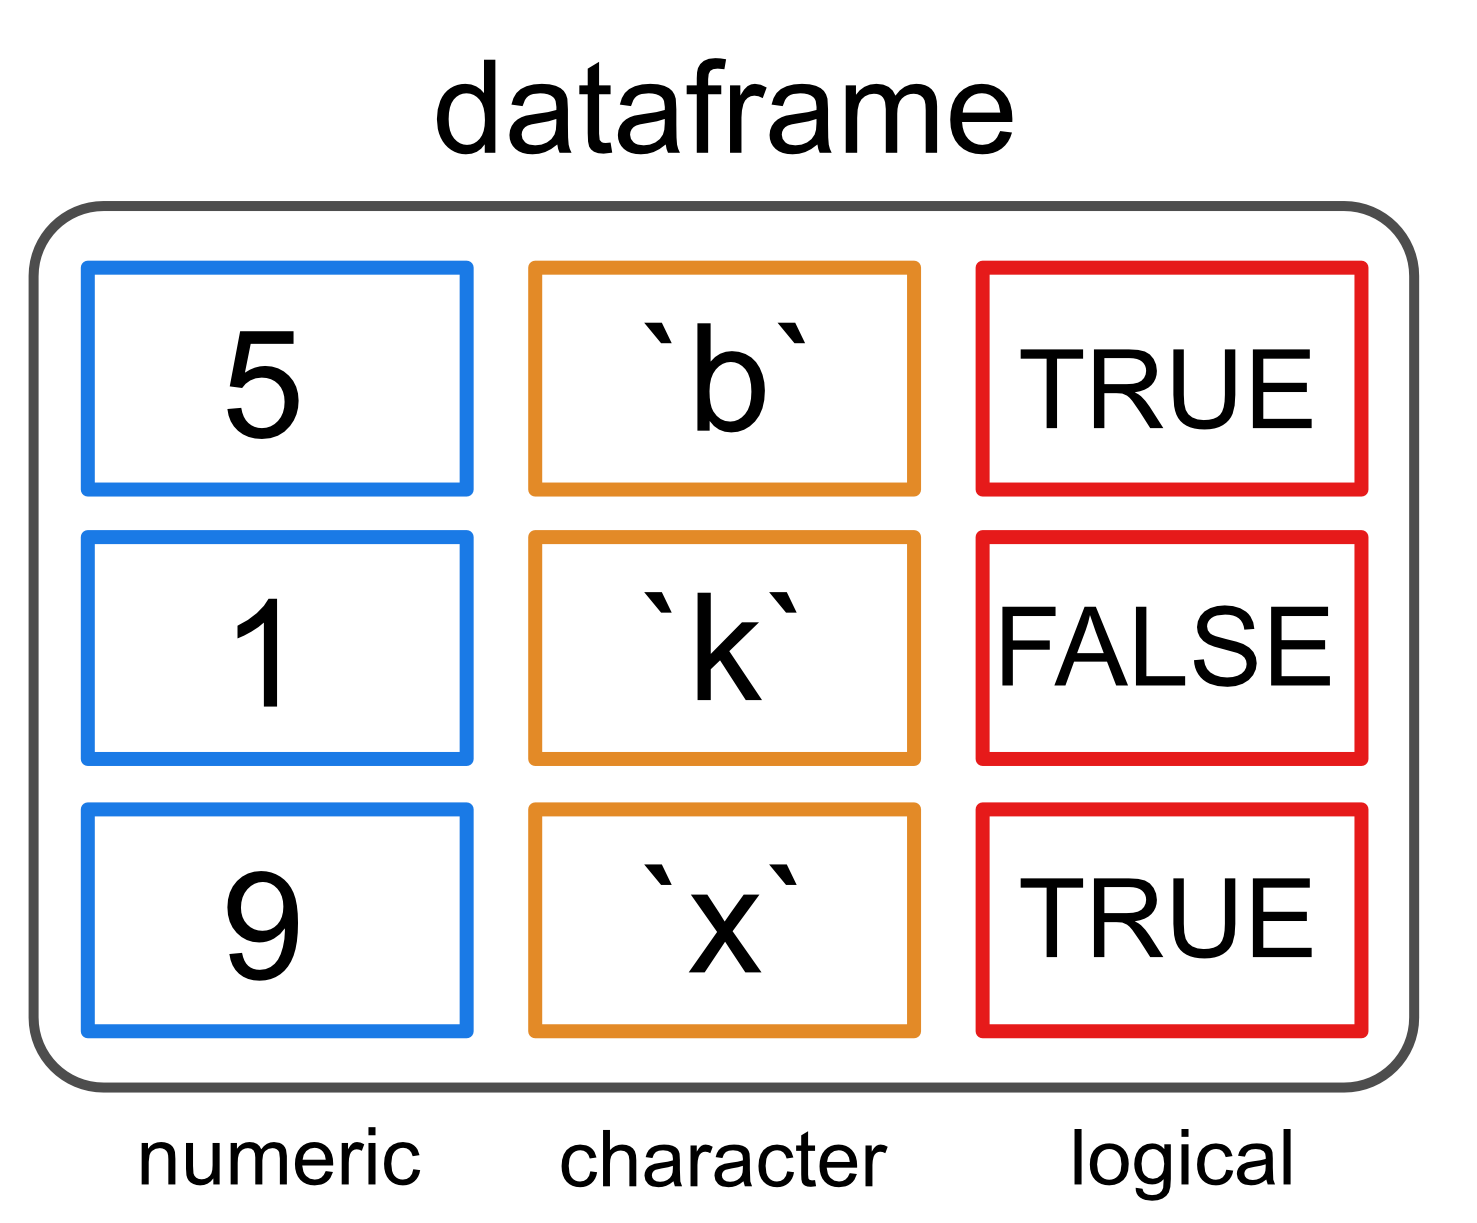
data.frame() erstellen, welche Vektoren mit Namen als Input nimmt:
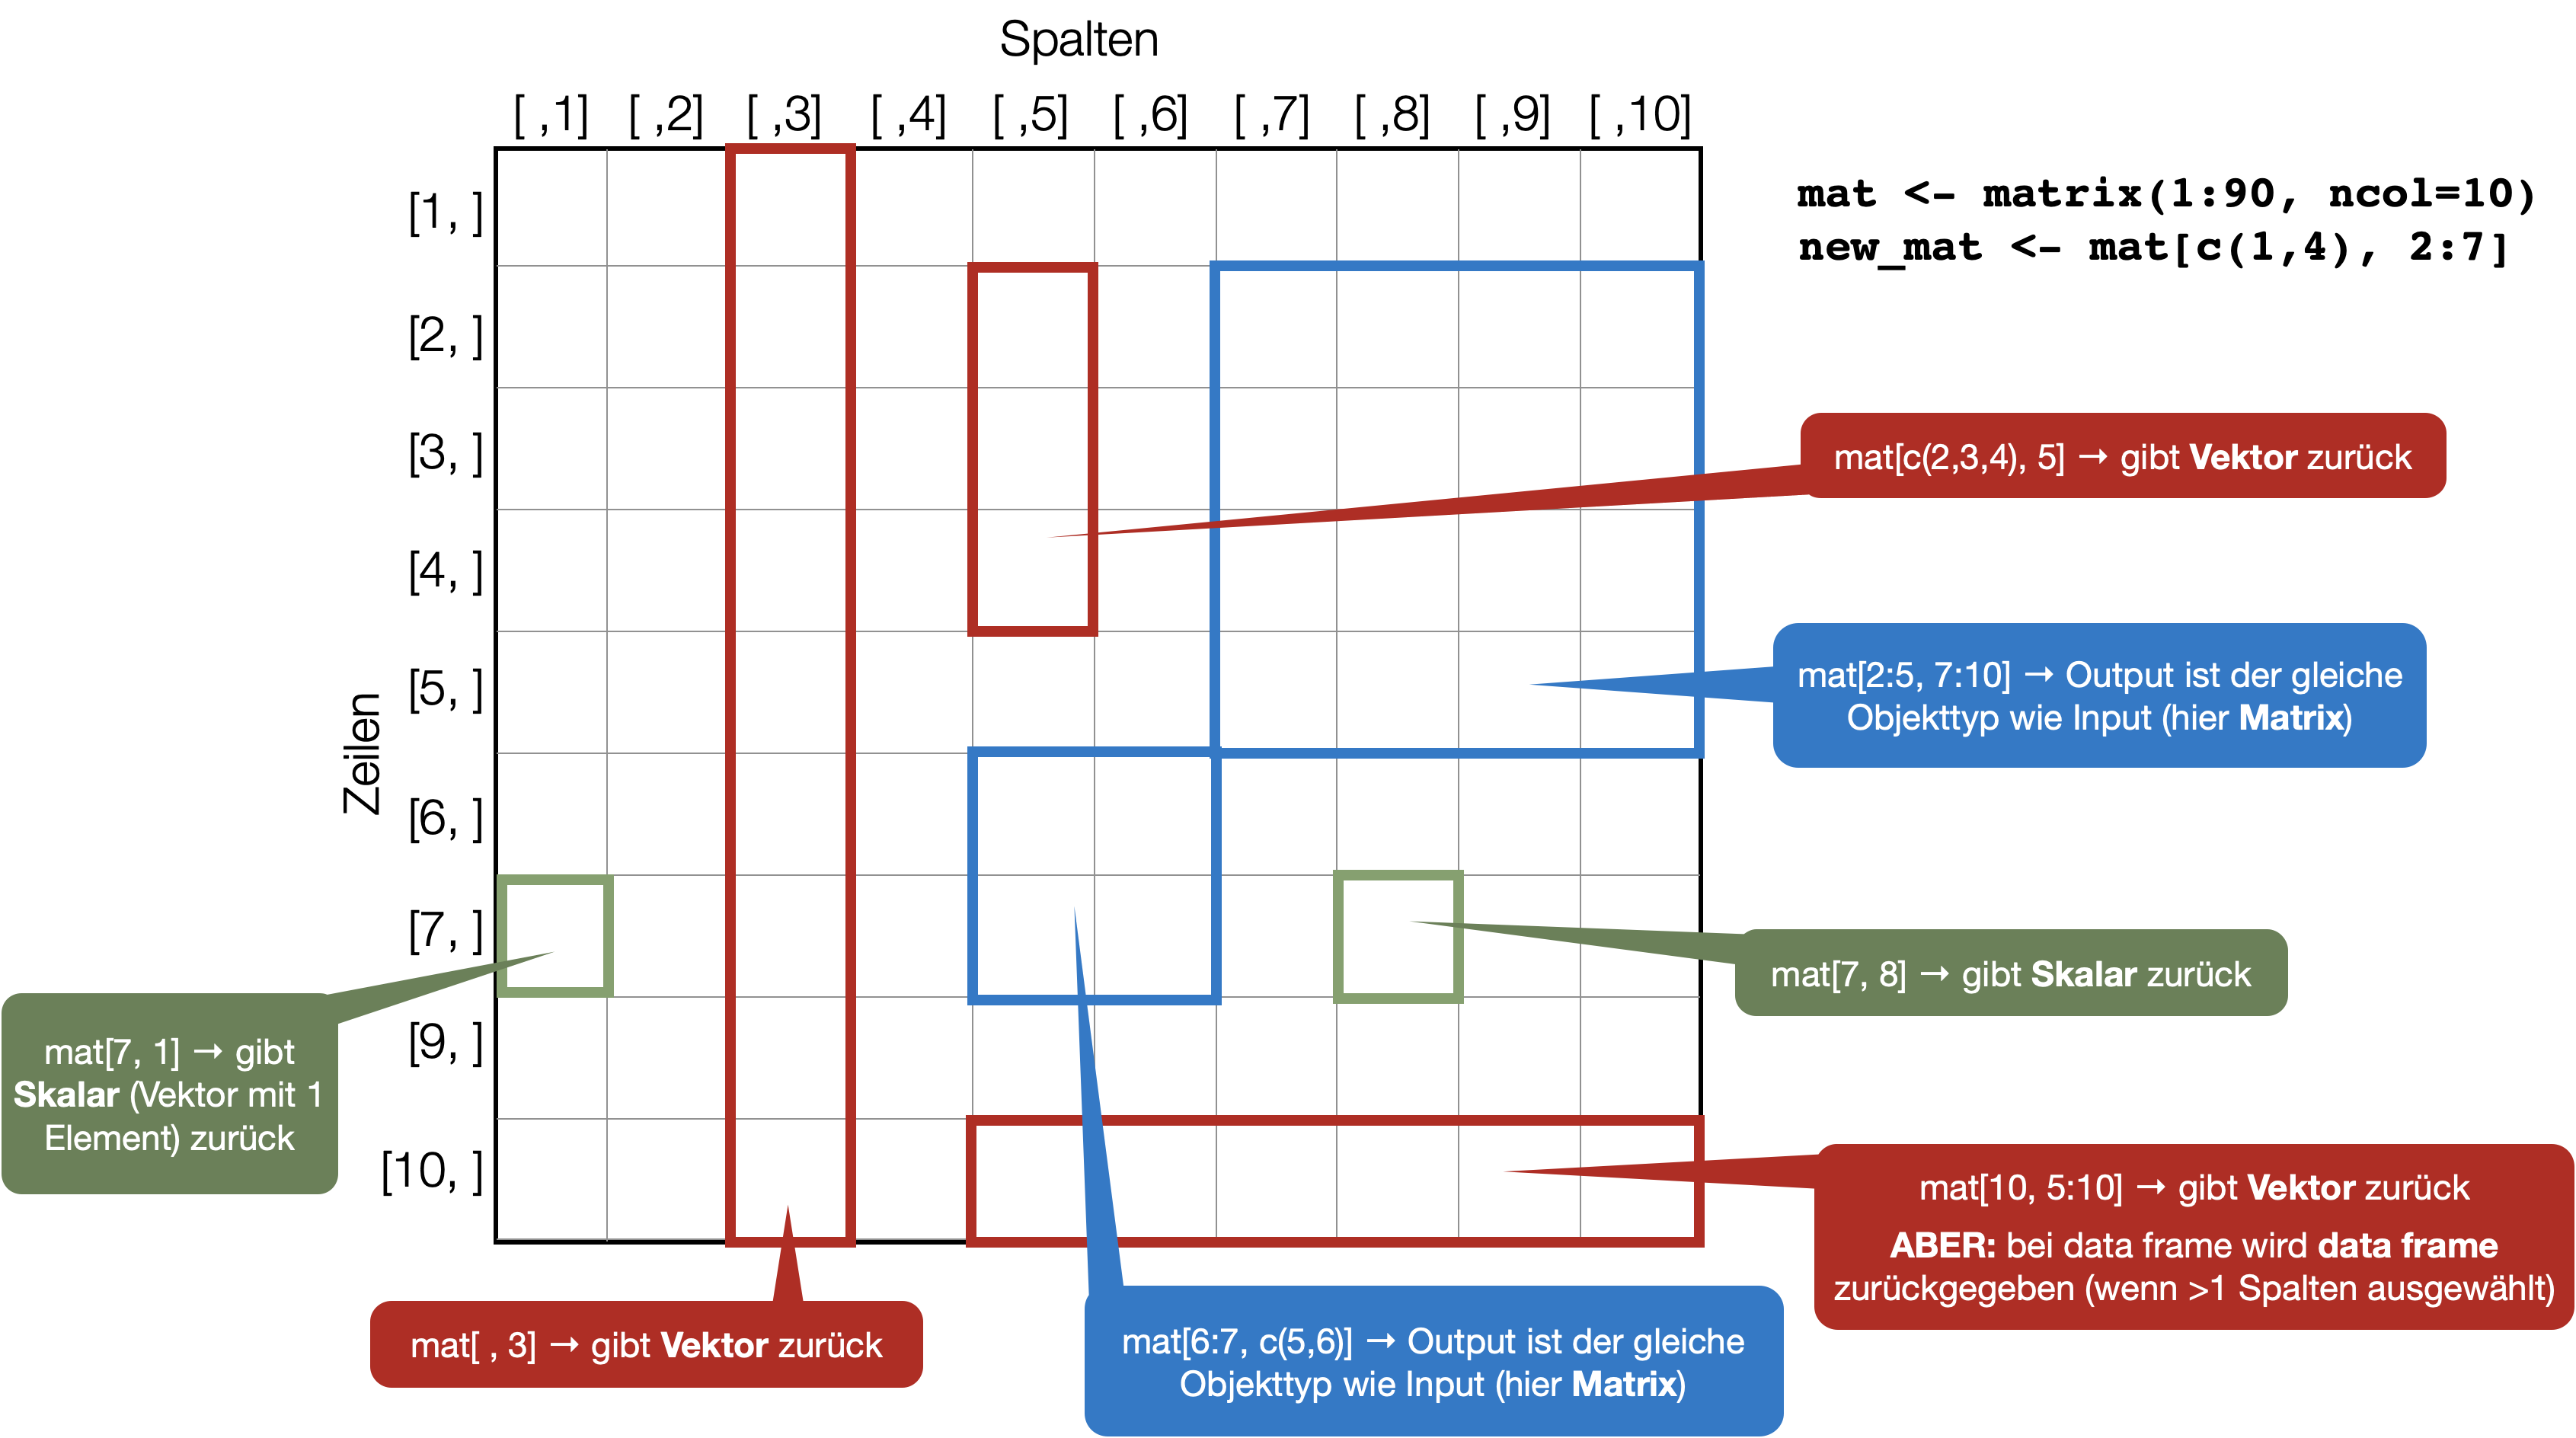
Auswahl aller Spalten und der Zeilen, wo die Werte in Spalte ‘x_neu’ >= 5 sind.
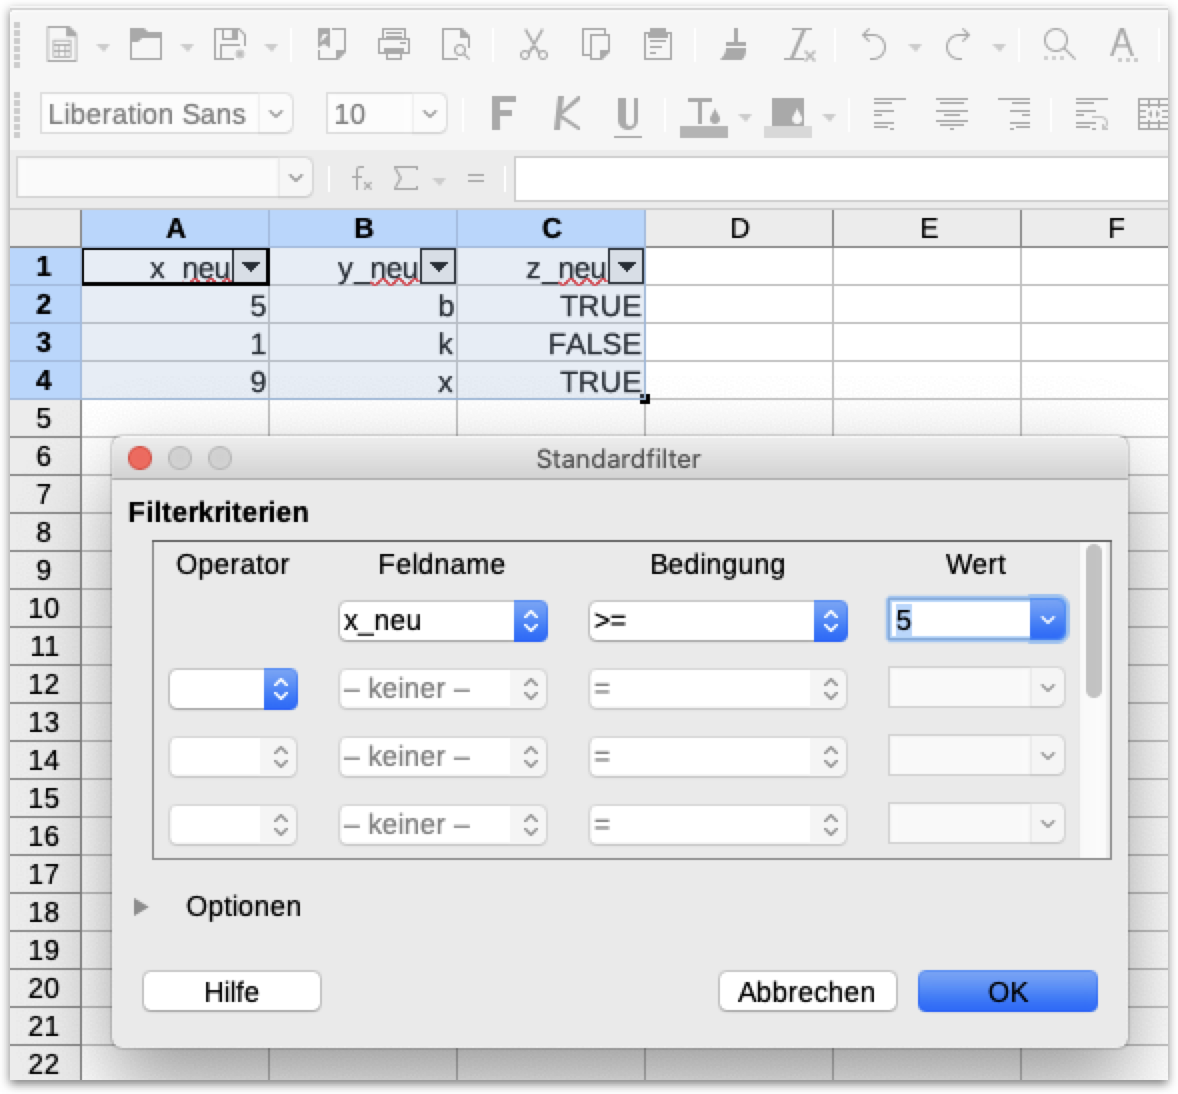
Ausgangsdaten
df x_neu y_neu z_neu
1 5 b TRUE
2 1 k FALSE
3 9 x TRUEGefilterte Zeilen
df[df$x_neu >= 5, ] x_neu y_neu z_neu
1 5 b TRUE
3 9 x TRUEEinzelne Werte überschreiben
df x_neu y_neu z_neu
1 5 b TRUE
2 1 k FALSE
3 9 x TRUEdf[1,1][1] 5df[1,1] <- NA
df$z_neu[3] <- FALSE
df x_neu y_neu z_neu
1 NA b TRUE
2 1 k FALSE
3 9 x FALSE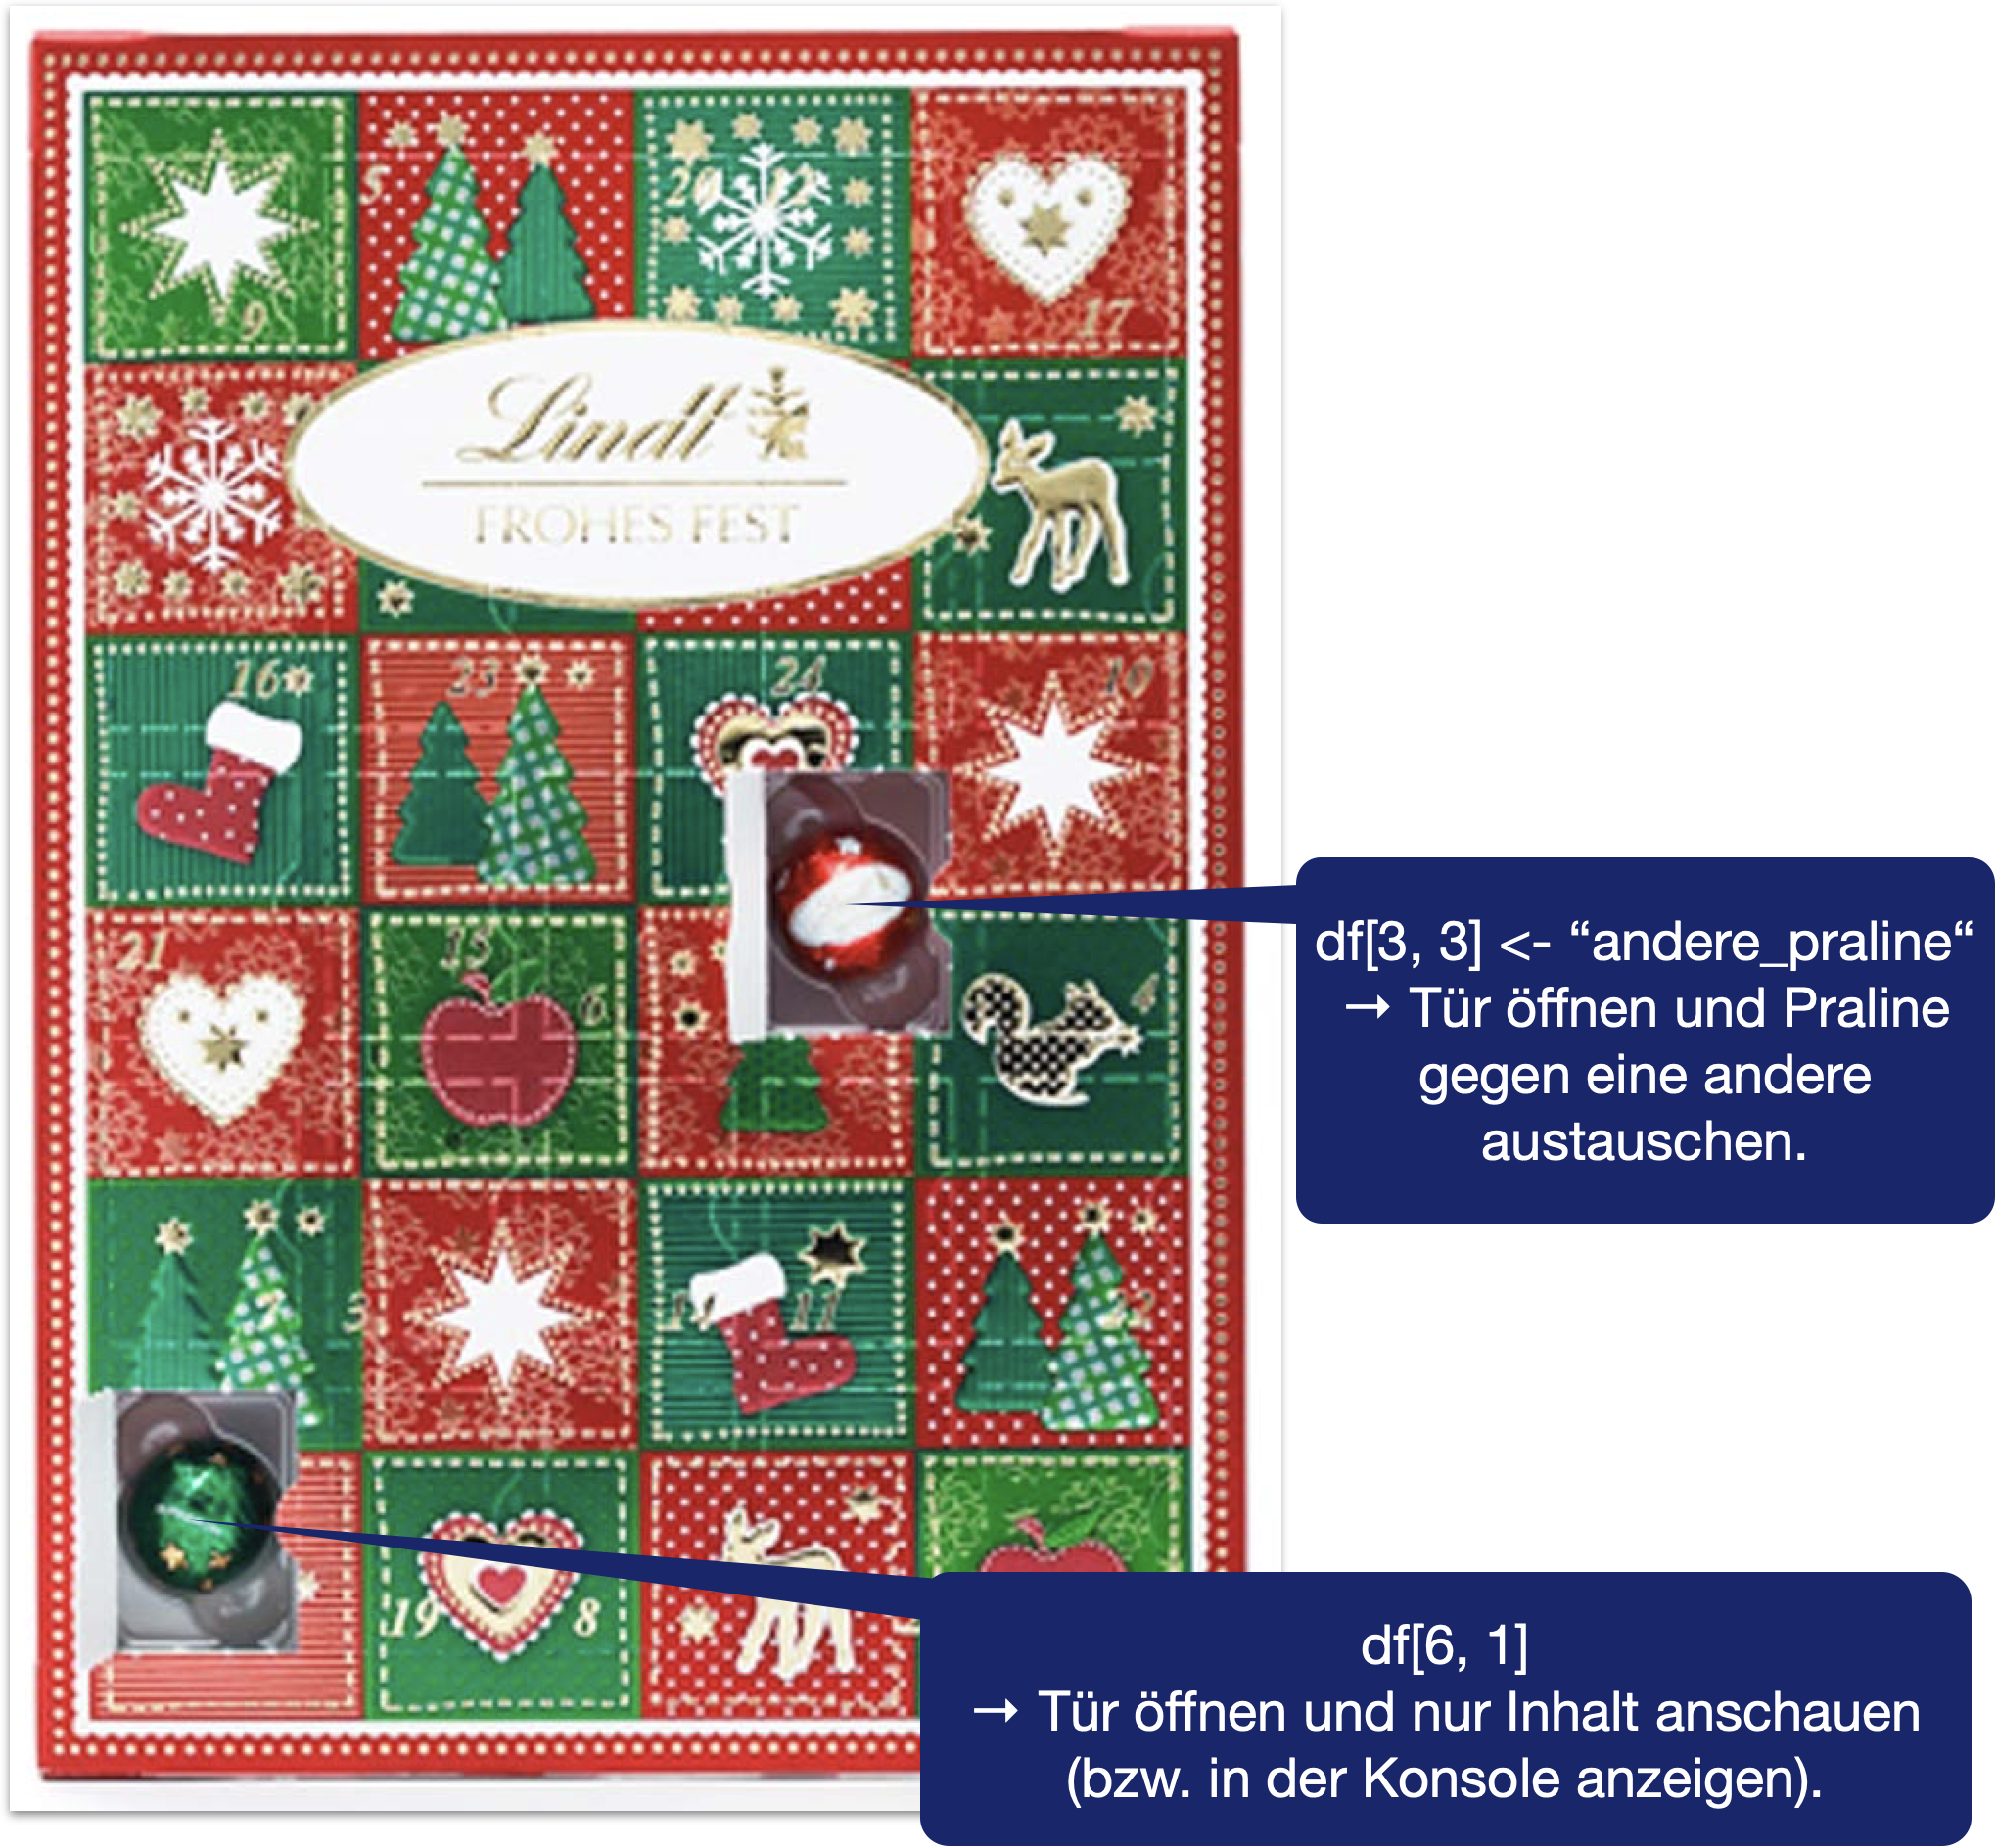

PlantGrowth - Objekttyp
Schauen Sie sich folgenden Datensatz an:
head(PlantGrowth, 3) weight group
1 4.17 ctrl
2 5.58 ctrl
3 5.18 ctrlPlantGrowth - Objektstruktur
Schauen Sie sich die Struktur vom PlantGrowth Datensatz an:
str(PlantGrowth)'data.frame': 30 obs. of 2 variables:
$ weight: num 4.17 5.58 5.18 6.11 4.5 4.61 5.17 4.53 5.33 5.14 ...
$ group : Factor w/ 3 levels "ctrl","trt1",..: 1 1 1 1 1 1 1 1 1 1 ...
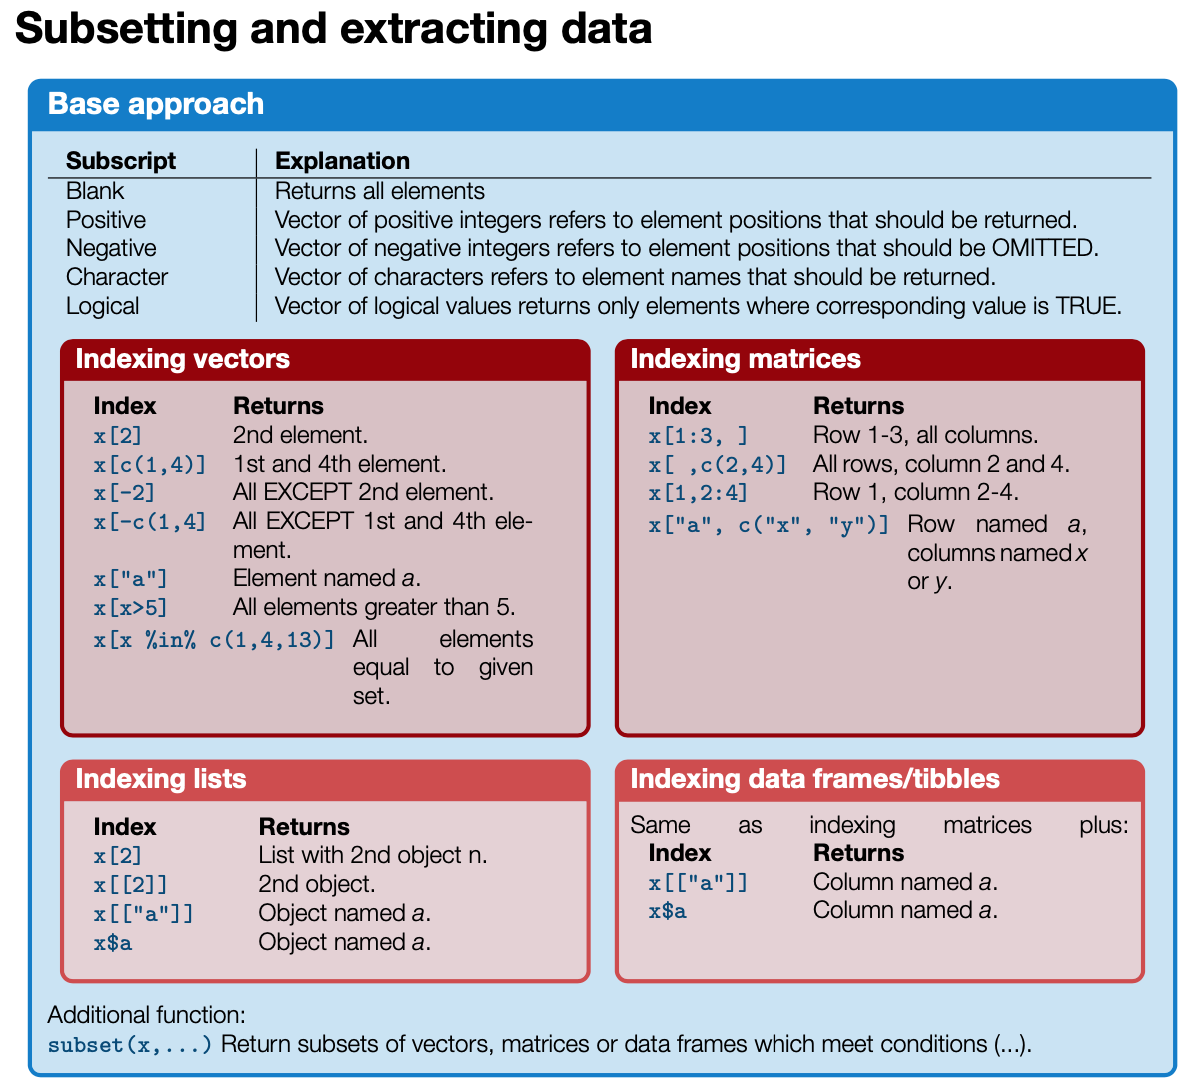
fang[2] gibt eine Liste mit einem Element zurück, fang[[2]] (oder fang$arten) dagegen den Inhalt – also den Vektor. fang[arten] sucht nach einem Objekt namens arten (Anführungszeichen fehlen!) und fang(2) würde fang als Funktion aufrufen.
fang[2]$arten
[1] "Hering" "Dorsch" "Sprotte"fang[[2]][1] "Hering" "Dorsch" "Sprotte"
Mit == wird für jede Zeile geprüft, ob in der Spalte group der Wert ‘ctrl’ steht. Das Komma trennt die Zeilenabfrage von der Spaltenauswahl – da danach nichts steht, werden alle Spalten ausgewählt.
PlantGrowth[PlantGrowth$group == 'ctrl', ] weight group
1 4.17 ctrl
2 5.58 ctrl
3 5.18 ctrl
4 6.11 ctrl
5 4.50 ctrl
6 4.61 ctrl
7 5.17 ctrl
8 4.53 ctrl
9 5.33 ctrl
10 5.14 ctrl
explore_var()Eine Variable explorieren
explore_var(x = iris$Petal.Length, xlab = "Kronblattlänge (cm)")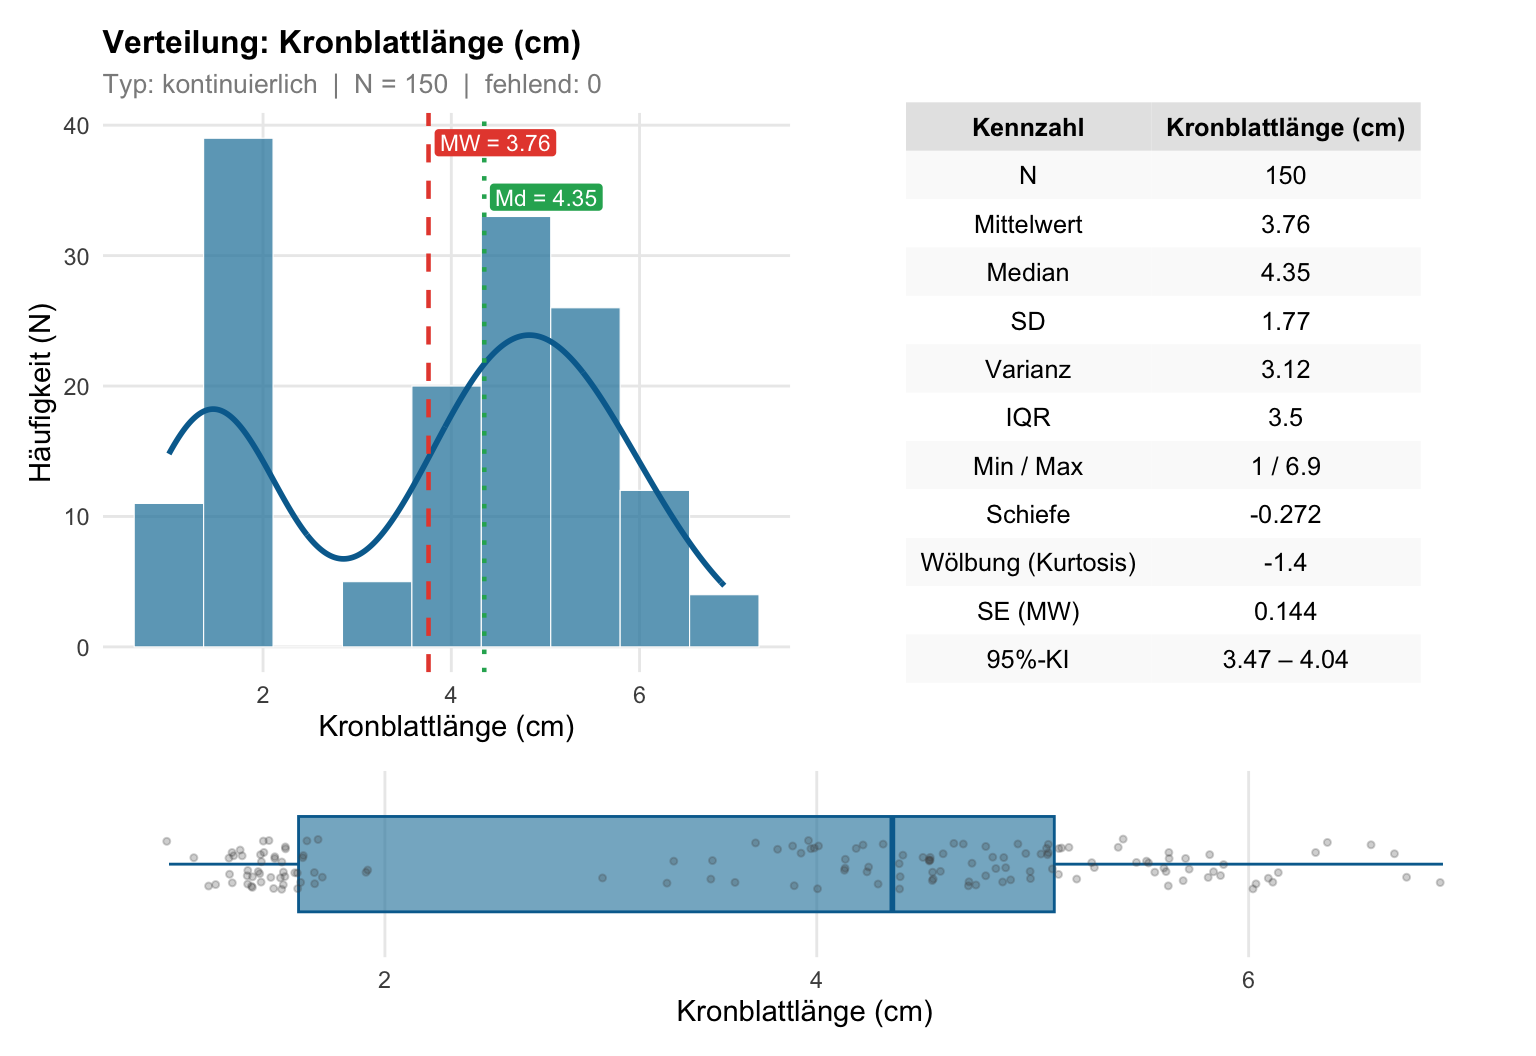
explore_var() erkennt den Typ einer Variable und erstellt passende Grafiken und eine Tabelle mit deskriptiven Statistiken.$ auswählen.
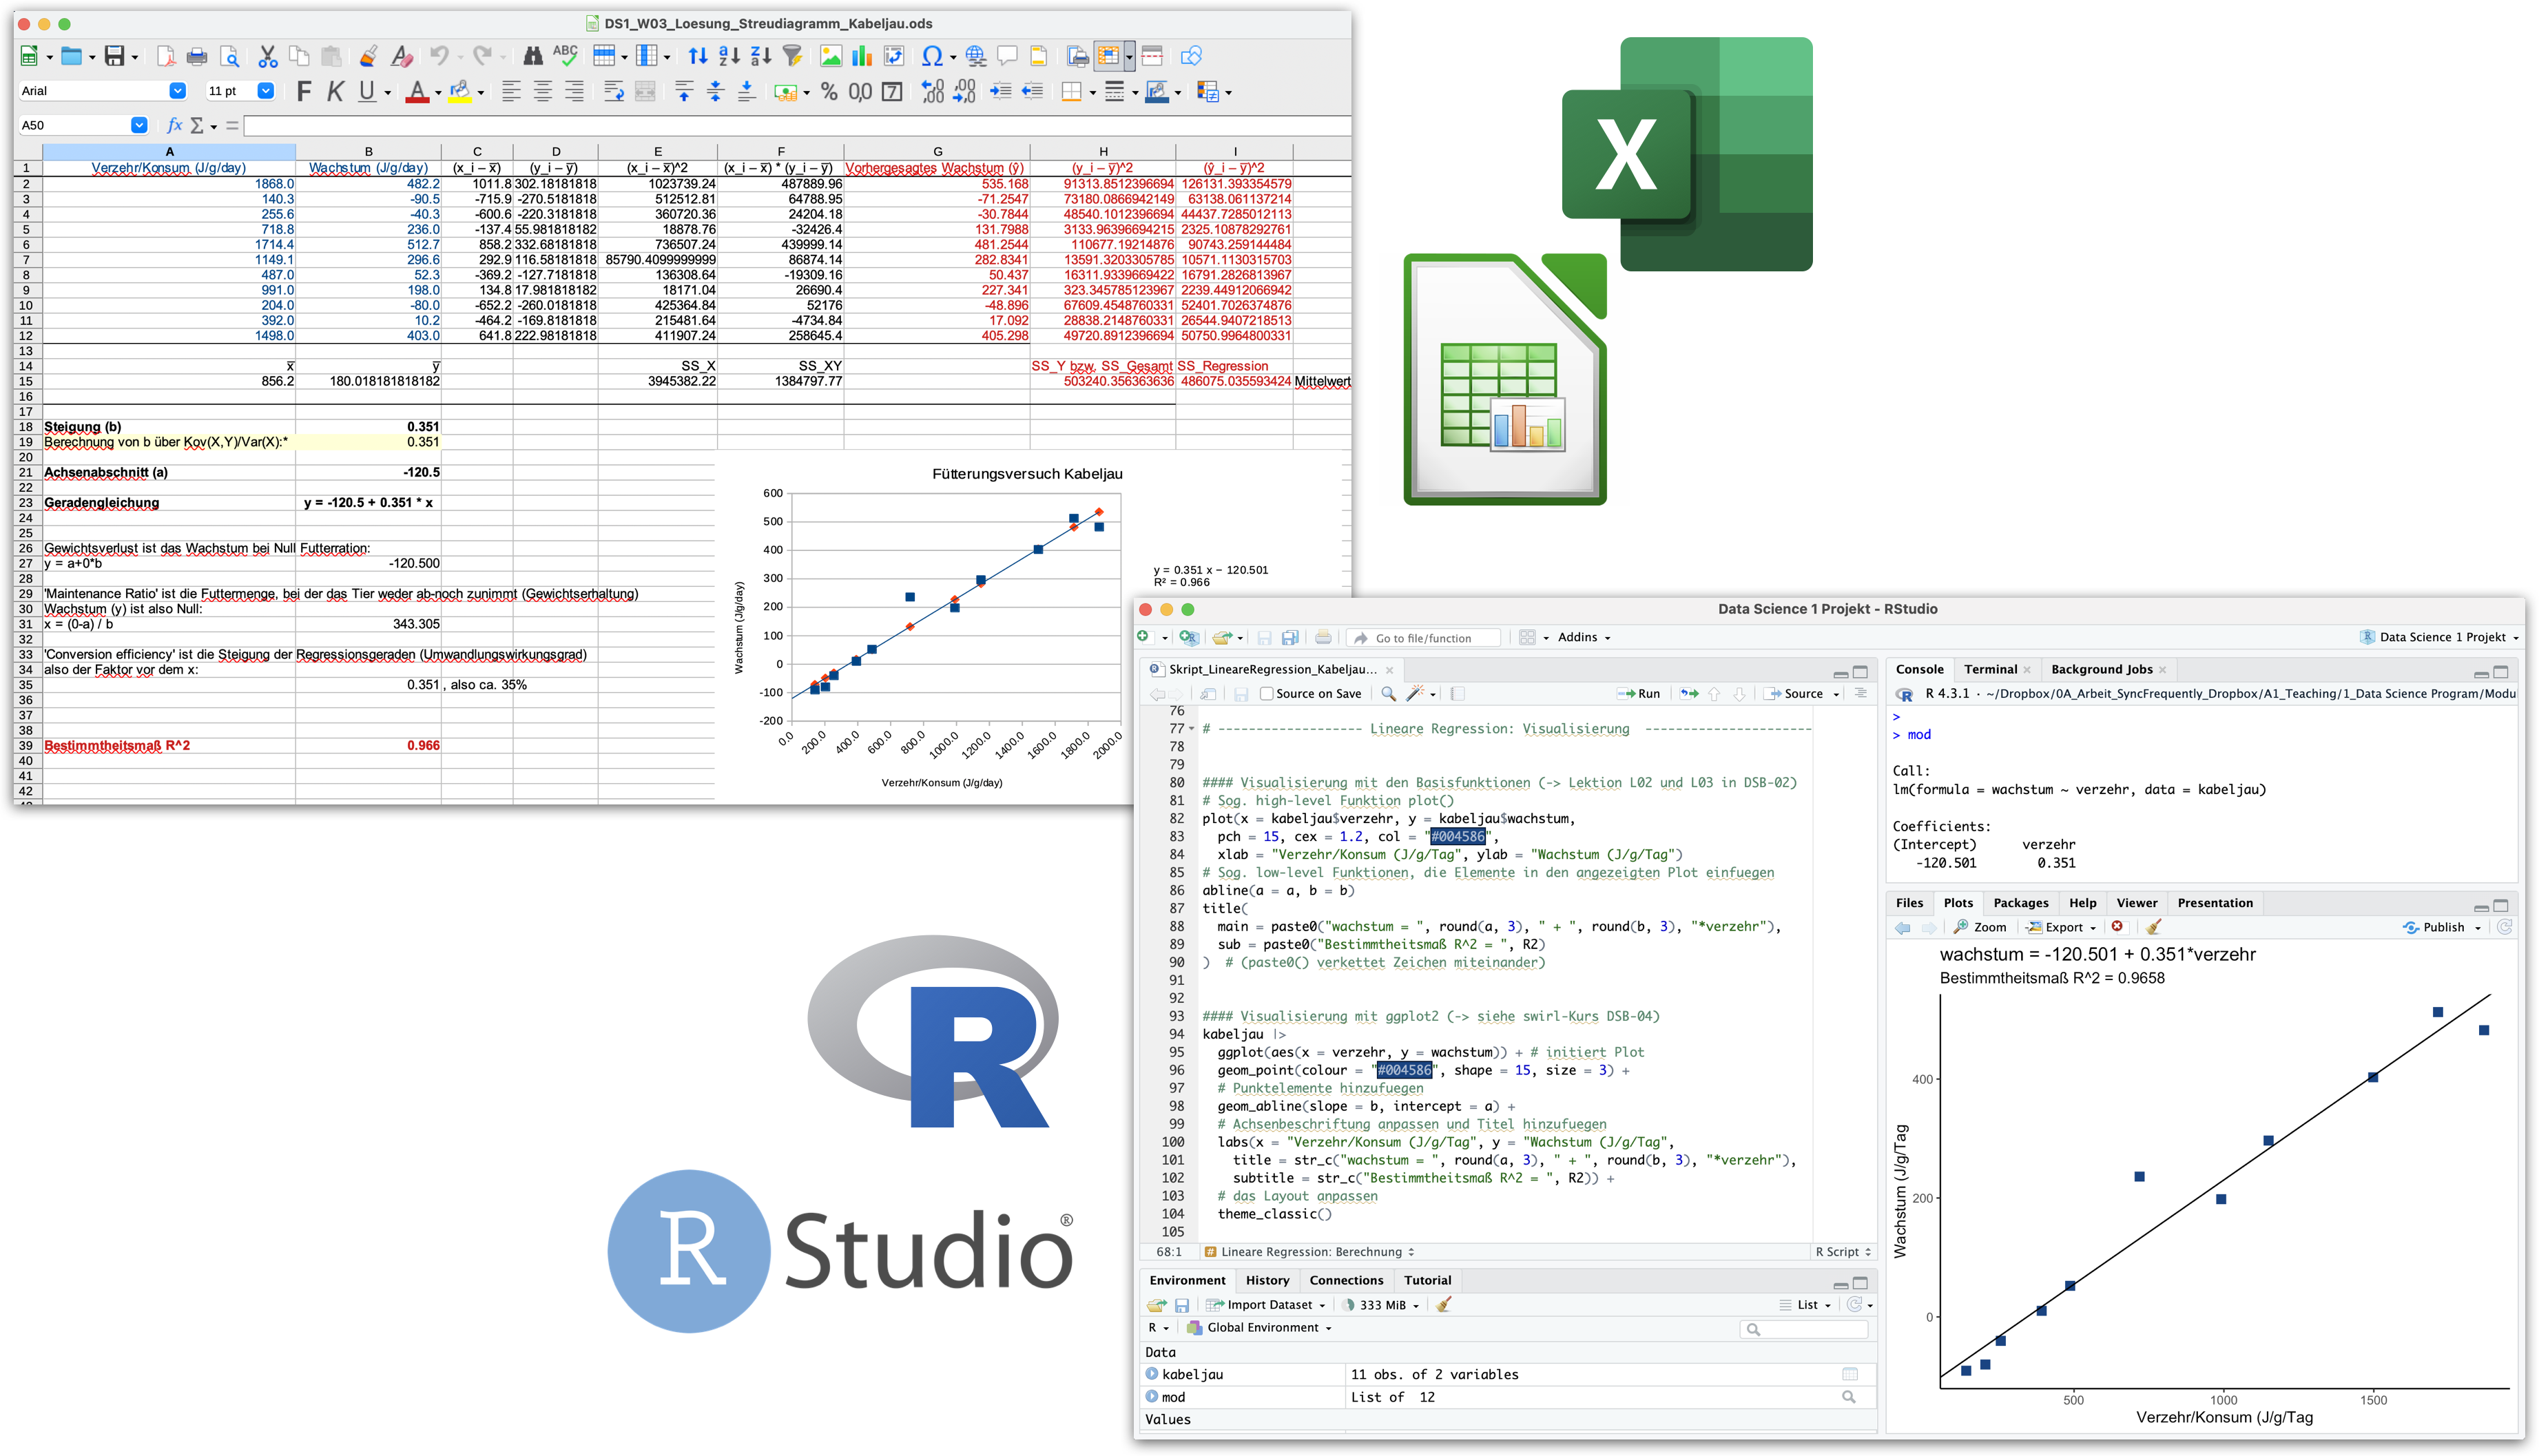
Die hervorgehobenen Funktionen kennen wir jetzt alle schon:
# ------------------------------ Vorbereitung ----------------------------------

#### Laden von Paketen
library(tidyverse)
# library(readODS)
# library(readxl)
library(DSBtools)
options(DSBtools.language = "de") # Ausgabe auf Deutsch


#### Eigene Funktionen


# -------------------- Import und Datenaufbereitung ----------------------------

#### Import einer Textdatei im CSV-Format (das gängigste Format)
kabeljau_csv <- read.csv(file = "data/Wachstum-Futter.csv")
str(kabeljau_csv) # --> Output ist ein data frame


#### Import von Calc- und Excel-Dateien (ODS- und XLSX-Format)

# Import einer ODS-Datei mit dem 'readODS' Paket
kabeljau <- readODS::read_ods("data/DS1_W03_Streudiagramm_Kabeljau.ods",
  sheet = "Daten_Visualisierung")
str(kabeljau) # --> Output ist ein Tibble

# Import einer XLSX-Datei mit z.B. dem 'readxl' Paket
kabeljau_xlsx <- readxl::read_excel("data/DS1_W03_Streudiagramm_Kabeljau.xlsx",
  sheet = "Daten_Visualisierung")
str(kabeljau_xlsx) # --> Output ist ein Tibble


#### Datensichtung und -transformation

# Anpassen der Spaltennamen
names(kabeljau) <- c("verzehr", "wachstum")
str(kabeljau)

# Wertebereich prüfen
summary(kabeljau)

# Beziehung explorieren: Ist sie linear? Gibt es Ausreisser?
explore_var(x = kabeljau$verzehr, y = kabeljau$wachstum,
  xlab = "Verzehr/Konsum (J/g/Tag)", ylab = "Wachstum (J/g/Tag)")


# ---------------------- Lineare Regression: Berechnung ------------------------
# (-> Lektion L03 in DSB-02-Datenexploration mit R)

#### Manuelle Berechnung

# Um Tipparbeit zu sparen, speichern wir die Spalten als einzelne Vektoren
x <- kabeljau$verzehr
y <- kabeljau$wachstum

# Steigungsparameter b berechnen
b <- cov(x = x, y = y)/ var(x) # der shortcut mit der Kovarianz und Varianz
b

# Achsenabschnitt a berechnen
a <- mean(y) - b*mean(x)
a

# Das Bestimmtheitsmass R^2 berechnen
y_pred <- a + b*x   # die vorhergesagten Werte
ss_gesamt <- sum( (y - mean(y))^2 ) # Summenquadrate Gesamt
ss_regression <- sum( (y_pred - mean(y))^2 ) # Summenquadrate der Regression
R2 <- round(ss_regression/ss_gesamt, 4)
R2


##### Zum Vergleich die Regression automatisch berechnen mit lm()

# Erstellung des Modells
mod <- lm(formula = wachstum ~ verzehr, data = kabeljau)
mod

# Ausgabe nur der beiden Koeffizienten
coef(mod)

# Ausgabe aller wichtigen Statistiken des Modells, inklusive von R^2
# (mehr dazu in Data Science 2)
summary(mod)


# ------------------- Lineare Regression: Visualisierung  ----------------------


#### Visualisierung mit den Basisfunktionen (-> Lektion L02 und L03 in DSB-02)
# Sog. high-level Funktion plot()
plot(x = kabeljau$verzehr, y = kabeljau$wachstum,
  pch = 15, cex = 1.2, col = "#004586",
  xlab = "Verzehr/Konsum (J/g/Tag)", ylab = "Wachstum (J/g/Tag)")
# Sog. low-level Funktionen, die Elemente in den angezeigten Plot einfügen
abline(a = a, b = b)
title(
  main = paste0("wachstum = ", round(a, 3), " + ", round(b, 3), "*verzehr"),
  sub = paste0("Bestimmtheitsmaß R^2 = ", R2)
)  # (paste0() verkettet Zeichen miteinander)


#### Visualisierung mit ggplot2 (-> siehe swirl-Kurs DSB-04)
kabeljau |>
  ggplot(aes(x = verzehr, y = wachstum)) + # initiert Plot
  geom_point(colour = "#004586", shape = 15, size = 3) +
  # Punktelemente hinzufügen
  geom_abline(slope = b, intercept = a) +
  # Achsenbeschriftung anpassen und Titel hinzufügen
  labs(x = "Verzehr/Konsum (J/g/Tag)", y = "Wachstum (J/g/Tag)",
    title = str_c("wachstum = ", round(a, 3), " + ", round(b, 3), "*verzehr"),
    subtitle = str_c("Bestimmtheitsmaß R^2 = ", R2)) +
  # das Layout anpassen
  theme_bw()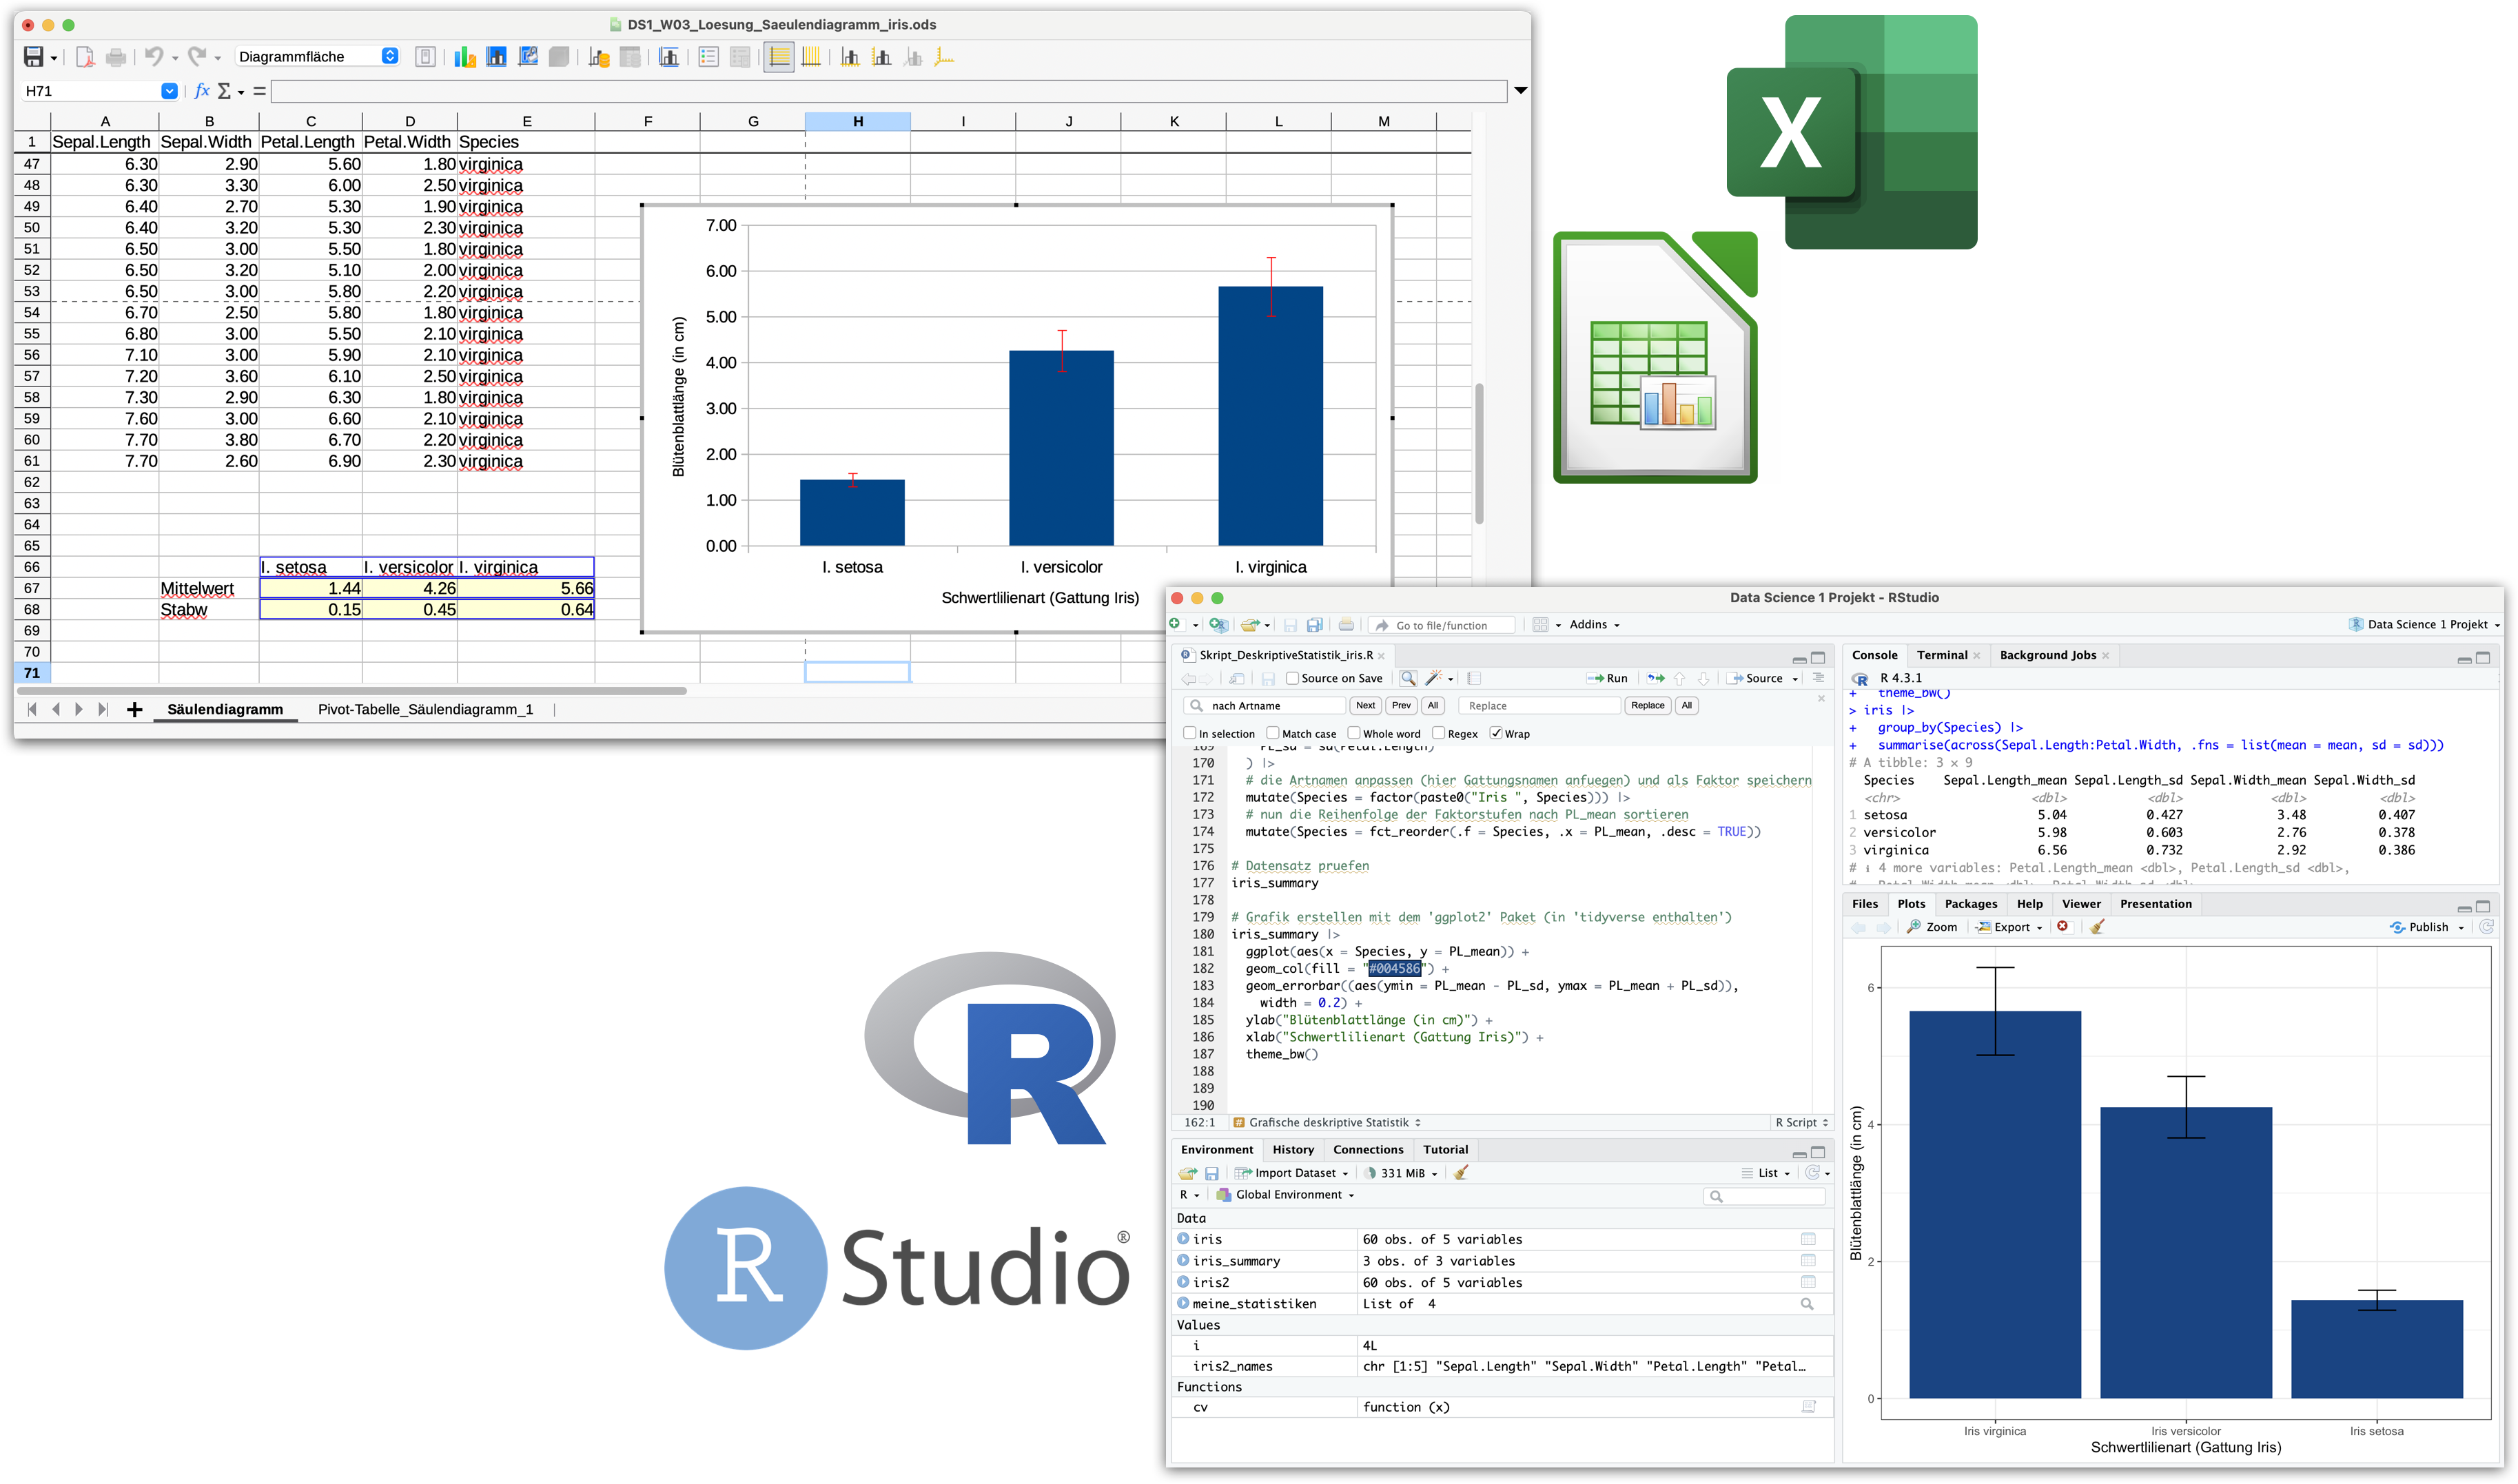
Die hervorgehobenen Funktionen kennen wir jetzt alle schon:
# ------------------------------ Vorbereitung ----------------------------------

#### Laden von Paketen
library(tidyverse) # laedt 9 Pakete

# # (das gleiche wie alle Pakete einzeln zu laden)
# library(dplyr)
# library(forcats)
# library(ggplot2)
# library(lubridate)
# library(purrr)
# library(readr)
# library(stringr)
# library(tibble)
# library(tidyr)

library(DSBtools)
options(DSBtools.language = "de") # Ausgabe auf Deutsch


#### Eigene Funktionen
# Variantionskoeffizient
cv <- function(x) {
  sd(x)/mean(x)
}


# -------------------- Import und Datenaufbereitung ----------------------------

#### Import von CSV-Dateien
# (-> Swirl-Lektion L01 in DSB-03-Datenaufbereitung oder per Anleitung durchs Tidyversum)

# Import der ODS-Datei, welche in den Zeilen 66-68 noch Text enthaelt
iris <- readODS::read_ods("data/DS1_W03_Saeulendiagramm_mit_iris.ods")


#### Prüfung des Imports und Datensichtung
# (-> Swirl-Lektion L02 in DSB-03)

# Prüfung des Datentyps --> IMMER DIREKT NACH DEM IMPORT VERWENDEN!
str(iris)  # str = structure

# Betrachtung des Inhalts
iris
# View(iris)

# Korrektur des Datentyps und der Zeilen
iris <- iris[1:60, ] |>
  mutate(across(Sepal.Length:Petal.Width, as.numeric)) |>
  mutate(Species = as.factor(Species))
str(iris)

# Welche Werte kommen in jeder Spalte vor?
lapply(iris, unique)

### Weitere Funktionen zur Sichtung einzelner Aspekte
head(iris) # zeigt erste 6 Zeilen (Kopfzeilen)
tail(iris) # zeigt letzte 6 Zeilen (Endzeilen)
class(iris) # Identifikation der Objektklasse (Vektor, Matrix, dataframe,..)
nrow(iris) # Anzahl Zeilen
ncol(iris) # Anzahl Spalten
dim(iris) # Anzahl aller Dimensionen
names(iris) # Spaltennamen
typeof(iris$Sepal.Length) # Datentyp von Spalte 'Sepal.Length'
typeof(iris$Species)      # Datentyp von Spalte 'Species'


# ----------------------- Deskriptive Statistik --------------------------------

#### Berechnung mehrerer Statistiken für jede Spalte im data frame

# Klassische Zusammenfassung mit base R (Ausgabe nur in der Konsole)
summary(iris)

# Shortcut mit DSBtools: Statistiken für jede Spalte, passend zum erkannten
# Variablentyp (z.B. Häufigkeiten bei 'Species', Mittelwert & Co. bei den
# metrischen Spalten). Das Ergebnis ist ein Objekt, mit dem Sie weiterarbeiten
# können - speichern Sie es dazu unter einem Namen:
describe_df(data = iris)


#### Berechnung versch. Statistiken der Kronblattlaenge, gruppiert nach Art
# (-> Lektion L01 in DSB-02-Datenexploration mit R)
# (-> Lektion L06-Gruppierte Aggregation in DSB-03)

iris_summary <- iris |>
  group_by(Species) |>
  summarise(
    PL_mean = mean(Petal.Length),                         # Mittelwert
    PL_median = median(Petal.Length),                     # Median
    PL_var = var(Petal.Length),                           # Varianz
    PL_sd = sd(Petal.Length),                             # Standardabweichung
    PL_se = sd(Petal.Length)/sqrt(length(Petal.Length)),  # Standardfehler
    PL_cv = cv(Petal.Length)                              # Variationskoeffizient
  ) |>
  # die Artnamen anpassen (hier Gattungsnamen anfügen) und als Faktor speichern
  mutate(Species = factor(paste0("Iris ", Species))) |>
  # nun die Reihenfolge der Faktorstufen nach PL_mean sortieren
  mutate(Species = fct_reorder(.f = Species, .x = PL_mean, .desc = TRUE))

# Zusammenfassung ansehen
iris_summary

# Kontrolle mit DSBtools: Stimmen Ihre Werte? describe_var() berechnet die
# Statistiken der Variable 'x' getrennt für jede Gruppe in 'by'
# (Angaben zum 95%-Konfidenzintervall -> kommt in Data Science 2)
iris_stats <- describe_var(x = iris$Petal.Length, by = iris$Species)
iris_stats


#### Saeulendiagramm erstellen mit dem 'ggplot2' Paket
#  (siehe auch swirl-Kurs DSB-04-Datenvisualisierung mit ggplot2)

iris_summary |>
  ggplot(aes(x = Species, y = PL_mean)) + # initiert Plot
  # die Saeulen hinzufügen
  geom_col(fill = "#004586") +
  # die Fehlerbalken hinzufügen
  geom_errorbar((aes(ymin = PL_mean - PL_sd, ymax = PL_mean + PL_sd)),
    width = 0.2) +
  # Achsenbeschriftung anpassen
  ylab("Kronblattlänge (in cm)") +
  xlab("Schwertlilienart (Gattung Iris)") +
  # das Layout anpassen
  theme_bw()

Alle Aufgaben der Übungswoche finden Sie im Handbuch:
… im swirl-Kurs werden Sie direkt an die Hand genommen und Stück für Stück angeleitet.
Siehe auch DSB Cheatsheet
R-Grundlagen und Data Wrangling
(auf Moodle oder DSB Website).
Siehe auch DSB Cheatsheet
R-Grundlagen und Data Wrangling
(auf Moodle oder DSB Website).
Dann machen Sie doch einfach die nächsten swirl Lektionen auch schon…
Bei weiteren Fragen: saskia.otto(at)uni-hamburg.de

Diese Arbeit ist lizenziert unter einer Creative Commons Attribution-ShareAlike 4.0 International License mit Ausnahme der entliehenen und mit Quellenangabe versehenen Abbildungen.