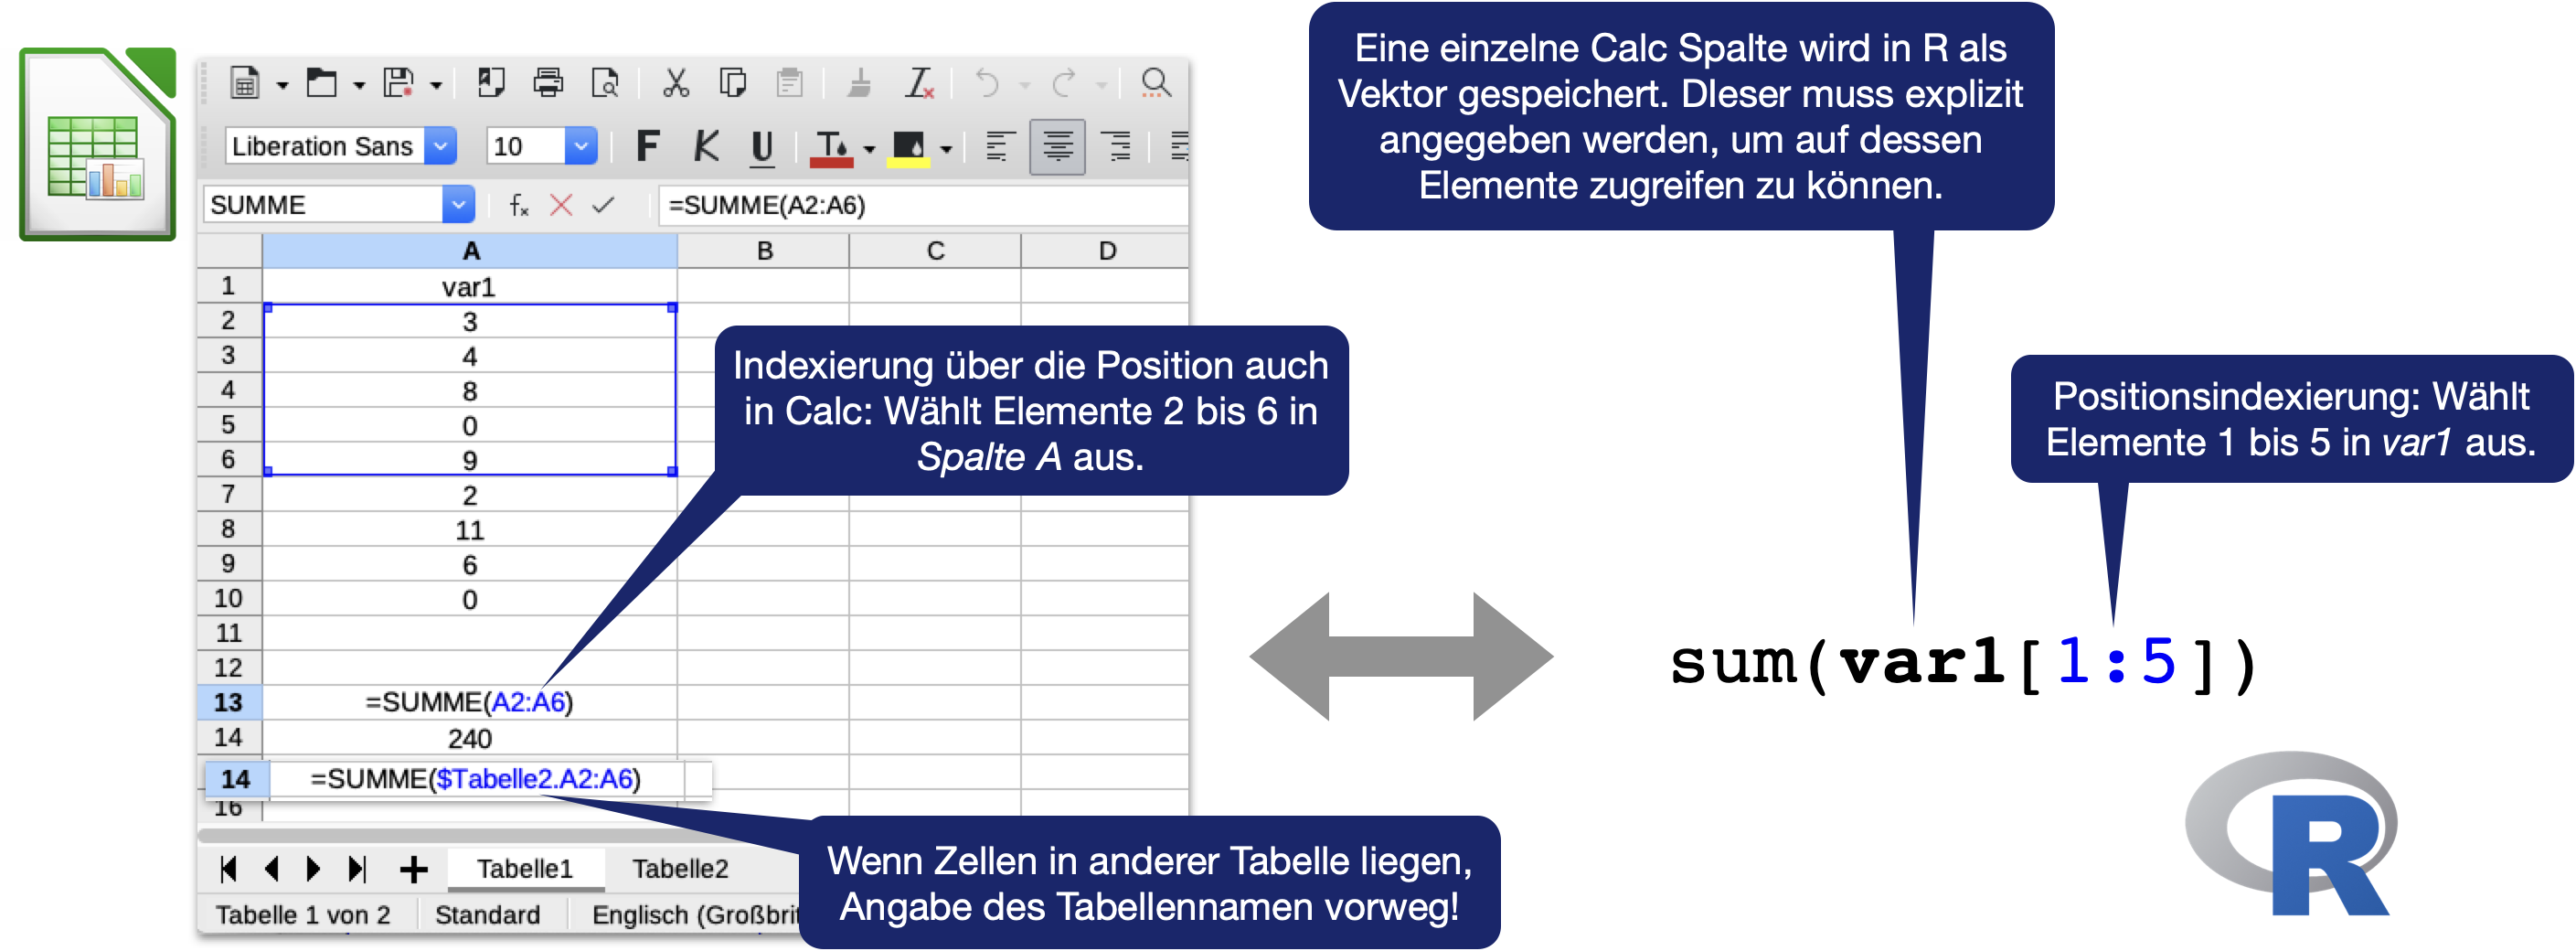
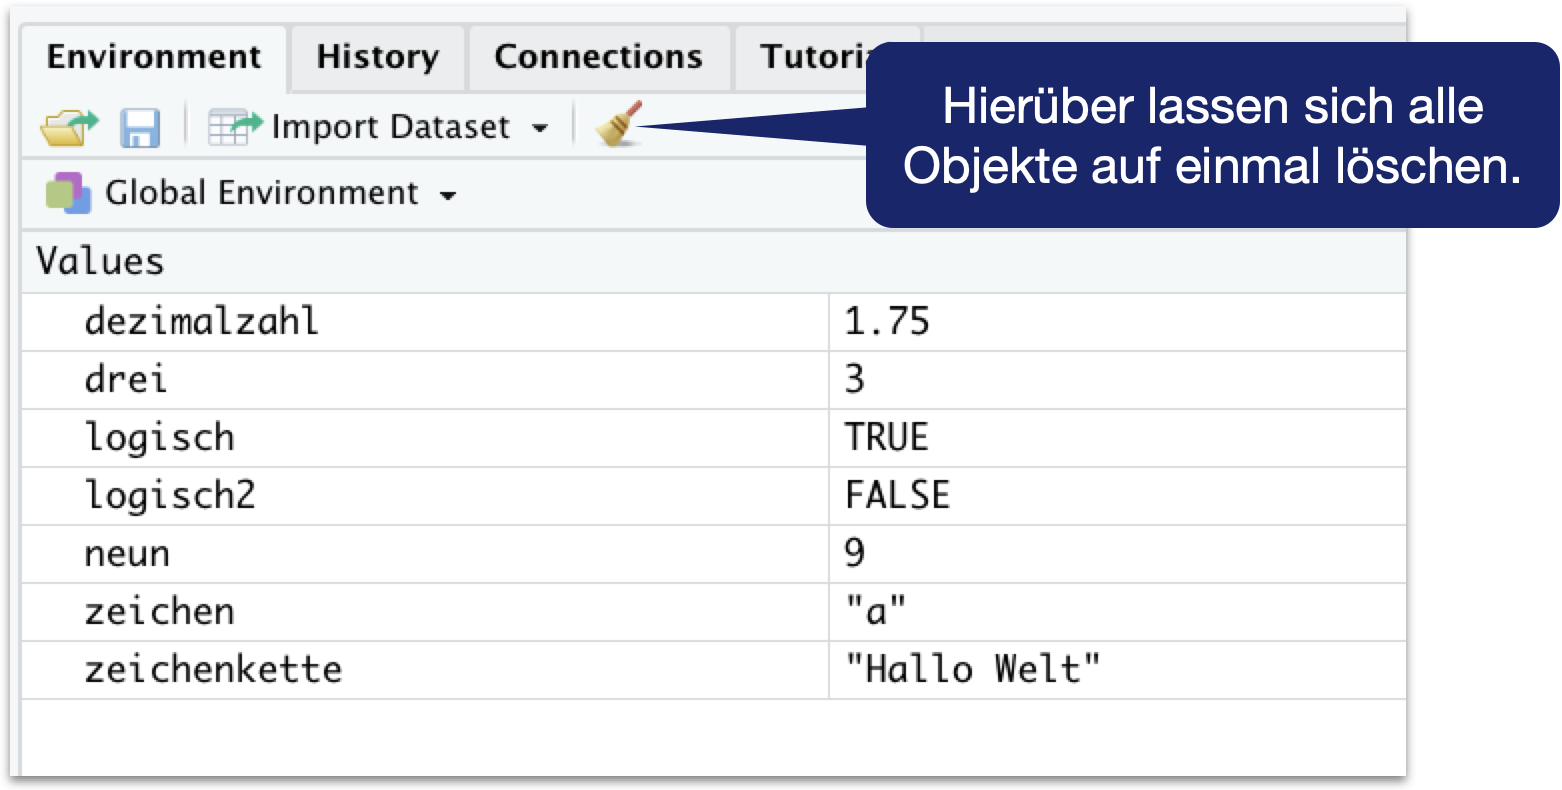
Speichern von Objekten verschiedenen Datentyps
neun <- 9
dezimalzahl <- 1.75
zeichen <- "a"
zeichenkette <- "Hallo Welt"
logisch <- TRUE
logisch2 <- FALSE
Data Science 1 - Programmieren & Visualisieren
Universität Hamburg, IMF
Wintersemester


Bevor auf my_value in Zeile 2 zugegriffen werden kann, muss das Objekt erst angelegt werden. Dies geschieht mit dem Zuweisungsoperator (<-).
Anschließend muss eine Funktion aufgerufen werden, die einen logischen Wert zurückgibt. Dies kann nur eine der is.xxx Funktionen sein. Welchen Datentyp könnte ‘A1’ haben?
my_value <- 'A1'
is.character(my_value)
[1] TRUE
Ein Vektor x enthält 20 verschiedene Elemente.
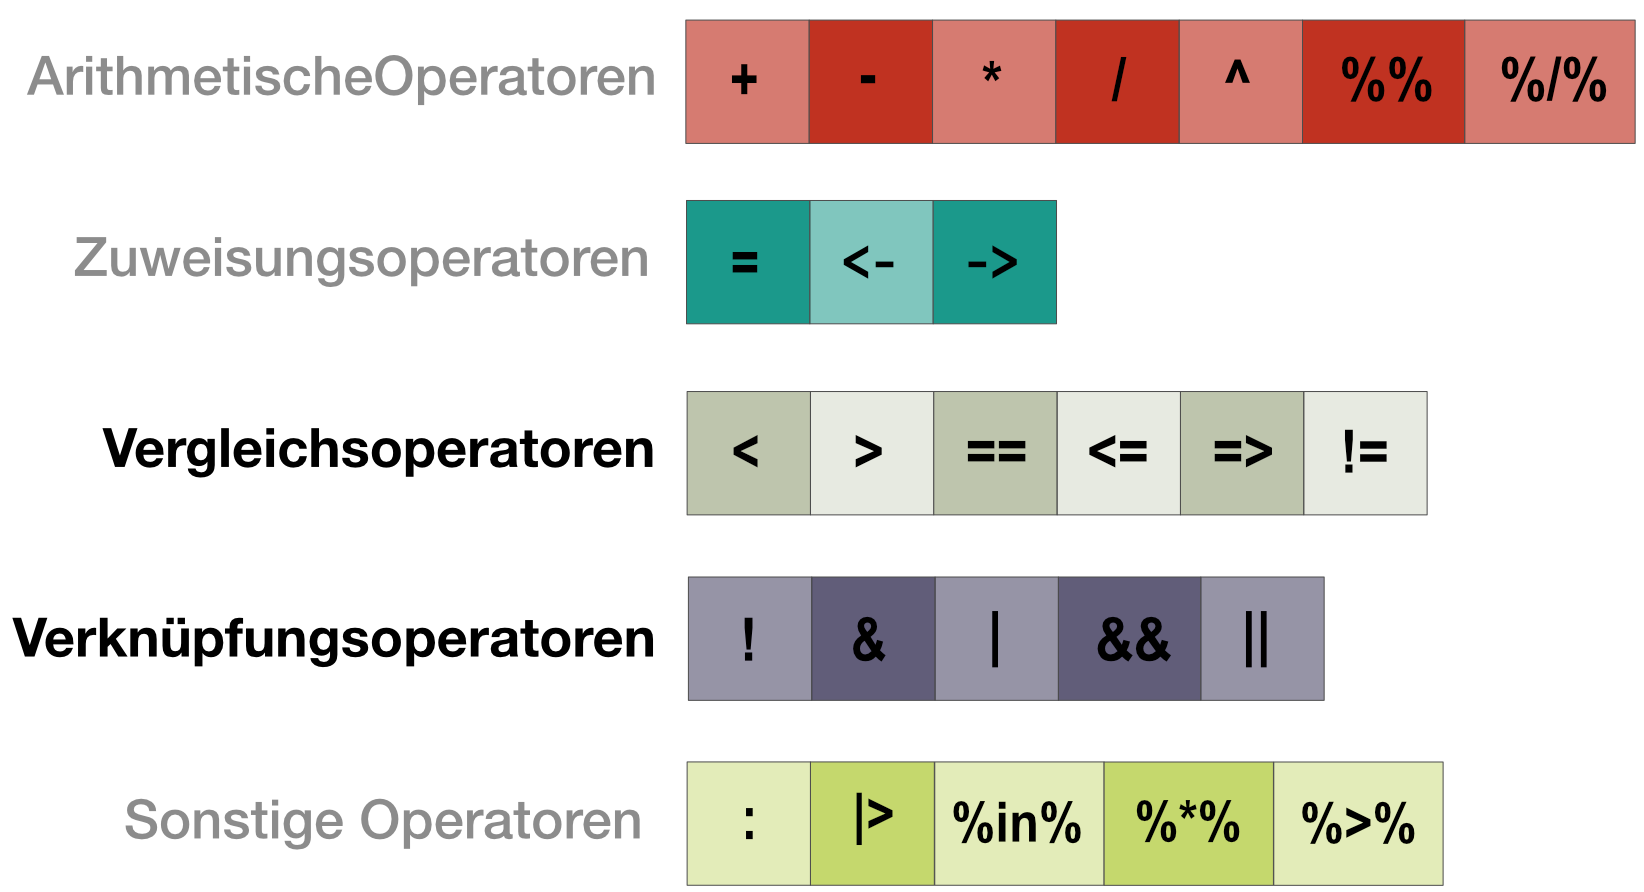
Vergleichs- und Verknüpfungsoperatoren geben immer einen logischen Wert (TRUE oder FALSE) zurück.
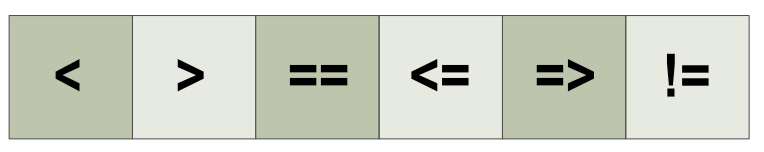
| Operator | Anwendung | Beschreibung |
|---|---|---|
| < | a < b | a ist KLEINER als b |
| > | a > b | a ist GRÖSSER als b |
| == | a == b | a ist GLEICH wie b |
| <= | a <= b | a ist KLEINER als oder GLEICH wie b |
| >= | a >= b | a ist GRÖSSER als oder GLEICH wie b |
| != | a != b | a ist NICHT GLEICH wie b |
| %in% | a %in% b | a ist ENTHALTEN IN b |
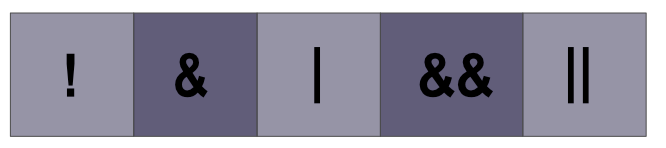
| Operator | Anwendung | Beschreibung |
|---|---|---|
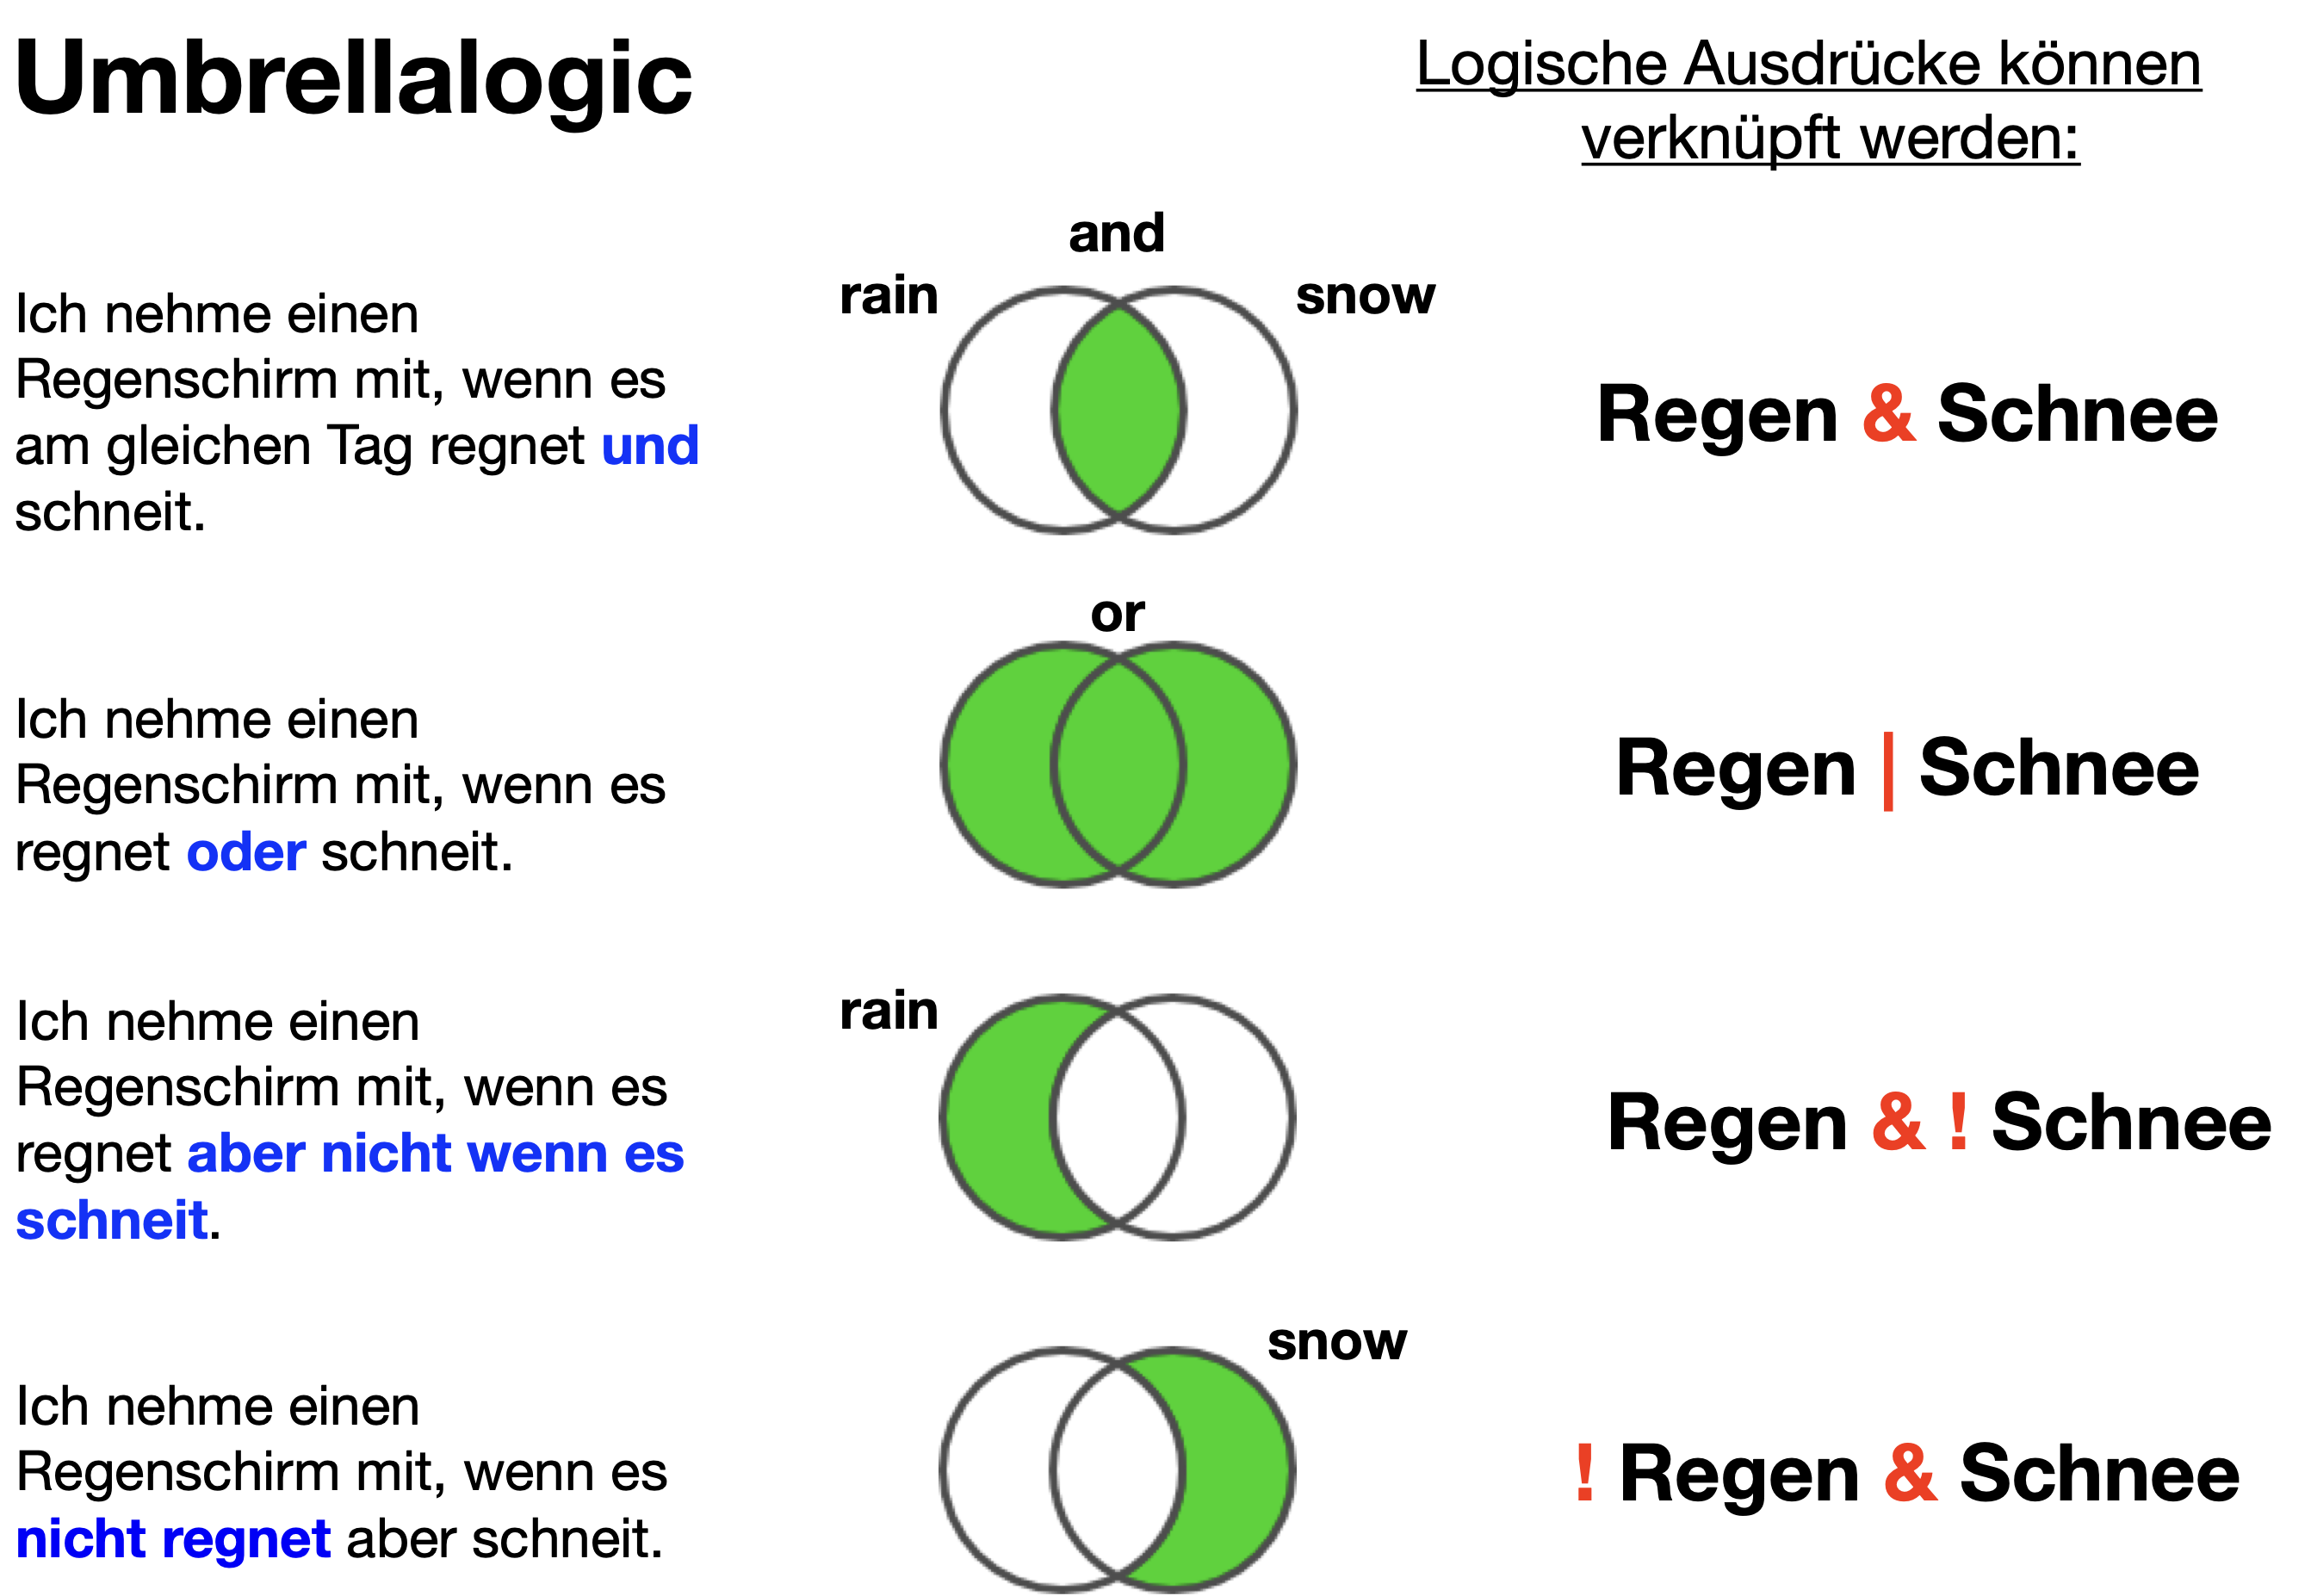
| & | a & b | Elementweise UND Operation (arbeiten mit Vektoren) |
| | | a | b | Elementweise ODER Operation (arbeiten mit Vektoren) |
| ! | !a | Elementweise NICHT Operation (arbeiten mit Vektoren) |
Gegeben ist eine Messreihe der Spinnendichte (\(no./m^2\)) auf verschiedenen Inseln im Golf von Kalifornien aus dem Jahre 1992 (aus Studie von Polis et al., 1998).
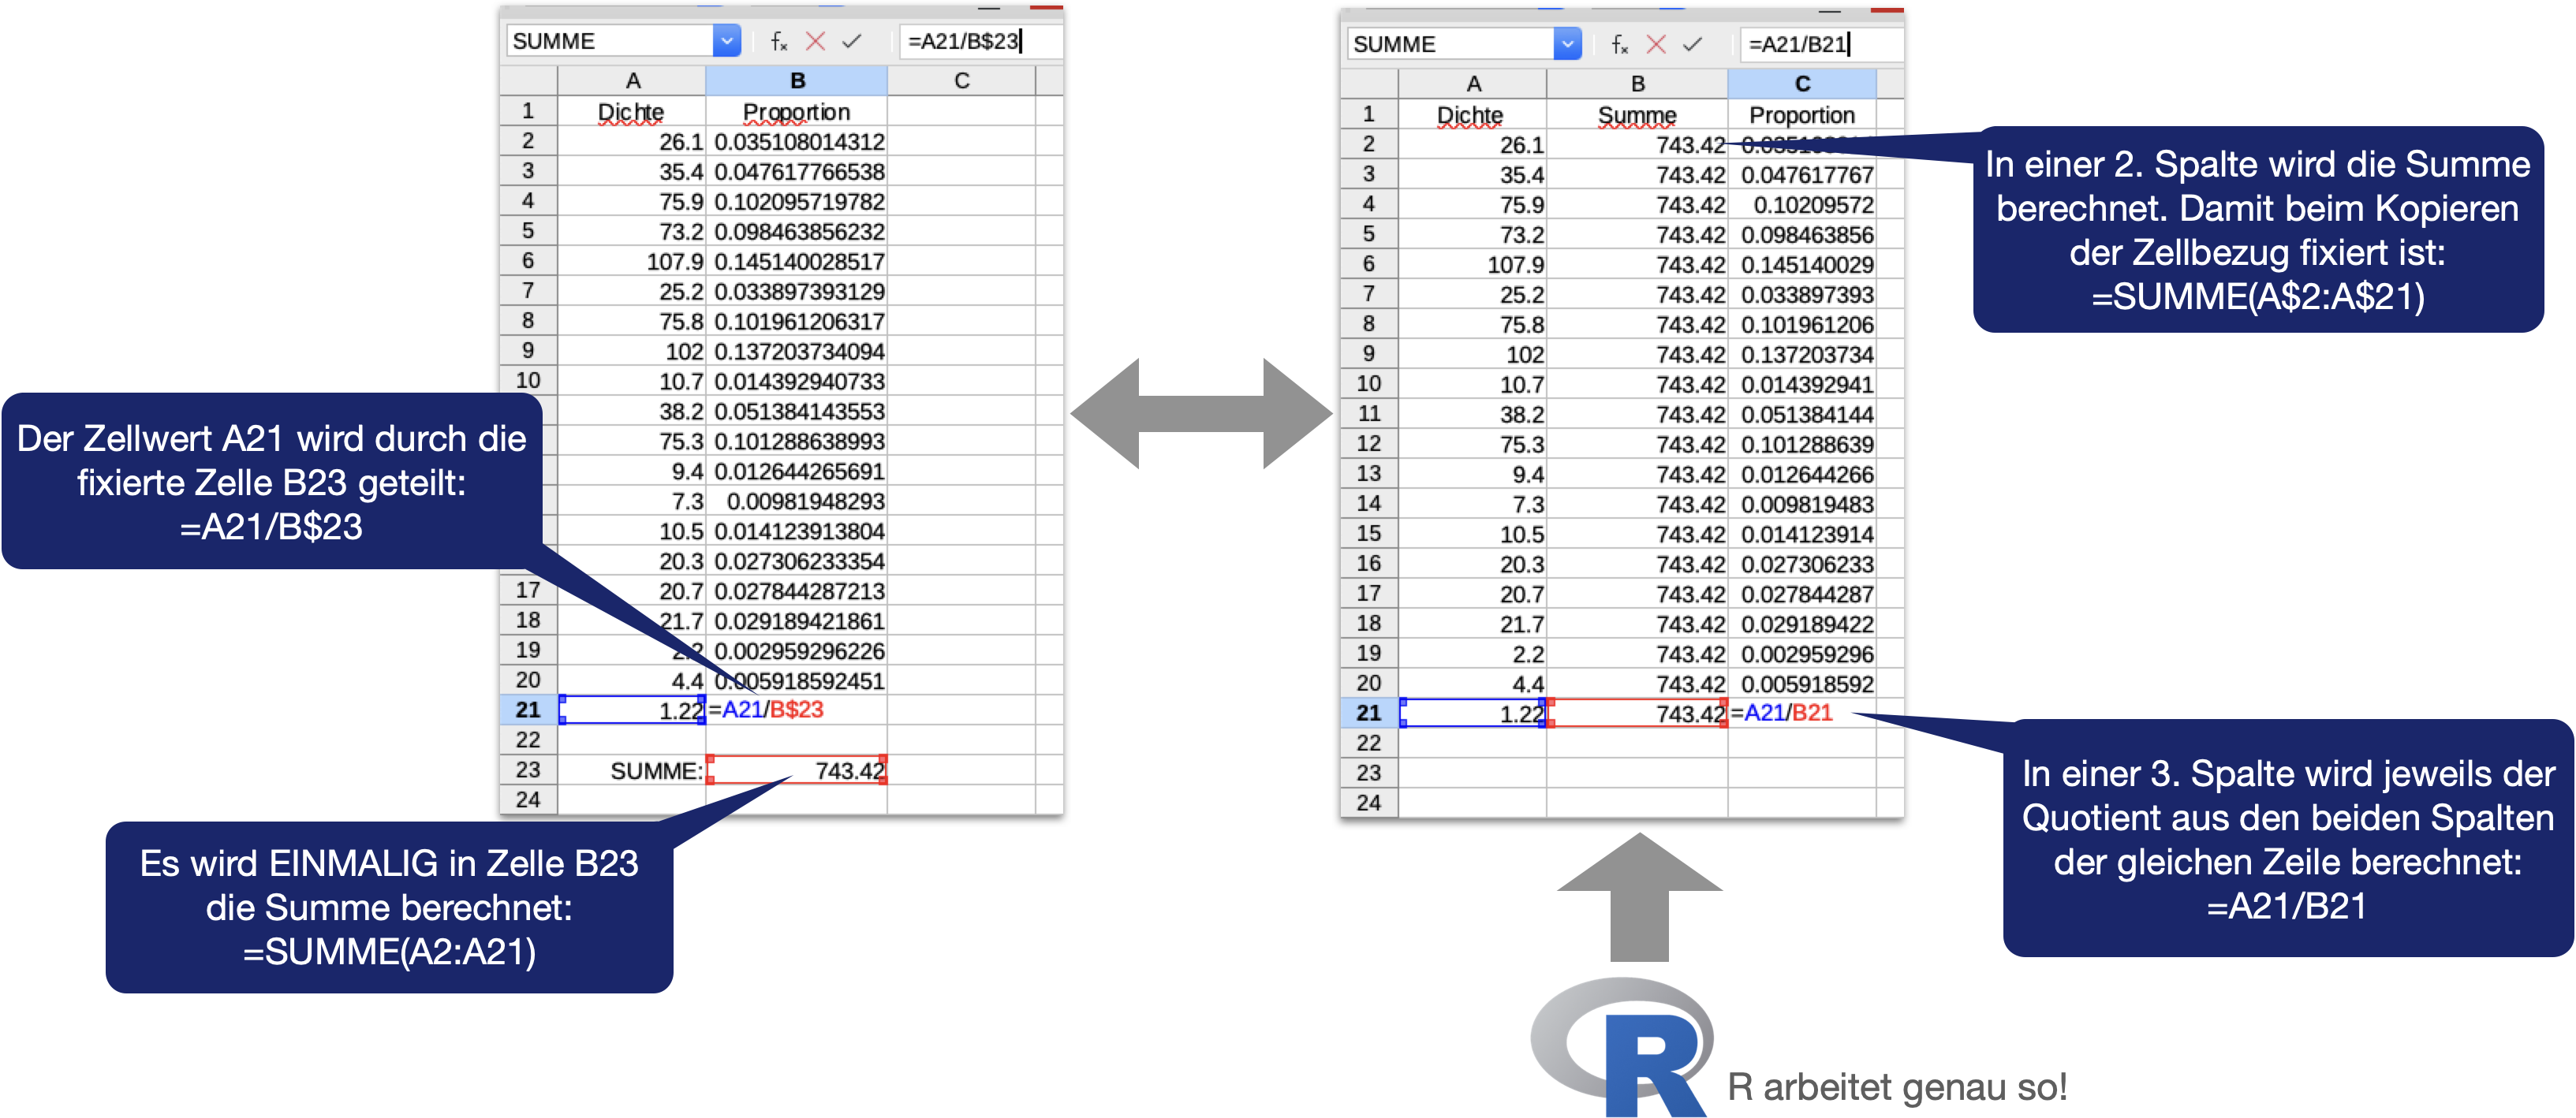
Nun soll der proportionale Anteil der Dichte pro Insel berechnet werden: \(p_i=\frac{d_i}{\sum(d_i)}\)

… im swirl-Kurs werden Sie direkt an die Hand genommen und Stück für Stück angeleitet.
Dann testen Sie doch Ihr Wissen in folgendem Abschlussquiz…

Das Objekt n in der letzten Operation wurde vorher nicht definiert. Daher muss sich die vorherige Zuweisung auf dieses Objekt beziehen. Auch y wurde vorher nicht definiert, daher kann es sich beim ‘Kleiner’-Zeichen in der letzten Zeile nicht um einen Vergleichsoperator handeln, sondern muss der erste Teil des Zuweisungsoperators sein.
a <- 20
n <- 4
y <- n * a + 110Eine Zeichenkette (in diesem Fall ‘a’) hat keine korrespondierende Zahl, in die sie umgewandelt werden kann. Dagegen kann eine Zahl einfach in eine Zeichenkette umgewandelt werden.
‘<0.5’ ist keine Zahl und kann daher nicht umgewandelt werden - dieses Element wird zu NA, alle anderen werden korrekt umgewandelt. R gibt dabei eine Warnung aus (‘NAs introduced by coercion’). Solche Einträge (z.B. Werte unter der Nachweisgrenze) sind in Messdaten häufig und müssen bewusst behandelt werden.
temp <- c('12.1', '13.4', '<0.5', '11.9')
as.numeric(temp)
Warning: NAs introduced by coercion[1] 12.1 13.4 NA 11.9Alle TRUEs werden zu 1 umgewandelt und alle FALSEs zu 0. Summiere einfach den Vektor mit der sum() Funktion: sum(x)
Wie könnten alle NAs in einem Vektor x mit sehr vielen Elementen schnell ermittelt werden?
Zuerst wird mit der is.na() Funktion bei jedem Element abgefragt, ob es sich um ein NA handelt oder nicht.
Anschließend kann mit dem zurückgegebenen logischen Vektor die Summe aller TRUEs berechnet werden - denn R wandelt bei mathematischen Operationen von logischen Werten alle FALSEs in eine 0 um und alle TRUEs in eine 1!
x <- c(3,0,1,8,0,NA,8,0,4,NA,5,1,NA,7,7,9,2,1,NA,5,1,NA,0)
is.na(x)
[1] FALSE FALSE FALSE FALSE FALSE TRUE FALSE FALSE FALSE TRUE FALSE FALSE
[13] TRUE FALSE FALSE FALSE FALSE FALSE TRUE FALSE FALSE TRUE FALSEsum(is.na(x))[1] 5Ein Vektor x enthält 20 verschiedene Elemente.
Ein Vektor x enthält 20 verschiedene Elemente.
Ein Vektor vec enthält mehrere Zahlen.
Wir nutzen dazu den Modulo-Operator, welcher eine Restwert-Division zweier Elemente ausführt. Bei der Restwert-Division von 43 (Dividend) durch 5 (Divisor) wird z.B. gefragt, wie man die Zahl 43 als Vielfaches von 5 und einem kleinen Rest darstellen kann: \(43=5*c+r\) In diesem Beispiel wäre die 8 der sog. Ganzzahlquotient c und die 3 der Restwert r.
Ein Rest ungleich 0 ergibt sich folglich genau dann, wenn der Dividend kein Vielfaches des Divisors ist. Man sagt auch: Der Dividend ist nicht durch den Divisor teilbar, weshalb ein Rest übrigbleibt.
Dies können wir uns zunutze machen, indem wir als Divisor die 2 nehmen. Wenn kein Restbetrag übrig bleibt, muss der Dividend gerade sein!
Ein Vektor vec enthält mehrere Zahlen.
Ein numerischer Vektor nvec enthält eine unbekannte Anzahl an Elementen.
%in%%in% prüft für jedes Element in arten, ob es in c('Kabeljau', 'Scholle') enthalten ist, und gibt einen logischen Vektor zurück. Mit == würde R die beiden Vektoren dagegen elementweise (und mit Recycling!) vergleichen - das liefert hier ein falsches Ergebnis.
arten <- c('Hering', 'Kabeljau', 'Sprotte', 'Scholle', 'Hering')
arten %in% c('Kabeljau', 'Scholle')
[1] FALSE TRUE FALSE TRUE FALSEarten[arten %in% c('Kabeljau', 'Scholle')][1] "Kabeljau" "Scholle" # Zum Vergleich - falsch:
arten[arten == c('Kabeljau', 'Scholle')]Warning in arten == c("Kabeljau", "Scholle"): longer object length is not a
multiple of shorter object length[1] "Scholle"Zur Erinnerung die Formel der Varianz: \(s^{2} = \frac{\sum\limits_{i=1}^{n} \left(x_{i} - \bar{x}\right)^{2}} {n-1}\)
df im Quiz steht für ‘degrees of freedom’, was im Deutschen die Freiheitsgrade sind. Und die betragen bei der Varianz n-1 (die Stichprobengröße oder Länge des Vektors minus 1).
Bei der Teilanweisung x-mean_x wird der eine Wert in mean_x auf die Länge von x recycelt. Anschließend wird der Wert in mean_x vom 1. Wert in x abgezogen, dann vom 2. Wert, etc.
Das Ergebnis ist ein Vektor der gleichen Länge wie x mit den Differenzen, die anschließend quadriert und aufsummiert werden.
[1] 1268.611# Oder die Verwendung der built-in Funktion var()
var(x)[1] 1268.611
Bei weiteren Fragen: saskia.otto(at)uni-hamburg.de

Diese Arbeit ist lizenziert unter einer Creative Commons Attribution-ShareAlike 4.0 International License mit Ausnahme der entliehenen und mit Quellenangabe versehenen Abbildungen.